Deskripsi
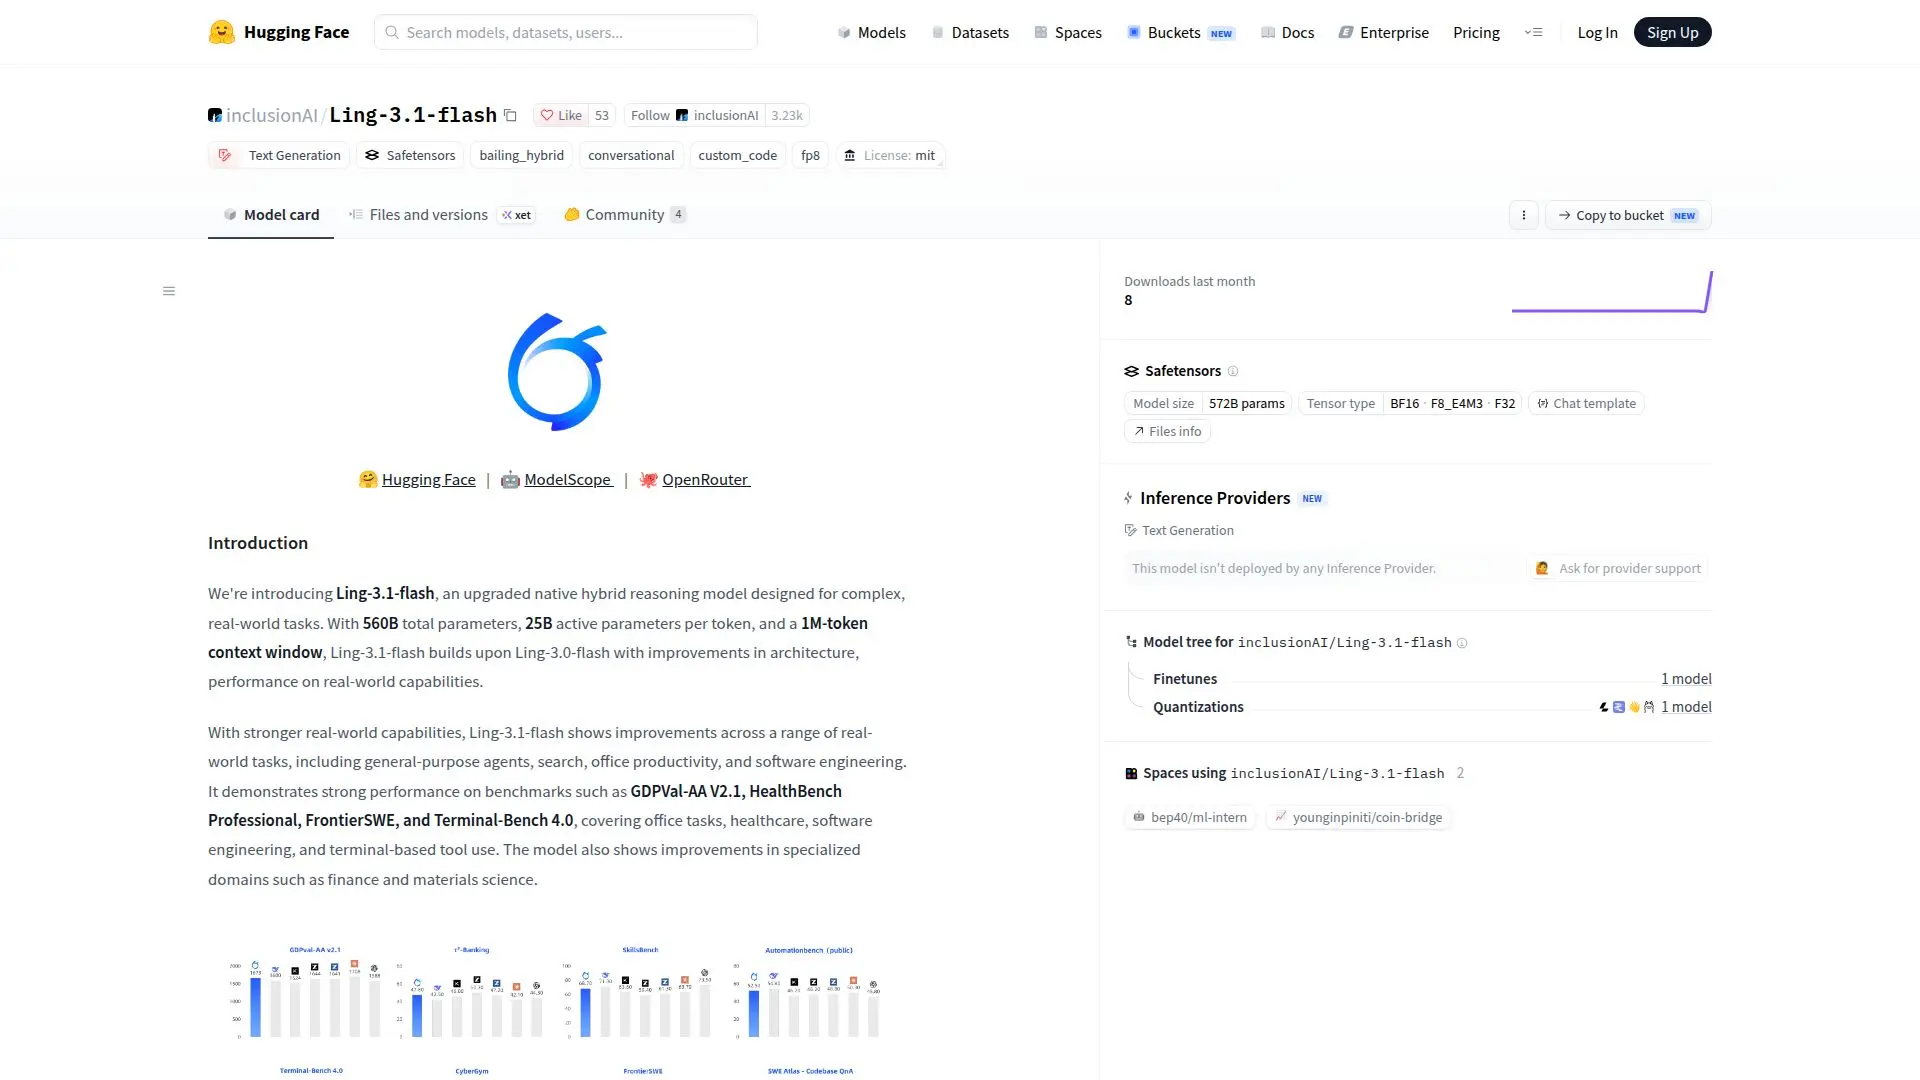
Ling-3.1-flash adalah model penalaran hibrida asli yang ditingkatkan yang diperkenalkan oleh inclusionAI di platform Hugging Face. Dirancang untuk menangani tugas-tugas kompleks di dunia nyata, model ini memiliki total 560 miliar parameter, dengan 25 miliar parameter aktif per token dan jendela konteks 1 juta token. Peningkatan ini dibangun di atas pendahulunya, Ling-3.0-flash, menawarkan arsitektur dan kinerja yang lebih baik.
Baca Selengkapnya
Model ini unggul dalam berbagai aplikasi dunia nyata, seperti agen tujuan umum, pencarian, produktivitas kantor, dan rekayasa perangkat lunak. Model ini telah menunjukkan kinerja yang kuat pada tolok ukur seperti GDPVal-AA V2.1, HealthBench Professional, FrontierSWE, dan Terminal-Bench 4.0. Tolok ukur ini mencakup berbagai tugas, termasuk tugas kantor, kesehatan, rekayasa perangkat lunak, dan penggunaan alat berbasis terminal. Selain itu, Ling-3.1-flash menunjukkan peningkatan yang signifikan di domain khusus seperti keuangan dan ilmu material.
Arsitektur Ling-3.1-flash didasarkan pada model campuran hibrida-linier dari para ahli (MoE), dengan 63 KDA dan 9 lapisan MLA berpintu, 4 lapisan padat, dan 512 ahli yang diarahkan. Model ini juga mencakup 64 kepala perhatian dan ukuran tersembunyi 4096, dengan ukuran kosakata 157.184.
Ling-3.1-flash telah dievaluasi di berbagai tolok ukur otoritatif, menunjukkan kinerja yang kuat dalam tugas pemrograman dan agen. Model ini mendukung kerangka kerja seperti Claude Code, Kilo Code, Qwen Code, Hermes Agent, dan OpenClaw. Model ini juga memperkenalkan LingCode, sebuah alat yang dibangun di atas agen pemrograman sumber terbuka Pi, yang meningkatkan kinerja pada tugas pemrograman kompleks dan jangka panjang.
Bagi pengguna yang ingin memulai, gambar SGLang yang direkomendasikan mencakup dukungan Ling-3.1-flash, dekode spekulatif MTP, dan optimasi dekode Hopper. Model ini tersedia untuk inferensi di berbagai konfigurasi server, dan resep yang diverifikasi disediakan untuk berbagai pengaturan perangkat keras.
- KategoriModel AI & LLM
- Model HargaOpen source
- PenerapanCloud
- PlatformWeb
Sorotan Ling-3.1-flash
560B total parameter
1M-token jendela konteks
Arsitektur MoE hibrida-linier
63 KDA + 9 lapisan MLA berpintu
512 ahli yang diarahkan
64 kepala perhatian
Mendukung berbagai kerangka kerja
Kinerja tolok ukur yang kuat
Memulai dengan Ling-3.1-flash
Akses halaman model: Kunjungi Hugging Face
Autentikasi: Masuk ke akun Anda
Konfigurasi: Siapkan lingkungan server atau klien
Kirim prompt: Gunakan resep yang diverifikasi untuk inferensi
Kasus Penggunaan Ling-3.1-flash
- Agen tujuan umum
- Produktivitas kantor
- Rekayasa perangkat lunak
- Aplikasi kesehatan
- Analisis keuangan