Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

d1-2B

LLMModel AI & LLMOpen source · Web

d1-2B adalah model keputusan yang dibangun di atas LFM3-VL-2B, dirancang untuk analisis teks, gambar, dan video. Model ini memberikan jawaban yang terkalibrasi dalam satu kali proses maju tanpa menghasilkan token. Model ini unggul dalam berbagai tolok ukur keputusan, menawarkan kemampuan di luar klasifikasi, termasuk ekstraksi teks, lokasi objek, dan estimasi kuantitas. Ini dioptimalkan untuk pengambilan keputusan yang cepat dalam berbagai aplikasi.

Kunjungi URL
Bagikan
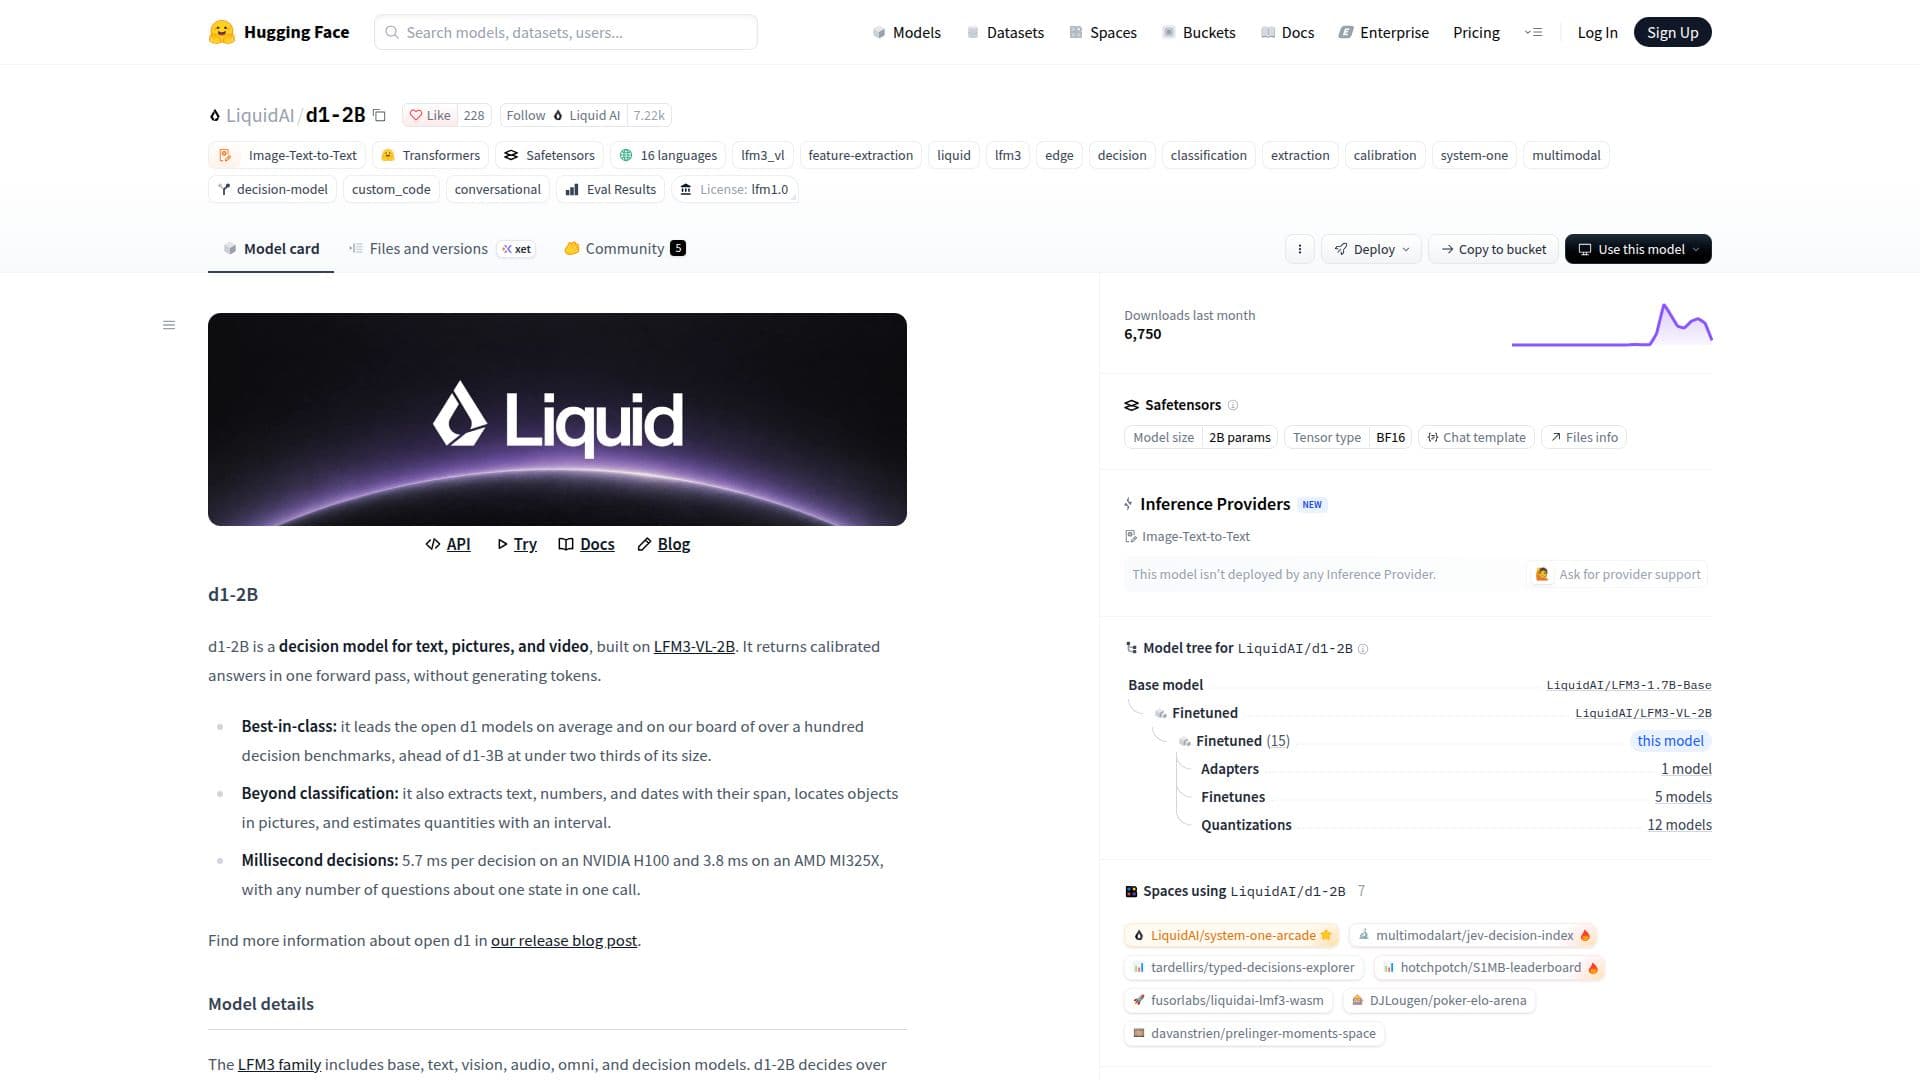
Tangkapan layar d1-2B

d1-2B adalah model keputusan yang sangat efisien yang dikembangkan oleh LiquidAI, tersedia di Hugging Face. Dibangun di atas arsitektur LFM3-VL-2B, model ini dirancang untuk memproses dan membuat keputusan berdasarkan input multimodal, termasuk teks, gambar, dan video. Karakteristik utama dari d1-2B adalah kemampuannya untuk mengembalikan jawaban yang terkalibrasi dalam satu kali proses maju, menghilangkan kebutuhan untuk menghasilkan token, yang berkontribusi pada kecepatan dan efisiensinya.

Baca Selengkapnya

Model ini menunjukkan kinerja terbaik di kelasnya di antara model d1 terbuka, memimpin rata-rata di lebih dari seratus tolok ukur keputusan. Meskipun lebih kecil dari d1-3B, model ini sering kali mengunggulinya, menunjukkan desain yang dioptimalkan. Selain tugas klasifikasi tradisional, d1-2B menawarkan kemampuan canggih seperti mengekstrak teks, angka, dan tanggal tertentu beserta rentangnya, secara tepat menentukan lokasi objek dalam gambar, dan memperkirakan kuantitas dengan interval yang ditentukan.

Kinerja adalah keuntungan signifikan, dengan d1-2B mencapai waktu keputusan 5,7 milidetik pada NVIDIA H100 dan 3,8 milidetik pada AMD MI325X. Pemrosesan cepat ini dipertahankan bahkan dengan beberapa pertanyaan tentang satu keadaan dalam satu panggilan. Keluarga LFM3, yang mencakup d1-2B, memiliki model dasar, teks, visi, audio, omni, dan keputusan. Sementara d1-2B menangani teks, gambar, dan video, saudaranya d1-Omni-2B memperluas kemampuan untuk mencakup audio.

Dengan 1,92 miliar parameter dan arsitektur backbone LFM3 yang terdiri dari 24 lapisan (13 konvolusi pendek berpintu, 5 perhatian jendela geser, 6 perhatian global), d1-2B mendukung panjang konteks 128K token dan kosakata 128.000 token. Model ini menerima input sebagai keadaan (teks atau JSON), gambar, atau video, bersama dengan sejumlah pertanyaan bernama, menghasilkan jawaban bertipe dengan probabilitas tanpa menghasilkan token. Ini mendukung berbagai bahasa, termasuk Inggris, Arab, Cina, Prancis, Jerman, Italia, Jepang, Korea, Portugis, Spanyol, Vietnam, Thai, Indonesia, Hindi, Rusia, dan Polandia.

d1-2B sangat serbaguna, cocok untuk berbagai langkah pipeline yang memerlukan keputusan, seperti pengalihan dan triase, moderasi konten, klasifikasi niat dan topik, ekstraksi data dari dokumen, penilaian dan peringkat ulang, serta inspeksi visual. Model ini secara eksplisit dicatat sebagai bukan model obrolan. Meskipun efektif untuk pertanyaan yang padat pengetahuan, keandalannya mungkin menurun setelah 64K token keadaan. Perkiraan dapat diandalkan untuk hitungan dan skor tetapi kurang untuk kuantitas bebas. Model ini berjalan di Transformers dengan kode modelnya sendiri, tidak memerlukan parameter sampling.

  • KategoriModel AI & LLM
  • Model HargaOpen source
  • PenerapanCloud
  • PlatformWeb

  • Model Keputusan Multimodal (Teks, Gambar, Video)

  • 2 Miliar Parameter

  • Proses Maju Tunggal untuk Jawaban Terkalibrasi

  • Tanpa Generasi Token

  • Kinerja Tolok Ukur Keputusan Terbaik di Kelasnya

  • Ekstraksi Teks, Angka, dan Tanggal

  • Lokasi Objek dalam Gambar

  • Estimasi Kuantitas dengan Interval

  • Kecepatan Keputusan dalam Milidetik (misalnya, 3,8 ms pada AMD MI325X)

  • Arsitektur Backbone LFM3

  • Panjang Konteks 128K Token

  • Kosakata 128.000 Token

  • Dukungan Multibahasa (15+ bahasa)

  • Dirancang untuk Pengalihan, Triase, Moderasi, Ekstraksi

  • Berjalan di Transformers dengan Kode Model Kustom

  1. Akses Halaman Model: Navigasikan ke halaman model LiquidAI/d1-2B di Hugging Face.

  2. Jelajahi Berkas: Tinjau detail model, arsitektur, dan spesifikasi yang disediakan.

  3. Konfigurasi Inferensi: Gunakan pustaka Transformers untuk menyiapkan model untuk inferensi.

  4. Siapkan Input: Berikan keadaan (teks atau JSON), gambar, atau video, bersama dengan pertanyaan bernama.

  5. Eksekusi Panggilan: Gunakan `system_one` untuk permintaan tunggal atau `system_one_batch` untuk permintaan terkelompok.

  6. Interpretasikan Output: Terima jawaban bertipe dengan probabilitas, tanpa token yang dihasilkan.

  • Pengalihan dan Triase
  • Moderasi dan Pengaman
  • Klasifikasi Niat
  • Klasifikasi Topik
  • Ekstraksi dari Dokumen
  • Penilaian dan Peringkat Ulang
  • Inspeksi Visual
  • Pengambilan Keputusan Multimodal
Ulasan d1-2B

Memuat...

Alat AI Populer Seperti d1-2B

LiquidAI d1-omni-600M adalah model keputusan dengan 600 juta parameter yang dirancang untuk keputusan satu kali atas teks, gambar, dan suara. Model ini memproses input multimodal…

Model AI & LLM
Lihat Alat

Model keputusan dengan 600 juta parameter yang dirancang untuk keputusan satu kali atas teks, gambar, dan suara. Model ini memproses input multimodal…LiquidAI d1-omni-600M adalah model keputusan dengan 600 juta parameter yang dirancang untuk keputusan satu kali atas teks, gambar, dan suara. Model ini memproses input multimodal…

Model AI & LLM
Lihat Top 50 LLM

LiquidAI d1-Omni-2B adalah model keputusan yang dirancang untuk memproses teks, gambar, dan audio. Ini memberikan jawaban yang terkalibrasi dengan cepat tanpa menghasilkan token,…

Model AI & LLM
Lihat Alat

Model keputusan yang dirancang untuk memproses teks, gambar, dan audio. Ini memberikan jawaban yang terkalibrasi dengan cepat tanpa menghasilkan token,…LiquidAI d1-Omni-2B adalah model keputusan yang dirancang untuk memproses teks, gambar, dan audio. Ini memberikan jawaban yang terkalibrasi dengan cepat tanpa menghasilkan token,…

Model AI & LLM
Lihat Top 5 Model AI

d3-ultra

Model AI

d3-ultra adalah model keputusan multimodal 27B dari vLLM Semantic Router. Ini memproses teks, JSON, gambar, dan video untuk menjawab pertanyaan dengan probabilitas. Ideal untuk…

Model AI & LLM
Lihat Alat

Model AI

Model keputusan multimodal 27B dari vLLM Semantic Router. Ini memproses teks, JSON, gambar, dan video untuk menjawab pertanyaan dengan probabilitas. Ideal untuk…d3-ultra adalah model keputusan multimodal 27B dari vLLM Semantic Router. Ini memproses teks, JSON, gambar, dan video untuk menjawab pertanyaan dengan probabilitas. Ideal untuk…

Model AI & LLM
Lihat Top 5 Model AI

GLiDE 27B adalah model keputusan dengan 27 miliar parameter yang dikembangkan oleh Fastino. Model ini memproses keadaan yang berisi teks, JSON, dan gambar opsional untuk menjawab…

Model AI & LLM
Lihat Alat

Model keputusan dengan 27 miliar parameter yang dikembangkan oleh Fastino. Model ini memproses keadaan yang berisi teks, JSON, dan gambar opsional untuk menjawab…GLiDE 27B adalah model keputusan dengan 27 miliar parameter yang dikembangkan oleh Fastino. Model ini memproses keadaan yang berisi teks, JSON, dan gambar opsional untuk menjawab…

Model AI & LLM
Lihat Top 50 LLM

DeepSeek-V4-Flash-Vision-Exp adalah model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…

Model AI & LLM
Lihat Alat

Model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…DeepSeek-V4-Flash-Vision-Exp adalah model multimodal eksperimental dalam keluarga DeepSeek-V4, yang meningkatkan kemampuan pemahaman visual. Model ini dibangun di atas arsitektur…

Model AI & LLM
Lihat Top 50 LLM

Ling-3.1-flash adalah model penalaran hibrida canggih yang dirancang untuk tugas-tugas kompleks di dunia nyata. Model ini memiliki total 560 miliar parameter dan jendela konteks 1…

Model AI & LLM

Peringkat 39 di LLM

Lihat Alat

Model penalaran hibrida canggih yang dirancang untuk tugas-tugas kompleks di dunia nyata. Model ini memiliki total 560 miliar parameter dan jendela konteks 1…Ling-3.1-flash adalah model penalaran hibrida canggih yang dirancang untuk tugas-tugas kompleks di dunia nyata. Model ini memiliki total 560 miliar parameter dan jendela konteks 1…

Model AI & LLM
Peringkat 39 di LLM

LiquidAI LFM3-1.7B adalah model teks yang dirancang untuk agen lokal dan aplikasi khusus. Model ini memiliki arsitektur tri-hybrid dan mendukung jendela konteks 256K-token,…

Model AI & LLM
Lihat Alat

Model teks yang dirancang untuk agen lokal dan aplikasi khusus. Model ini memiliki arsitektur tri-hybrid dan mendukung jendela konteks 256K-token,…LiquidAI LFM3-1.7B adalah model teks yang dirancang untuk agen lokal dan aplikasi khusus. Model ini memiliki arsitektur tri-hybrid dan mendukung jendela konteks 256K-token,…

Model AI & LLM
Lihat Top 50 LLM

MiniMax-M3.1-Flash adalah model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…

Model AI & LLM
Lihat Alat

Model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…MiniMax-M3.1-Flash adalah model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…

Model AI & LLM
Lihat Top 50 LLM
1 dari 8