Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 est un modèle de langage efficace basé sur une Mixture-of-Experts (MoE) sparse avec 280 milliards de paramètres au total. Pré-entraîné sur 33,5 trillions de tokens, il prend en charge le fine-tuning et l'inférence avec un contexte de 1 million de tokens. Ce modèle est conçu pour diverses applications, y compris l'adaptation de domaine, le tuning d'instructions et la recherche en apprentissage par renforcement, offrant de solides performances sur plusieurs benchmarks.

Visiter l'URL
Partager
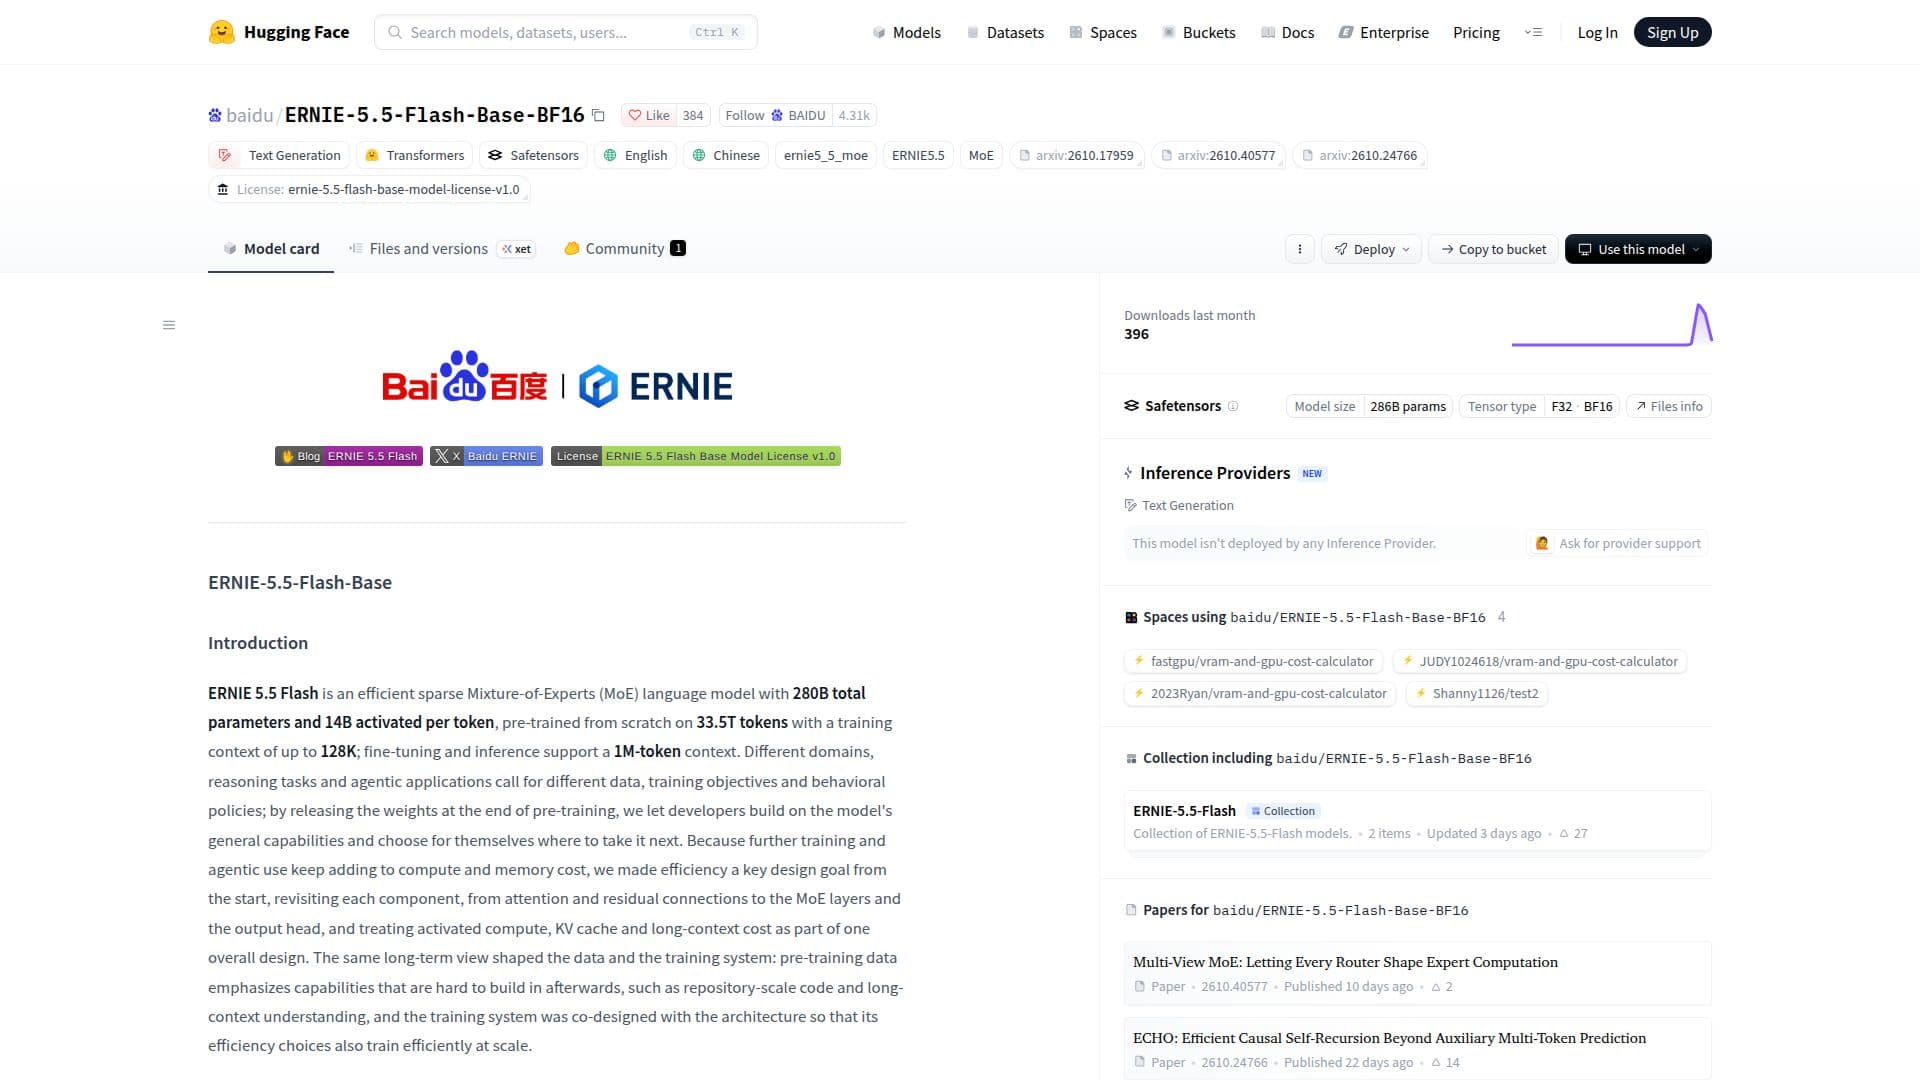
Capture d’écran de ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 est un modèle de langage sophistiqué basé sur une Mixture-of-Experts (MoE) sparse développé par Baidu. Il dispose d'un total substantiel de 280 milliards de paramètres, avec 14 milliards activés par token, ce qui le rend très efficace pour des tâches linguistiques complexes. Le modèle a été pré-entraîné à partir de zéro sur un ensemble de données étendu de 33,5 trillions de tokens, utilisant un contexte d'entraînement allant jusqu'à 128 000 tokens. Pour le fine-tuning et l'inférence, il prend en charge une impressionnante longueur de contexte de 1 million de tokens, permettant une compréhension approfondie et la génération de contenu long.

Lire la suite

Conçu avec l'efficacité comme principe fondamental, ERNIE 5.5 Flash revisite chaque composant, des mécanismes d'attention et des connexions résiduelles aux couches MoE et à la tête de sortie. Cette approche holistique garantit des performances optimales tout en gérant les coûts de calcul, de cache KV et de long contexte. Les données de pré-entraînement mettent l'accent sur des capacités cruciales pour des applications avancées, telles que la compréhension de code à l'échelle des dépôts et la compréhension de long contexte, permettant aux développeurs de s'appuyer sur ses capacités générales pour divers cas d'utilisation.

ERNIE-5.5-Flash-Base-BF16 représente le point de contrôle à la fin du pré-entraînement, servant de modèle fondamental avant toute étape de formation intermédiaire ou postérieure. Cela en fait un point de départ idéal pour les chercheurs et les développeurs engagés dans l'adaptation de domaine, le tuning d'instructions et l'apprentissage par renforcement. Le modèle a démontré de solides résultats à travers un pipeline d'évaluation unifié, excellant dans des benchmarks liés à la connaissance, au raisonnement, aux mathématiques, au code, aux tâches multilingues et à la compréhension de long contexte.

L'architecture incorpore un MoE hybride d'attention 280B-A14B avec 43 couches, y compris 1 FFN dense et 42 couches MoE Latentes Multi-Router. Il dispose de 37 couches d'Attention Lourdement Comprimée (HCA) et de 6 couches d'Attention Latente Multi-tête (MLA + DSA) avec attention sparse. Le modèle utilise 512 experts routés (top-10) plus 1 expert partagé par couche MoE. Des innovations telles que l'Attention Gated à Faible Rang, l'Attention de Tête Virtuelle (VHA), le MoE Latent Multi-Router, ECHO, les Hyper-Connexions Contraintes par Variété (mHC) et la Tête de Sortie MultiMax contribuent à ses capacités avancées et à son efficacité. Le tokenizer prend en charge environ 200 000 entrées et tokenize les nombres de droite à gauche par groupes de jusqu'à trois chiffres.

Le déploiement est pris en charge avec SGLang et vLLM, permettant un service de production avec des longueurs de contexte allant jusqu'à 1 048 576 tokens. Le modèle est disponible sous l'Accord de Licence du Modèle de Base ERNIE 5.5 Flash v1.0.

  • CatégorieModèles d'IA et LLM
  • DéploiementCloud
  • PlateformesWeb

  • 280 milliards de paramètres au total

  • 14 milliards de paramètres activés par token

  • Pré-entraîné sur 33,5 trillions de tokens

  • Contexte d'entraînement allant jusqu'à 128 000 tokens

  • Le fine-tuning et l'inférence prennent en charge un contexte de 1 million de tokens

  • Architecture MoE sparse efficace

  • MoE hybride d'attention avec 43 couches

  • 37 couches d'Attention Lourdement Comprimée (HCA)

  • 6 couches d'Attention Latente Multi-tête (MLA + DSA)

  • 512 experts routés (top-10) plus 1 expert partagé par couche MoE

  • Attention Gated à Faible Rang et Attention de Tête Virtuelle (VHA)

  • MoE Latent Multi-Router pour une sélection précise des experts

  • ECHO pour la perte multi-horizon et le décodage spéculatif

  • Hyper-Connexions Contraintes par Variété (mHC) pour la propagation du signal

  • Tête de Sortie MultiMax pour une distribution de vocabulaire affinée

  • Tokenizer BPE d'environ 200 000 entrées

  • Support pour SGLang et vLLM pour le service de production

  1. Accéder à la page du modèle : Naviguez vers la page ERNIE-5.5-Flash-Base-BF16 sur Hugging Face.

  2. Explorer les fichiers : Consultez les fichiers du modèle et la documentation disponibles sur la page.

  3. Télécharger le modèle : Téléchargez le point de contrôle du modèle ERNIE-5.5-Flash-Base-BF16.

  4. Installer vLLM et le plugin : Installez vLLM et le plugin ERNIE 5.5 pour le déploiement.

  5. Lancer le serveur : Utilisez SGLang ou vLLM pour lancer le serveur du modèle.

  6. Envoyer des requêtes : Envoyez des requêtes à l'endpoint de complétions en utilisant des outils comme curl pour l'inférence.

  • Génération de texte
  • Adaptation de domaine
  • Tuning d'instructions
  • Recherche en apprentissage par renforcement
  • Compréhension de code
  • Compréhension de long contexte
  • Applications multilingues
  • Tâches de raisonnement
  • Applications agentiques

Chez Baidu

Un modèle de Baidu Wenxin Assistant.

Avis sur ERNIE-5.5-Flash-Base-BF16

Chargement...

Outils IA populaires comme ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base est un modèle de langage efficace basé sur un mélange d'experts (MoE) avec 280 milliards de paramètres au total, conçu pour la génération de texte.…

Modèles d'IA et LLM
Voir l'outil

Modèle de langage efficace basé sur un mélange d'experts (MoE) avec 280 milliards de paramètres au total, conçu pour la génération de texte.…ERNIE-5.5-Flash-Base est un modèle de langage efficace basé sur un mélange d'experts (MoE) avec 280 milliards de paramètres au total, conçu pour la génération de texte.…

Modèles d'IA et LLM
Voir le Top 100 LLM

DeepSeek-V4-Pro est un modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…

Modèles d'IA et LLM
Voir l'outil

Modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…DeepSeek-V4-Pro est un modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…

En vedetteModèles d'IA et LLM
Voir le Top 100 LLM

DeepSeek-V3 est un modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…

Modèles d'IA et LLM

N°42 en LLM

Voir l'outil

Modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…DeepSeek-V3 est un modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…

En vedetteModèles d'IA et LLM
N°42 en LLM

DeepSeek-V4-Pro-DSpark est un modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…

Modèles d'IA et LLM

N°71 en LLM

Voir l'outil

Modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…DeepSeek-V4-Pro-DSpark est un modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…

Modèles d'IA et LLM
N°71 en LLM

AliceAI-Foundation-80B-A3B-Base est un modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…

Modèles d'IA et LLM

N°29 en LLM

Voir l'outil

Modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…AliceAI-Foundation-80B-A3B-Base est un modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…

Modèles d'IA et LLM
N°29 en LLM

Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM

N°65 en LLM

Voir l'outil

Modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM
N°65 en LLM

DeepSeek-V3

Dépôts GitHub d'IA

DeepSeek-V3 est un modèle de langage Mixture-of-Experts à poids ouverts de DeepSeek, avec 671 milliards de paramètres au total et 37 milliards activés par token. Pré-entraîné sur…

Modèles d'IA et LLM
Voir l'outil

Dépôts GitHub d'IA

Modèle de langage Mixture-of-Experts à poids ouverts de DeepSeek, avec 671 milliards de paramètres au total et 37 milliards activés par token. Pré-entraîné sur…DeepSeek-V3 est un modèle de langage Mixture-of-Experts à poids ouverts de DeepSeek, avec 671 milliards de paramètres au total et 37 milliards activés par token. Pré-entraîné sur…

Modèles d'IA et LLM
Voir le Top 250 Dépôts GitHub d'IA

Kimi-K2-Instruct est un modèle de langage à la pointe de la technologie, basé sur un mélange d'experts, conçu pour des tâches avancées en IA. Il excelle dans le raisonnement, la…

Modèles d'IA et LLM

N°51 en LLM

Voir l'outil

Kimi-K2-Instruct est un modèle de langage à la pointe de la technologie, basé sur un mélange d'experts, conçu pour des tâches avancées en IA. Il excelle dans le raisonnement, la…

Modèles d'IA et LLM
N°51 en LLM
1 sur 8