Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

ERNIE-5.5-Flash-Base

LLMModèles d'IA et LLMOpen source · Web

ERNIE-5.5-Flash-Base est un modèle de langage efficace basé sur un mélange d'experts (MoE) avec 280 milliards de paramètres au total, conçu pour la génération de texte. Pré-entraîné sur 33,5 trillions de tokens, il prend en charge le fine-tuning et l'inférence avec un contexte de 1 million de tokens. Ce modèle sert de point de départ robuste pour l'adaptation au domaine, le réglage des instructions et la recherche en apprentissage par renforcement, offrant de solides performances à travers divers benchmarks.

Visiter l'URL
Partager
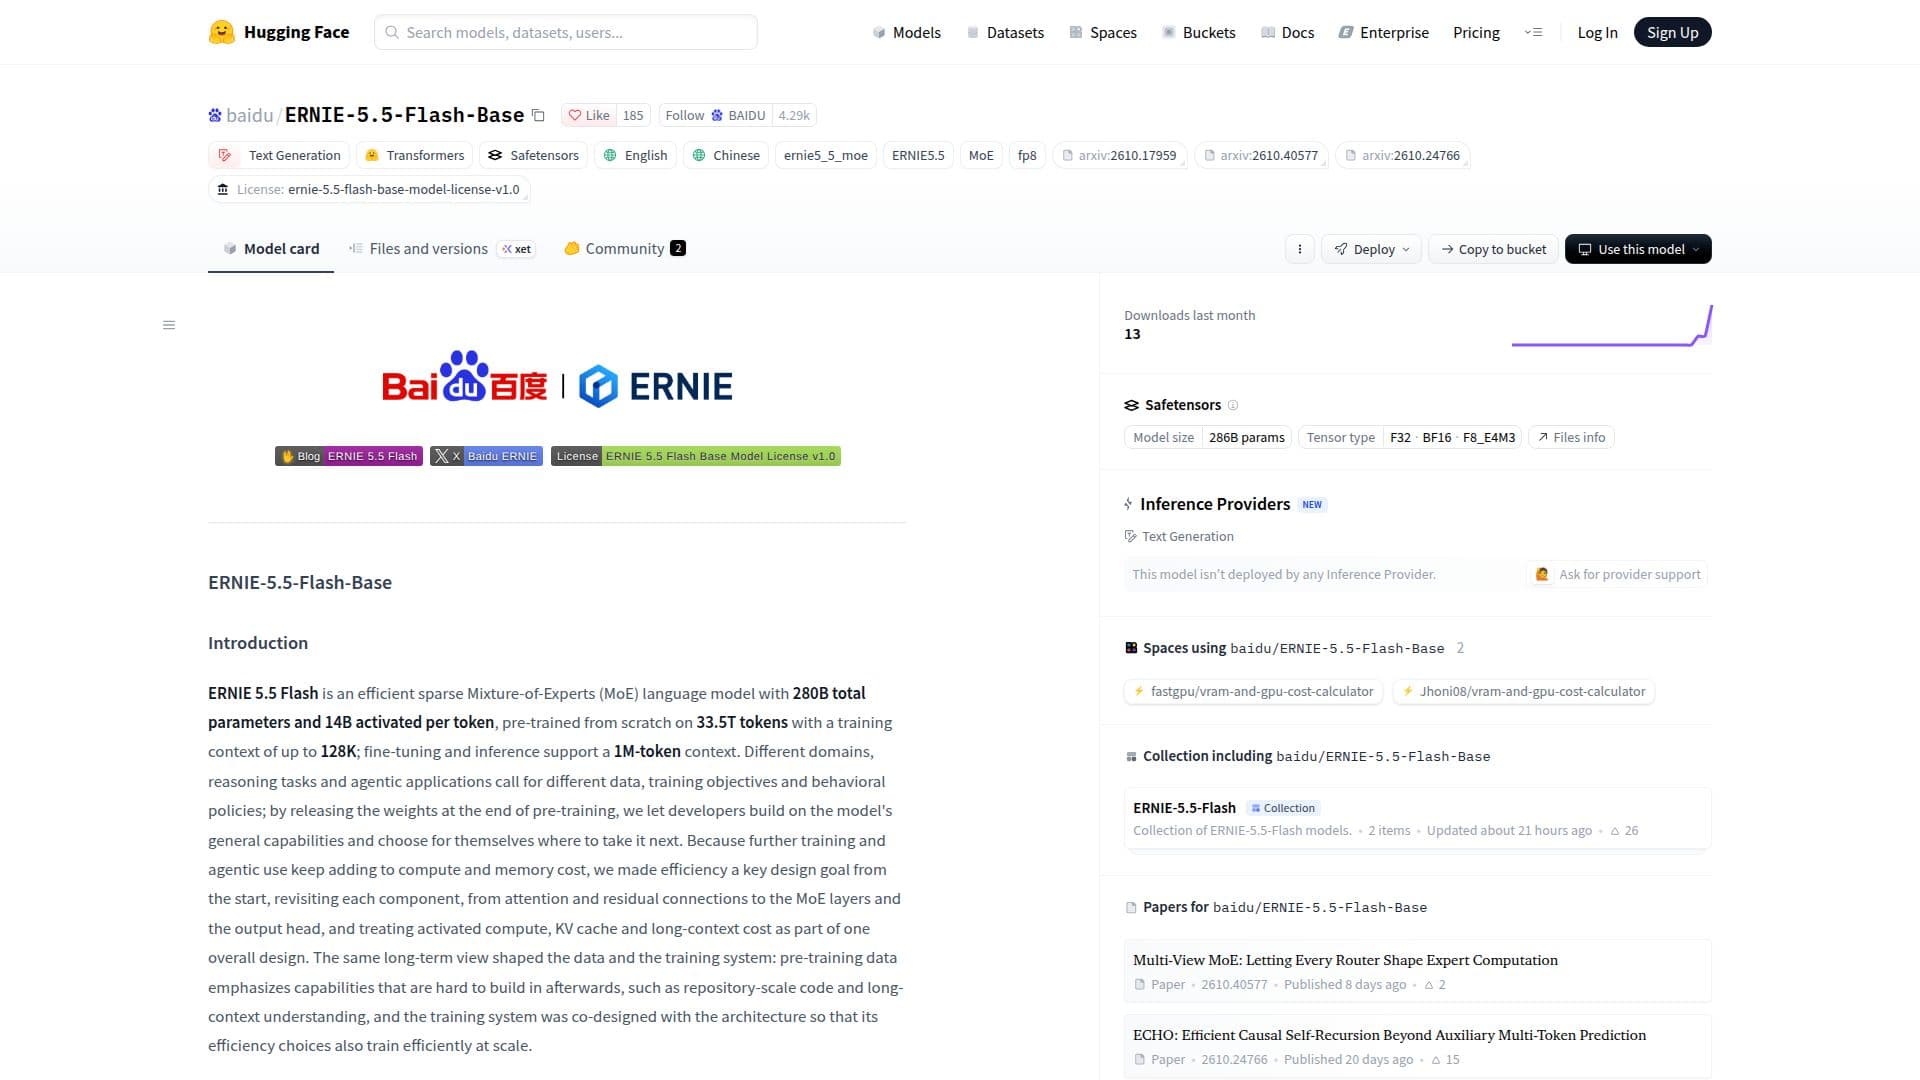
Capture d’écran de ERNIE-5.5-Flash-Base

ERNIE-5.5-Flash-Base est un modèle sophistiqué de génération de texte développé par Baidu, disponible sur Hugging Face. Il s'agit d'un modèle de langage efficace basé sur un mélange d'experts (MoE), avec 280 milliards de paramètres au total et 14 milliards activés par token. Le modèle a été pré-entraîné à partir de zéro sur un vaste ensemble de données de 33,5 trillions de tokens, utilisant un contexte d'entraînement allant jusqu'à 128K. Pour le fine-tuning et l'inférence, il prend en charge une impressionnante longueur de contexte de 1 million de tokens.

Lire la suite

Conçu avec l'efficacité comme objectif principal, ERNIE 5.5 Flash revisite chaque composant, des mécanismes d'attention et des connexions résiduelles aux couches MoE et à la tête de sortie. Cette approche holistique considère le calcul activé, le cache KV et les coûts de long contexte comme partie intégrante d'un design intégré. Les données de pré-entraînement mettent l'accent sur des capacités difficiles à construire après l'entraînement, telles que la compréhension du code à l'échelle des dépôts et la compréhension des longs contextes. Le système d'entraînement a été co-conçu avec l'architecture pour garantir une mise à l'échelle efficace.

ERNIE-5.5-Flash-Base représente le point de contrôle à la fin du pré-entraînement, ce qui en fait une base idéale pour les développeurs. Il permet l'adaptation au domaine, le réglage des instructions et la recherche en apprentissage par renforcement. Le modèle démontre de solides résultats à travers un pipeline d'évaluation unifié, couvrant les connaissances, le raisonnement, les mathématiques, le code, les tâches multilingues et les benchmarks de long contexte. Ses performances sont évaluées par rapport à d'autres grands modèles comme DeepSeek-V4-Flash-Base, Hy3-preview-Base et MiMo-V2.5-Base, tous évalués dans des conditions cohérentes.

L'architecture incorpore un MoE hybride d'attention 280B-A14B avec 43 couches, y compris 1 FFN dense et 42 couches MoE Latentes Multi-Router. Elle comprend 37 couches d'attention fortement compressées (HCA) et 6 couches d'attention latente multi-têtes avec attention sparse (MLA + DSA). Le modèle utilise 512 experts routés (top-10) plus 1 expert partagé par couche MoE. Les innovations clés incluent l'attention hybride MLA + HCA avec des dimensions de tête spécifiques à la couche, l'attention à faible rang avec portes, l'attention de tête virtuelle (VHA), le MoE latent Multi-Router, ECHO pour la prédiction de tokens futurs, les hyperconnexions contraintes par des variétés (mHC) et une tête de sortie MultiMax. Le tokenizer utilise un tokenizer BPE d'environ 200K entrées qui tokenize les nombres de droite à gauche par groupes de jusqu'à trois chiffres.

Le déploiement d'ERNIE-5.5-Flash-Base est pris en charge avec SGLang et vLLM, permettant un service de production avec des longueurs de contexte allant jusqu'à 1 048 576 tokens pour l'inférence à long contexte. Le modèle est fourni sous l'accord de licence du modèle ERNIE 5.5 Flash Base v1.0, avec des droits d'auteur détenus par Baidu.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • 280 milliards de paramètres au total avec 14 milliards activés par token

  • Pré-entraîné sur 33,5 trillions de tokens

  • Prend en charge un contexte de 1 million de tokens pour le fine-tuning et l'inférence

  • Architecture efficace de mélange d'experts (MoE)

  • Attention hybride MLA + HCA avec des dimensions de tête spécifiques à la couche

  • Attention à faible rang avec portes et attention de tête virtuelle (VHA)

  • MoE latent Multi-Router avec 512 experts routés et 1 expert partagé

  • ECHO pour la perte multi-horizon et le décodage spéculatif

  • Hyperconnexions contraintes par des variétés (mHC) pour la propagation du signal

  • Tête de sortie MultiMax pour une distribution de vocabulaire affinée

  • Tokenizer BPE d'environ 200K entrées avec tokenisation des nombres de droite à gauche

  • Prend en charge le déploiement avec SGLang et vLLM

  • Solides performances à travers les benchmarks de connaissances, de raisonnement, de mathématiques, de code, multilingues et de long contexte

  • Poids de précision FP8 et BF16 disponibles

  1. Accéder au modèle : Naviguez vers la page ERNIE-5.5-Flash-Base sur Hugging Face.

  2. Télécharger le modèle : Choisissez entre la précision FP8 (safetensors) ou BF16 (safetensors) pour le téléchargement.

  3. Installer les outils de déploiement : Installez vLLM et le plugin ERNIE 5.5, ou utilisez l'image Docker préconstruite officielle SGLang.

  4. Lancer le serveur : Démarrez le serveur vLLM ou SGLang pour héberger le modèle.

  5. Envoyer des requêtes : Utilisez curl ou d'autres clients API pour envoyer des requêtes à l'endpoint de complétions pour la génération de texte.

  6. Fine-tuner le modèle : Utilisez le point de contrôle pré-entraîné pour l'adaptation au domaine, le réglage des instructions ou la recherche en apprentissage par renforcement.

  • Génération de texte
  • Adaptation au domaine
  • Réglage des instructions
  • Recherche en apprentissage par renforcement
  • Génération et compréhension de code
  • Compréhension de long contexte
  • Applications multilingues
  • Tâches de raisonnement

Chez Baidu

Un modèle de Baidu Wenxin Assistant.

Avis sur ERNIE-5.5-Flash-Base

Chargement...

Outils IA populaires comme ERNIE-5.5-Flash-Base

DeepSeek-V4-Pro est un modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…

Modèles d'IA et LLM
Voir l'outil

Modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…DeepSeek-V4-Pro est un modèle IA avancé conçu pour une intelligence contextuelle efficace sur un million de tokens. Il dispose d'une architecture d'attention hybride et est…

En vedetteModèles d'IA et LLM
Voir le Top 50 LLM

DeepSeek-V3 est un modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…

Modèles d'IA et LLM

N°37 en LLM

Voir l'outil

Modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…DeepSeek-V3 est un modèle de langage Mixture-of-Experts avec 671 milliards de paramètres, conçu pour une inférence efficace et un entraînement économique. Il excelle dans divers…

En vedetteModèles d'IA et LLM
N°37 en LLM

AliceAI-Foundation-80B-A3B-Base est un modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…

Modèles d'IA et LLM

N°28 en LLM

Voir l'outil

Modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…AliceAI-Foundation-80B-A3B-Base est un modèle de langage fondamental avec une architecture hybride et des couches MoE, comportant 80 milliards de paramètres. Il excelle dans les…

Modèles d'IA et LLM
N°28 en LLM

Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM
Voir l'outil

Modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM
Voir le Top 50 LLM

Kimi-K2-Instruct est un modèle de langage à la pointe de la technologie, basé sur un mélange d'experts, conçu pour des tâches avancées en IA. Il excelle dans le raisonnement, la…

Modèles d'IA et LLM

N°46 en LLM

Voir l'outil

Kimi-K2-Instruct est un modèle de langage à la pointe de la technologie, basé sur un mélange d'experts, conçu pour des tâches avancées en IA. Il excelle dans le raisonnement, la…

Modèles d'IA et LLM
N°46 en LLM

MiniMax-M3.1-Flash est un modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…

Modèles d'IA et LLM
Voir l'outil

Modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…MiniMax-M3.1-Flash est un modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…

Modèles d'IA et LLM
Voir le Top 50 LLM

DeepSeek-V4-Pro-DSpark est un modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…

Modèles d'IA et LLM
Voir l'outil

Modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…DeepSeek-V4-Pro-DSpark est un modèle de langage avancé doté d'une architecture d'attention hybride et de connexions hyper-contraintes sur variétés. Il prend en charge une longueur…

Modèles d'IA et LLM
Voir le Top 50 LLM

Solar Open 2 est un grand modèle de langage développé par Upstage, conçu pour des cas d'utilisation agentiques tels que la productivité de bureau et la programmation. Il dispose…

Modèles d'IA et LLM

N°19 en LLM

Voir l'outil

Grand modèle de langage développé par Upstage, conçu pour des cas d'utilisation agentiques tels que la productivité de bureau et la programmation. Il dispose…Solar Open 2 est un grand modèle de langage développé par Upstage, conçu pour des cas d'utilisation agentiques tels que la productivité de bureau et la programmation. Il dispose…

Modèles d'IA et LLM
N°19 en LLM
1 sur 8