Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

d1-2B

LLMModèles d'IA et LLMOpen source · Web

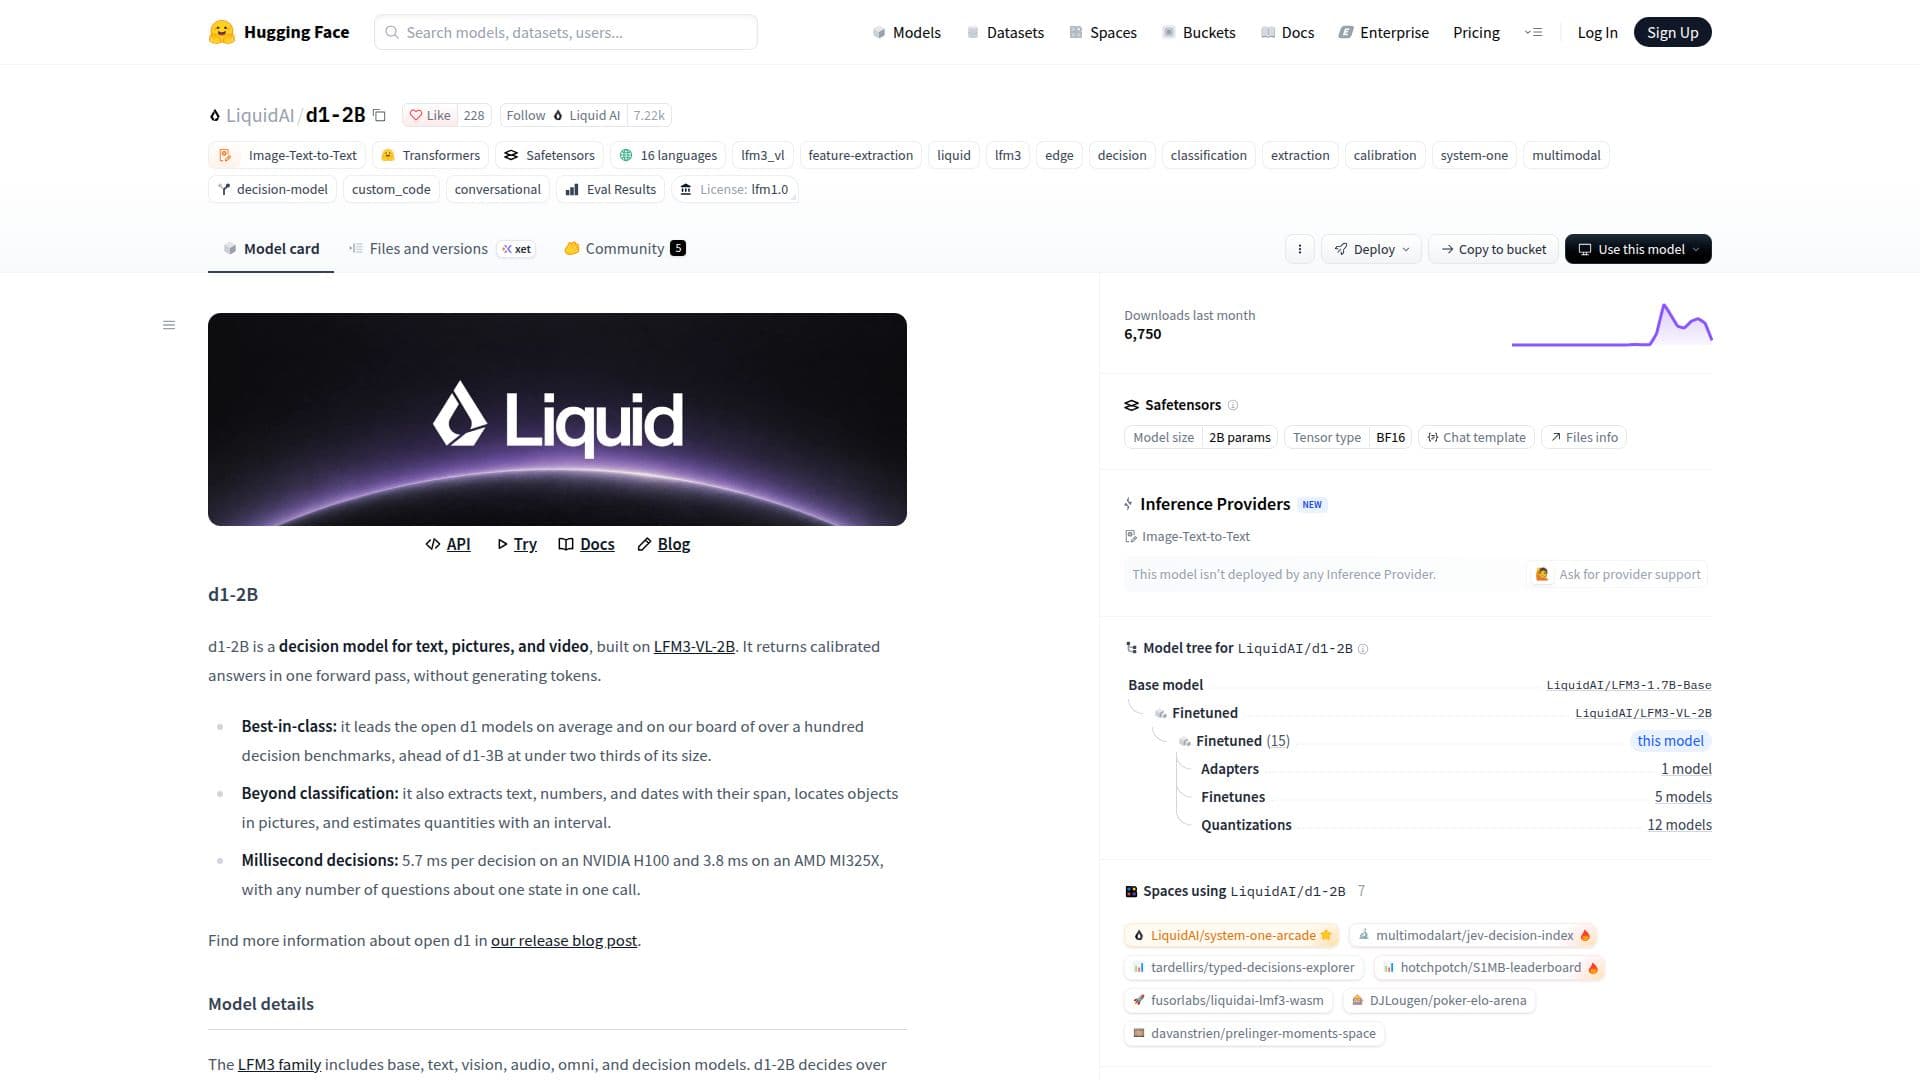
d1-2B est un modèle de décision construit sur LFM3-VL-2B, conçu pour l'analyse de texte, d'images et de vidéos. Il fournit des réponses calibrées en un seul passage avant sans générer de jetons. Ce modèle excelle dans divers benchmarks de décision, offrant des capacités au-delà de la classification, y compris l'extraction de texte, la localisation d'objets et l'estimation de quantités. Il est optimisé pour une prise de décision rapide dans diverses applications.

Visiter l'URL
Partager
Capture d’écran de d1-2B

d1-2B est un modèle de décision hautement efficace développé par LiquidAI, disponible sur Hugging Face. Basé sur l'architecture LFM3-VL-2B, ce modèle est conçu pour traiter et prendre des décisions à partir d'entrées multimodales, y compris le texte, les images et la vidéo. Une caractéristique clé de d1-2B est sa capacité à retourner des réponses calibrées en un seul passage avant, éliminant ainsi le besoin de génération de jetons, ce qui contribue à sa rapidité et son efficacité.

Lire la suite

Le modèle démontre des performances de premier ordre parmi les modèles d1 ouverts, se classant en tête en moyenne sur plus d'une centaine de benchmarks de décision. Bien qu'il soit plus petit que d1-3B, il le surpasse souvent, mettant en avant son design optimisé. Au-delà des tâches de classification traditionnelles, d1-2B offre des capacités avancées telles que l'extraction de texte, de nombres et de dates avec leurs intervalles, la localisation précise d'objets dans les images et l'estimation de quantités avec des intervalles définis.

La performance est un avantage significatif, d1-2B atteignant des temps de décision de 5,7 millisecondes sur un NVIDIA H100 et 3,8 millisecondes sur un AMD MI325X. Ce traitement rapide est maintenu même avec plusieurs questions sur un seul état dans un seul appel. La famille LFM3, qui comprend d1-2B, propose des modèles de base, de texte, de vision, d'audio, omni et de décision. Alors que d1-2B gère le texte, les images et la vidéo, son homologue d1-Omni-2B étend les capacités pour inclure l'audio.

Avec 1,92 milliard de paramètres et une architecture de base LFM3 comprenant 24 couches (13 convolutions courtes à portes, 5 attentions à fenêtre glissante, 6 attentions globales), d1-2B prend en charge une longueur de contexte de 128K jetons et un vocabulaire de 128 000 jetons. Il accepte des entrées sous forme d'état (texte ou JSON), d'images ou de vidéos, ainsi que n'importe quel nombre de questions nommées, produisant des réponses typées avec des probabilités sans générer de jetons. Il prend en charge un large éventail de langues, y compris l'anglais, l'arabe, le chinois, le français, l'allemand, l'italien, le japonais, le coréen, le portugais, l'espagnol, le vietnamien, le thaï, l'indonésien, l'hindi, le russe et le polonais.

d1-2B est polyvalent, adapté à diverses étapes de pipeline nécessitant des décisions, telles que le routage et le triage, la modération de contenu, la classification d'intentions et de sujets, l'extraction de données à partir de documents, le jugement et le reclassement, et l'inspection visuelle. Il est explicitement noté qu'il ne s'agit pas d'un modèle de chat. Bien qu'efficace pour des questions riches en connaissances, la fiabilité peut diminuer au-delà de 64K jetons d'état. Les estimations sont fiables pour les comptes et les scores mais moins pour les quantités libres. Le modèle fonctionne dans Transformers avec son propre code, ne nécessitant aucun paramètre d'échantillonnage.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • Modèle de Décision Multimodal (Texte, Images, Vidéo)

  • 2 Milliards de Paramètres

  • Passage Avant Unique pour Réponses Calibrées

  • Pas de Génération de Jetons

  • Performance de Benchmark de Décision de Premier Ordre

  • Extraction de Texte, Nombres et Dates

  • Localisation d'Objets dans les Images

  • Estimation de Quantités avec Intervalles

  • Vitesse de Décision en Millisecondes (par exemple, 3,8 ms sur AMD MI325X)

  • Architecture de Base LFM3

  • Longueur de Contexte de 128K Jetons

  • Vocabulaire de 128 000 Jetons

  • Support Multilingue (15+ langues)

  • Conçu pour le Routage, le Triage, la Modération, l'Extraction

  • Fonctionne dans Transformers avec Code de Modèle Personnalisé

  1. Accéder à la Page du Modèle : Naviguez vers la page du modèle LiquidAI/d1-2B sur Hugging Face.

  2. Explorer les Fichiers : Consultez les détails du modèle, l'architecture et les spécifications fournies.

  3. Configurer l'Inférence : Utilisez la bibliothèque Transformers pour configurer le modèle pour l'inférence.

  4. Préparer les Entrées : Fournissez un état (texte ou JSON), des images ou une vidéo, ainsi que des questions nommées.

  5. Exécuter les Appels : Utilisez `system_one` pour des demandes uniques ou `system_one_batch` pour des demandes groupées.

  6. Interpréter la Sortie : Recevez des réponses typées avec des probabilités, sans jetons générés.

  • Routage et Triage
  • Modération et Garde-fous
  • Classification d'Intentions
  • Classification de Sujets
  • Extraction de Documents
  • Jugement et Reclassement
  • Inspection Visuelle
  • Prise de Décision Multimodale

Avis sur d1-2B

Chargement...

Outils IA populaires comme d1-2B

LiquidAI d1-omni-600M est un modèle de décision de 600 millions de paramètres conçu pour des décisions en un seul passage sur du texte, des images et de la parole. Il traite…

Modèles d'IA et LLM
Voir l'outil

Modèle de décision de 600 millions de paramètres conçu pour des décisions en un seul passage sur du texte, des images et de la parole. Il traite…LiquidAI d1-omni-600M est un modèle de décision de 600 millions de paramètres conçu pour des décisions en un seul passage sur du texte, des images et de la parole. Il traite…

Modèles d'IA et LLM
Voir le Top 50 LLM

LiquidAI d1-Omni-2B est un modèle de décision conçu pour traiter du texte, des images et de l'audio. Il fournit des réponses calibrées rapidement sans générer de jetons, ce qui le…

Modèles d'IA et LLM
Voir l'outil

Modèle de décision conçu pour traiter du texte, des images et de l'audio. Il fournit des réponses calibrées rapidement sans générer de jetons, ce qui le…LiquidAI d1-Omni-2B est un modèle de décision conçu pour traiter du texte, des images et de l'audio. Il fournit des réponses calibrées rapidement sans générer de jetons, ce qui le…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

d3-ultra

Modèles IA

d3-ultra est un modèle de décision multimodal de 27B provenant de vLLM Semantic Router. Il traite du texte, du JSON, des images et des vidéos pour répondre à des questions avec…

Modèles d'IA et LLM
Voir l'outil

Modèles IA

Modèle de décision multimodal de 27B provenant de vLLM Semantic Router. Il traite du texte, du JSON, des images et des vidéos pour répondre à des questions avec…d3-ultra est un modèle de décision multimodal de 27B provenant de vLLM Semantic Router. Il traite du texte, du JSON, des images et des vidéos pour répondre à des questions avec…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

GLiDE 27B est un modèle de décision de 27 milliards de paramètres développé par Fastino. Il traite des états contenant du texte, du JSON et des images optionnelles pour répondre à…

Modèles d'IA et LLM
Voir l'outil

Modèle de décision de 27 milliards de paramètres développé par Fastino. Il traite des états contenant du texte, du JSON et des images optionnelles pour répondre à…GLiDE 27B est un modèle de décision de 27 milliards de paramètres développé par Fastino. Il traite des états contenant du texte, du JSON et des images optionnelles pour répondre à…

Modèles d'IA et LLM
Voir le Top 50 LLM

DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir l'outil

Modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir le Top 50 LLM

Ling-3.1-flash est un modèle avancé de raisonnement hybride conçu pour des tâches complexes du monde réel. Il dispose de 560 milliards de paramètres au total et d'une fenêtre de…

Modèles d'IA et LLM

N°41 en LLM

Voir l'outil

Modèle avancé de raisonnement hybride conçu pour des tâches complexes du monde réel. Il dispose de 560 milliards de paramètres au total et d'une fenêtre de…Ling-3.1-flash est un modèle avancé de raisonnement hybride conçu pour des tâches complexes du monde réel. Il dispose de 560 milliards de paramètres au total et d'une fenêtre de…

Modèles d'IA et LLM
N°41 en LLM

LiquidAI LFM3-1.7B est un modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…

Modèles d'IA et LLM
Voir l'outil

Modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…LiquidAI LFM3-1.7B est un modèle de texte conçu pour des agents locaux et des applications spécialisées. Il dispose d'une architecture tri-hybride et prend en charge une fenêtre…

Modèles d'IA et LLM
Voir le Top 50 LLM

MiniMax-M3.1-Flash est un modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…

Modèles d'IA et LLM
Voir l'outil

Modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…MiniMax-M3.1-Flash est un modèle multimodal de mélange d'experts conçu pour le codage, les flux de travail agentiques et la cybersécurité. Il prend en charge les entrées de texte,…

Modèles d'IA et LLM
Voir le Top 50 LLM
1 sur 8