Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

LiquidAI d1-omni-600M

LLMModèles d'IA et LLMOpen source · Web

LiquidAI d1-omni-600M est un modèle de décision de 600 millions de paramètres conçu pour des décisions en un seul passage sur du texte, des images et de la parole. Il traite efficacement des entrées multimodales pour fournir des réponses rapides et précises sans générer de jetons de sortie.

Visiter l'URL
Partager
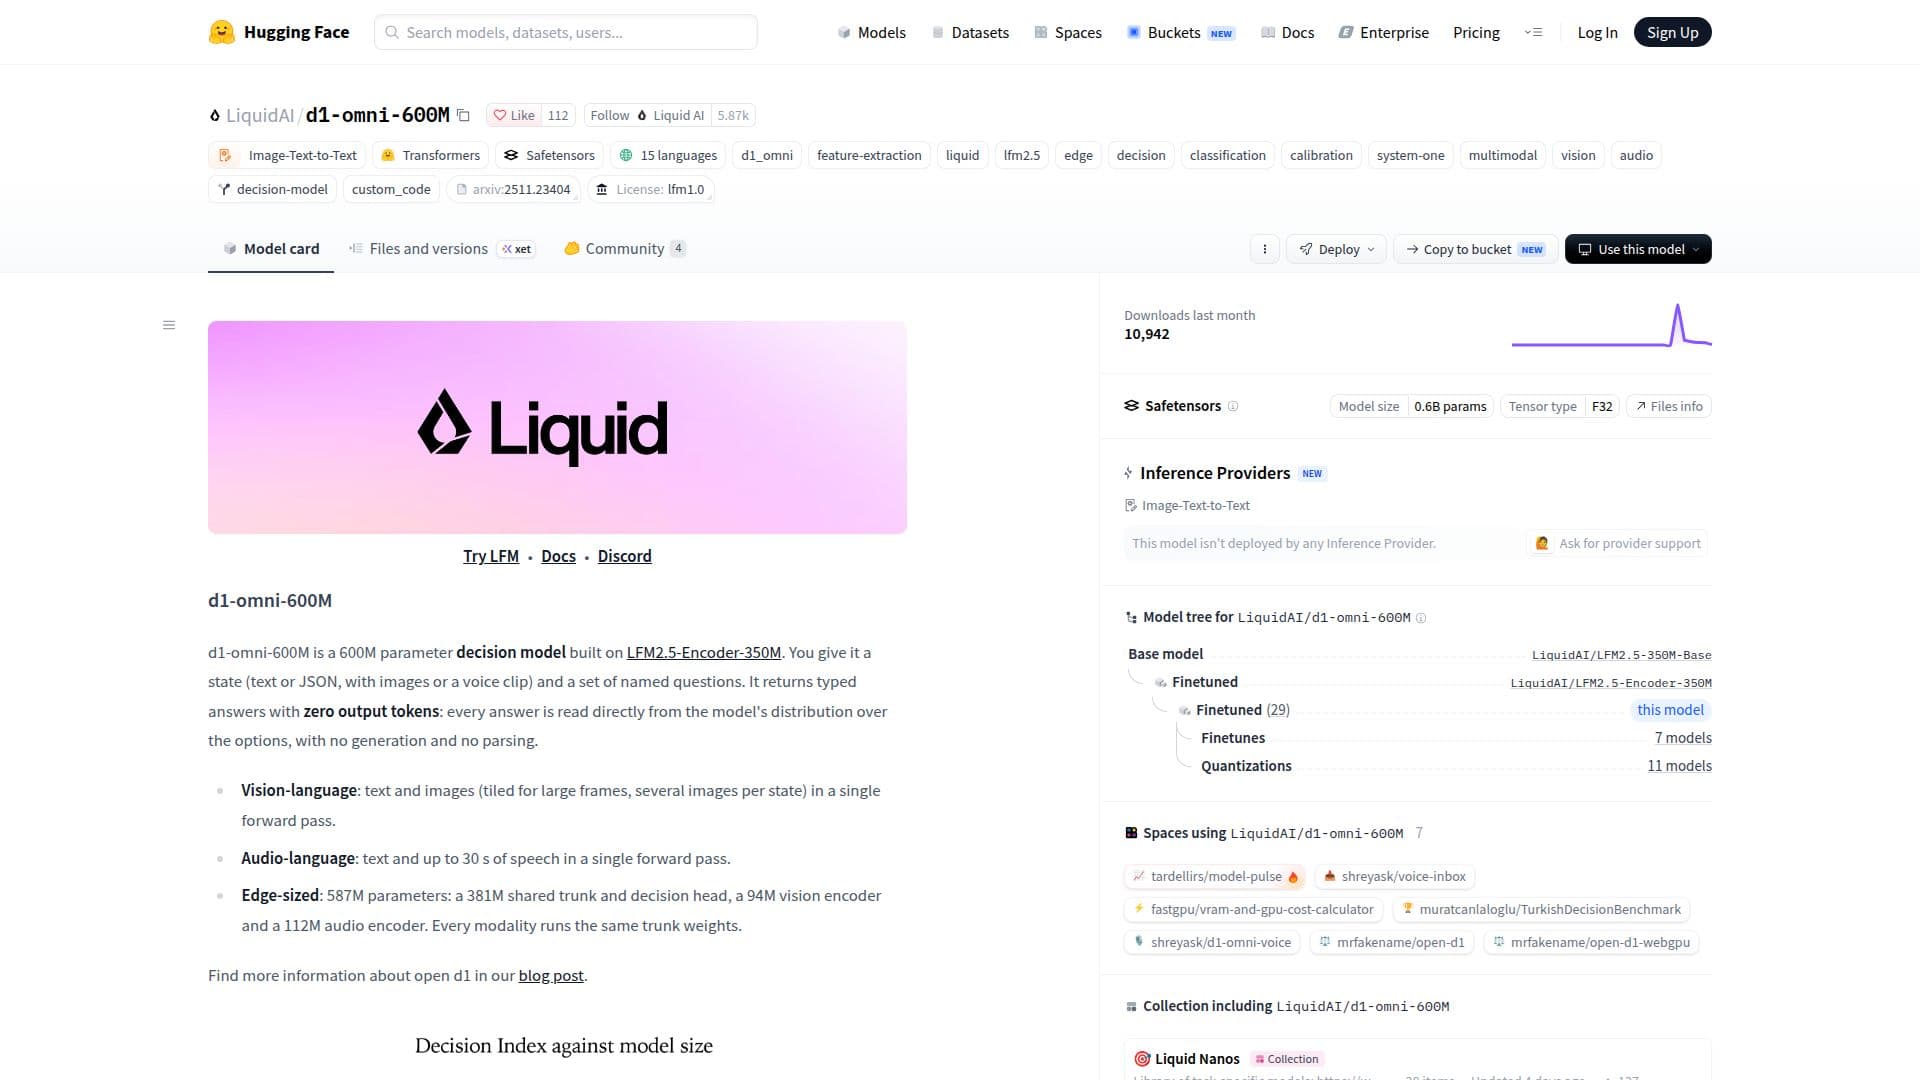
Capture d’écran de LiquidAI d1-omni-600M

LiquidAI d1-omni-600M est un modèle de décision sophistiqué comportant 600 millions de paramètres, construit sur le cadre LFM2.5-Encoder-350M. Ce modèle est conçu pour gérer des entrées multimodales, y compris le texte, les images et l'audio, en un seul passage avant. Il est particulièrement adapté aux applications nécessitant des réponses oui/non, des sélections d'options ou des évaluations, telles que le routage, la modération, la classification et les tâches d'inspection visuelle.

Lire la suite

L'architecture du modèle comprend un tronc partagé et une tête de décision, ainsi que des encodeurs spécialisés pour la vision et l'audio. L'encodeur de vision est basé sur la tour de vision SigLIP2, tandis que l'encodeur audio utilise un FastConformer à 17 couches. Ce design garantit que toutes les modalités sont traitées en utilisant les mêmes poids de tronc, améliorant ainsi l'efficacité et la cohérence.

Une des caractéristiques clés de d1-omni-600M est sa capacité à retourner des réponses typées directement à partir de la distribution du modèle sur les options, éliminant ainsi le besoin de génération ou d'analyse de jetons de sortie. Cette capacité est particulièrement bénéfique pour les déploiements en périphérie où la rapidité et l'efficacité des ressources sont critiques.

Le modèle prend en charge une longueur de contexte de 16 384 jetons, accueillant ensemble les positions de texte, d'image et d'audio. Lorsque des images sont incluses, le texte de l'état et de la question est limité à 896 jetons, conformément aux spécifications de formation. La taille du vocabulaire du modèle est de 65 536, permettant un large éventail de traitement des entrées.

Les capacités audio ont été spécifiquement entraînées en utilisant des interactions entre un locuteur anglais et un assistant, en se concentrant sur l'identification des types d'énoncés, des sujets et des intentions des locuteurs. Le modèle n'est pas conçu pour des applications de chat et ne génère pas de texte, ce qui le rend idéal pour les tâches de prise de décision.

LiquidAI d1-omni-600M est un modèle open-source, encourageant la recherche et le développement dans le domaine de l'intelligence artificielle. Il est disponible pour une utilisation avec les transformateurs version 5.15 ou supérieure, et peut être intégré dans divers pipelines nécessitant des capacités de prise de décision efficaces.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • 600M paramètres

  • Support d'entrée multimodale

  • Prise de décision en un seul passage

  • Optimisé pour le déploiement en périphérie

  • Open source

  • Encodeurs de vision et d'audio

  • Pas de génération de jetons de sortie

  • Longueur de contexte de 16 384 jetons

  1. Accéder à la page du modèle

  2. S'authentifier

  3. Configurer le modèle

  4. Envoyer des invites

  • Routage et Triage
  • Modération
  • Classification des Intentions
  • Routage des Commandes Vocales
  • Inspection Visuelle

Avis sur LiquidAI d1-omni-600M

Chargement...

Outils IA populaires comme LiquidAI d1-omni-600M

Inkling-Small est un modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…

Modèles d'IA et LLM

N°27 en LLM

Voir l'outil

Modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…Inkling-Small est un modèle multimodal polyvalent qui traite des entrées textuelles, d'images et audio pour générer des sorties textuelles. Il aide les développeurs à créer des…

Modèles d'IA et LLM
N°27 en LLM

DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir l'outil

Modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…DeepSeek-V4-Flash-Vision-Exp est un modèle multimodal expérimental de la famille DeepSeek-V4, améliorant les capacités de compréhension visuelle. Il s'appuie sur l'architecture…

Modèles d'IA et LLM
Voir le Top 50 LLM

Nemotron 3 Nano Omni est un modèle de raisonnement omni-modal développé par NVIDIA qui traite des images, des vidéos, de la parole et du texte. Il offre des capacités d'IA…

Modèles d'IA et LLM

N°5 en LLM

Voir l'outil

Modèle de raisonnement omni-modal développé par NVIDIA qui traite des images, des vidéos, de la parole et du texte. Il offre des capacités d'IA…Nemotron 3 Nano Omni est un modèle de raisonnement omni-modal développé par NVIDIA qui traite des images, des vidéos, de la parole et du texte. Il offre des capacités d'IA…

Modèles d'IA et LLM
N°5 en LLM

L'étape 3.7 Flash est un modèle de vision-langage Mixture-of-Experts (MoE) sparse conçu pour des charges de travail de production à haute fréquence. Il combine une architecture…

Modèles d'IA et LLM
Voir l'outil

L'étape 3.7 Flash est un modèle de vision-langage Mixture-of-Experts (MoE) sparse conçu pour des charges de travail de production à haute fréquence. Il combine une architecture…

Modèles d'IA et LLM
Voir le Top 50 LLM

Mistral Medium 3.5 est un modèle multimodal de classe frontier optimisé pour des cas d'utilisation agentiques et de codage. Il est publié avec des poids ouverts sous une licence…

Modèles d'IA et LLM

N°8 en LLM

Voir l'outil

Modèle multimodal de classe frontier optimisé pour des cas d'utilisation agentiques et de codage. Il est publié avec des poids ouverts sous une licence…Mistral Medium 3.5 est un modèle multimodal de classe frontier optimisé pour des cas d'utilisation agentiques et de codage. Il est publié avec des poids ouverts sous une licence…

Modèles d'IA et LLM
N°8 en LLM

Pixtral-12B-2409 est un modèle d'IA multimodal avec 12 milliards de paramètres et un encodeur de vision de 400 millions de paramètres, conçu pour des tâches avancées de traitement…

Modèles d'IA et LLM
Voir l'outil

Pixtral-12B-2409 est un modèle d'IA multimodal avec 12 milliards de paramètres et un encodeur de vision de 400 millions de paramètres, conçu pour des tâches avancées de traitement…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Apertus 1.5 est une famille de modèles linguistiques multilingues et multimodaux conçus pour prendre en charge un large éventail de langues et de contextes. Il offre un accès…

Modèles d'IA et LLM
Voir l'outil

Famille de modèles linguistiques multilingues et multimodaux conçus pour prendre en charge un large éventail de langues et de contextes. Il offre un accès…Apertus 1.5 est une famille de modèles linguistiques multilingues et multimodaux conçus pour prendre en charge un large éventail de langues et de contextes. Il offre un accès…

Modèles d'IA et LLM
Voir le Top 50 LLM

Youtu-Parsing-Omni est un modèle de parsing omni-modal polyvalent qui convertit divers types d'entrées tels que des documents, des images, des graphiques et des vidéos en JSON…

Modèles d'IA et LLM
Voir l'outil

Modèle de parsing omni-modal polyvalent qui convertit divers types d'entrées tels que des documents, des images, des graphiques et des vidéos en JSON…Youtu-Parsing-Omni est un modèle de parsing omni-modal polyvalent qui convertit divers types d'entrées tels que des documents, des images, des graphiques et des vidéos en JSON…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA
1 sur 8