Description
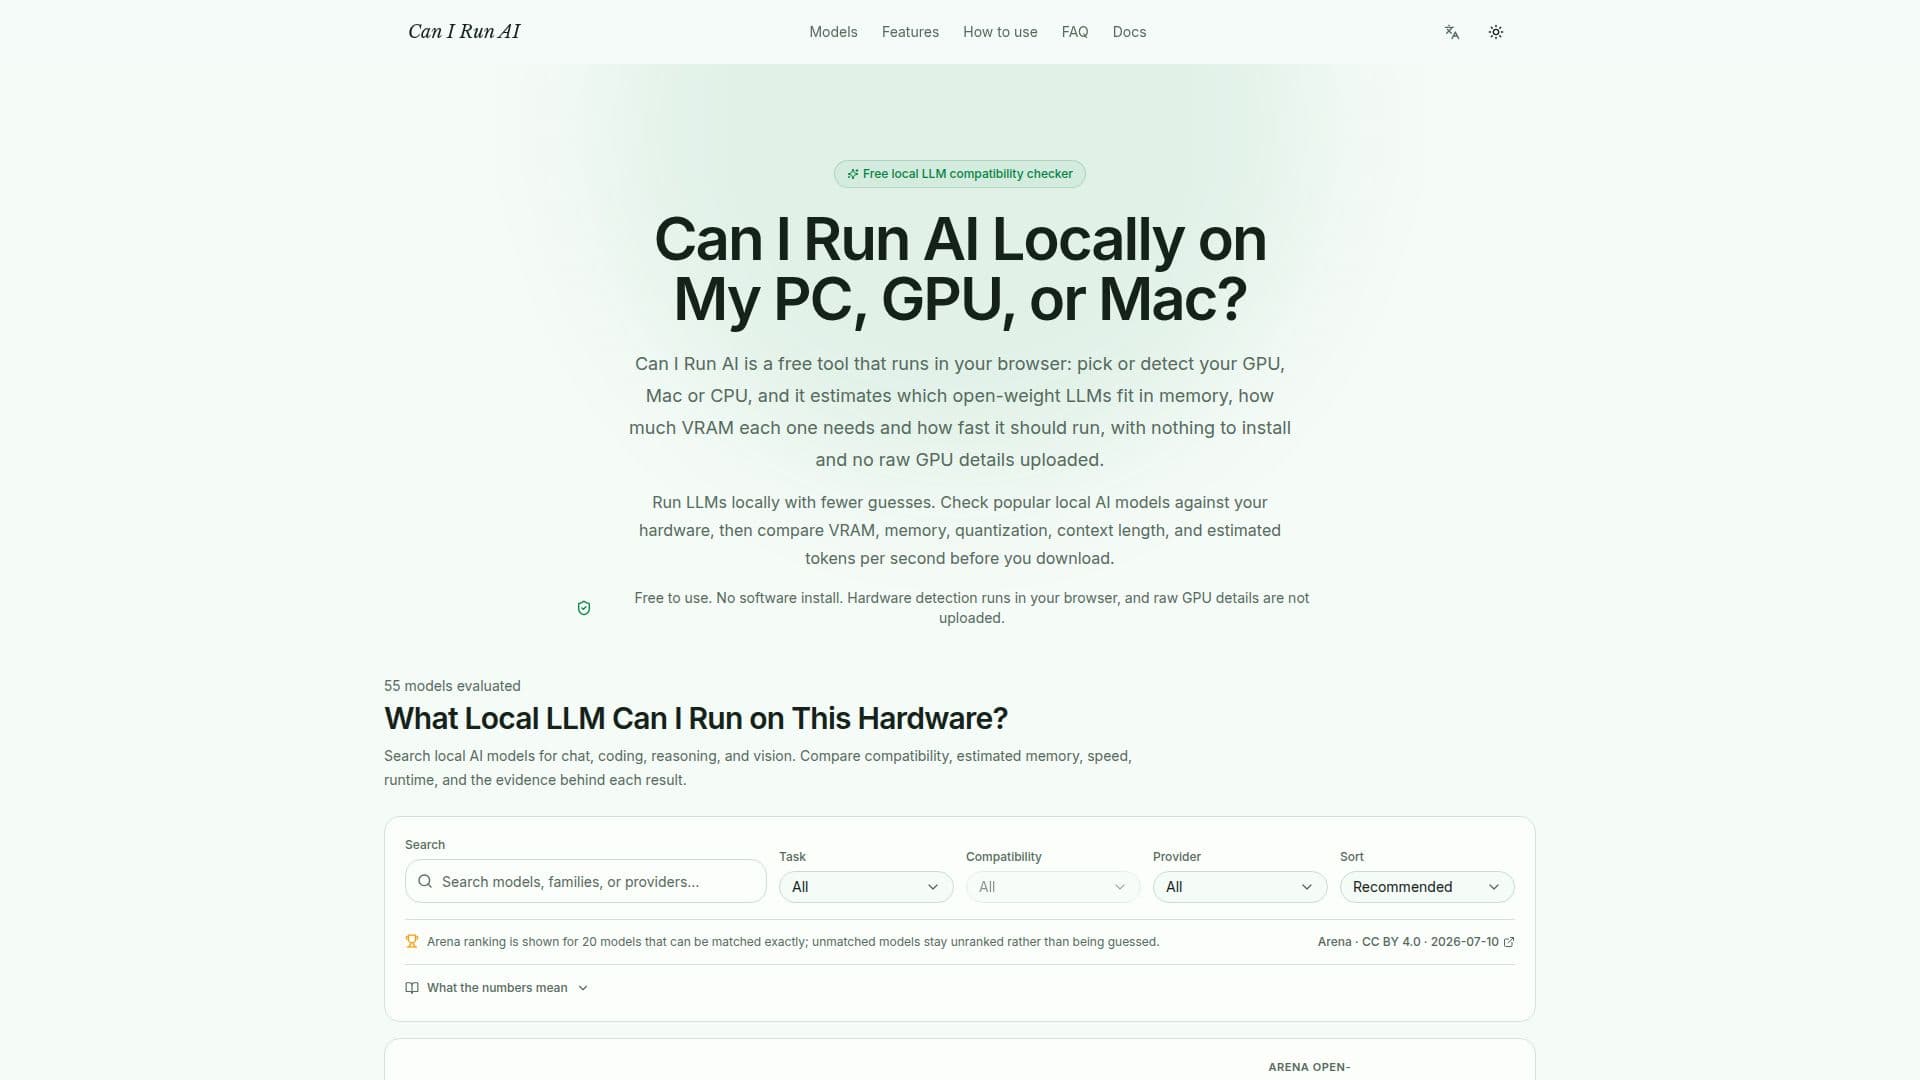
Puis-je exécuter l'IA localement ? est un outil en ligne gratuit conçu pour aider les utilisateurs à déterminer quels modèles de langage de grande taille (LLMs) leur matériel peut prendre en charge. En utilisant ce vérificateur de compatibilité basé sur le navigateur, les utilisateurs peuvent sélectionner ou détecter leur GPU, Mac ou CPU et recevoir une estimation des modèles à poids ouverts qui s'intègrent dans la mémoire. L'outil fournit des informations sur la quantité de VRAM ou de mémoire unifiée requise par chaque modèle à une quantification et une longueur de contexte données, ainsi qu'une vitesse estimée en tokens par seconde.
Lire la suite
L'outil est particulièrement utile pour ceux qui cherchent à exécuter des modèles d'IA localement sans avoir besoin d'installation de logiciel ou de création de compte. Il fonctionne entièrement dans le navigateur, garantissant que les détails bruts du GPU restent privés et ne sont pas téléchargés. Les utilisateurs peuvent comparer les exigences telles que la VRAM, la mémoire, la quantification et la longueur de contexte par rapport à leurs capacités matérielles pour prendre des décisions éclairées sur les modèles à télécharger et à exécuter.
Puis-je exécuter l'IA localement ? couvre un catalogue de 55 modèles de génération de texte à poids ouverts provenant de 12 éditeurs, y compris des modèles populaires comme Llama, Qwen, Gemma et GPT-OSS. L'outil fournit un verdict d'adéquation et une estimation de la mémoire pour chaque modèle, ainsi que des plages de vitesse attendues et des commandes d'exécution prêtes à être copiées lorsque disponibles. Le catalogue est mis à jour périodiquement pour inclure de nouveaux modèles et vérifier à nouveau les entrées existantes par rapport aux fiches de modèles officielles.
L'outil propose également des explications détaillées sur les options de quantification telles que Q4, Q5, Q8, BF16, FP8 et NVFP4, aidant les utilisateurs à comprendre les compromis en matière de mémoire et le support de précision spécifique au matériel. Il est conçu pour être un outil de planification, fournissant des estimations plutôt que des mesures précises, et encourage les utilisateurs à tester des ajustements serrés avant de s'y fier pour des tâches critiques.
- CatégoriePlateformes de machine learning
- Modèle tarifaireGratuit
- DéploiementBasé sur le navigateur
- PlateformesWeb
Fonctionnalités principales de Puis-je exécuter l'IA localement ?
Vérificateur de compatibilité basé sur le navigateur
Estime les exigences en VRAM et en mémoire
Prend en charge la détection de GPU, Mac et CPU
Fournit des options de quantification et de longueur de contexte
Offre une vitesse estimée en tokens par seconde
Aucune installation ni compte requis
Catalogue de 55 modèles à poids ouverts
Commandes d'exécution prêtes à être copiées
Comment utiliser Puis-je exécuter l'IA localement ? ?
Sélectionnez ou détectez votre matériel : Choisissez votre GPU, Mac ou CPU.
Définissez la quantification et le contexte : Ajustez ces paramètres pour votre modèle.
Examinez les estimations d'adéquation et de mémoire : Vérifiez quels modèles s'adaptent à votre matériel.
Copiez les commandes d'exécution : Utilisez les commandes fournies pour exécuter des modèles localement.
Cas d'utilisation de Puis-je exécuter l'IA localement ?
- Vérification de compatibilité des modèles
- Estimation de la VRAM et de la mémoire
- Analyse de quantification
- Estimation de la vitesse
- Exécution de modèles d'IA localement