Description
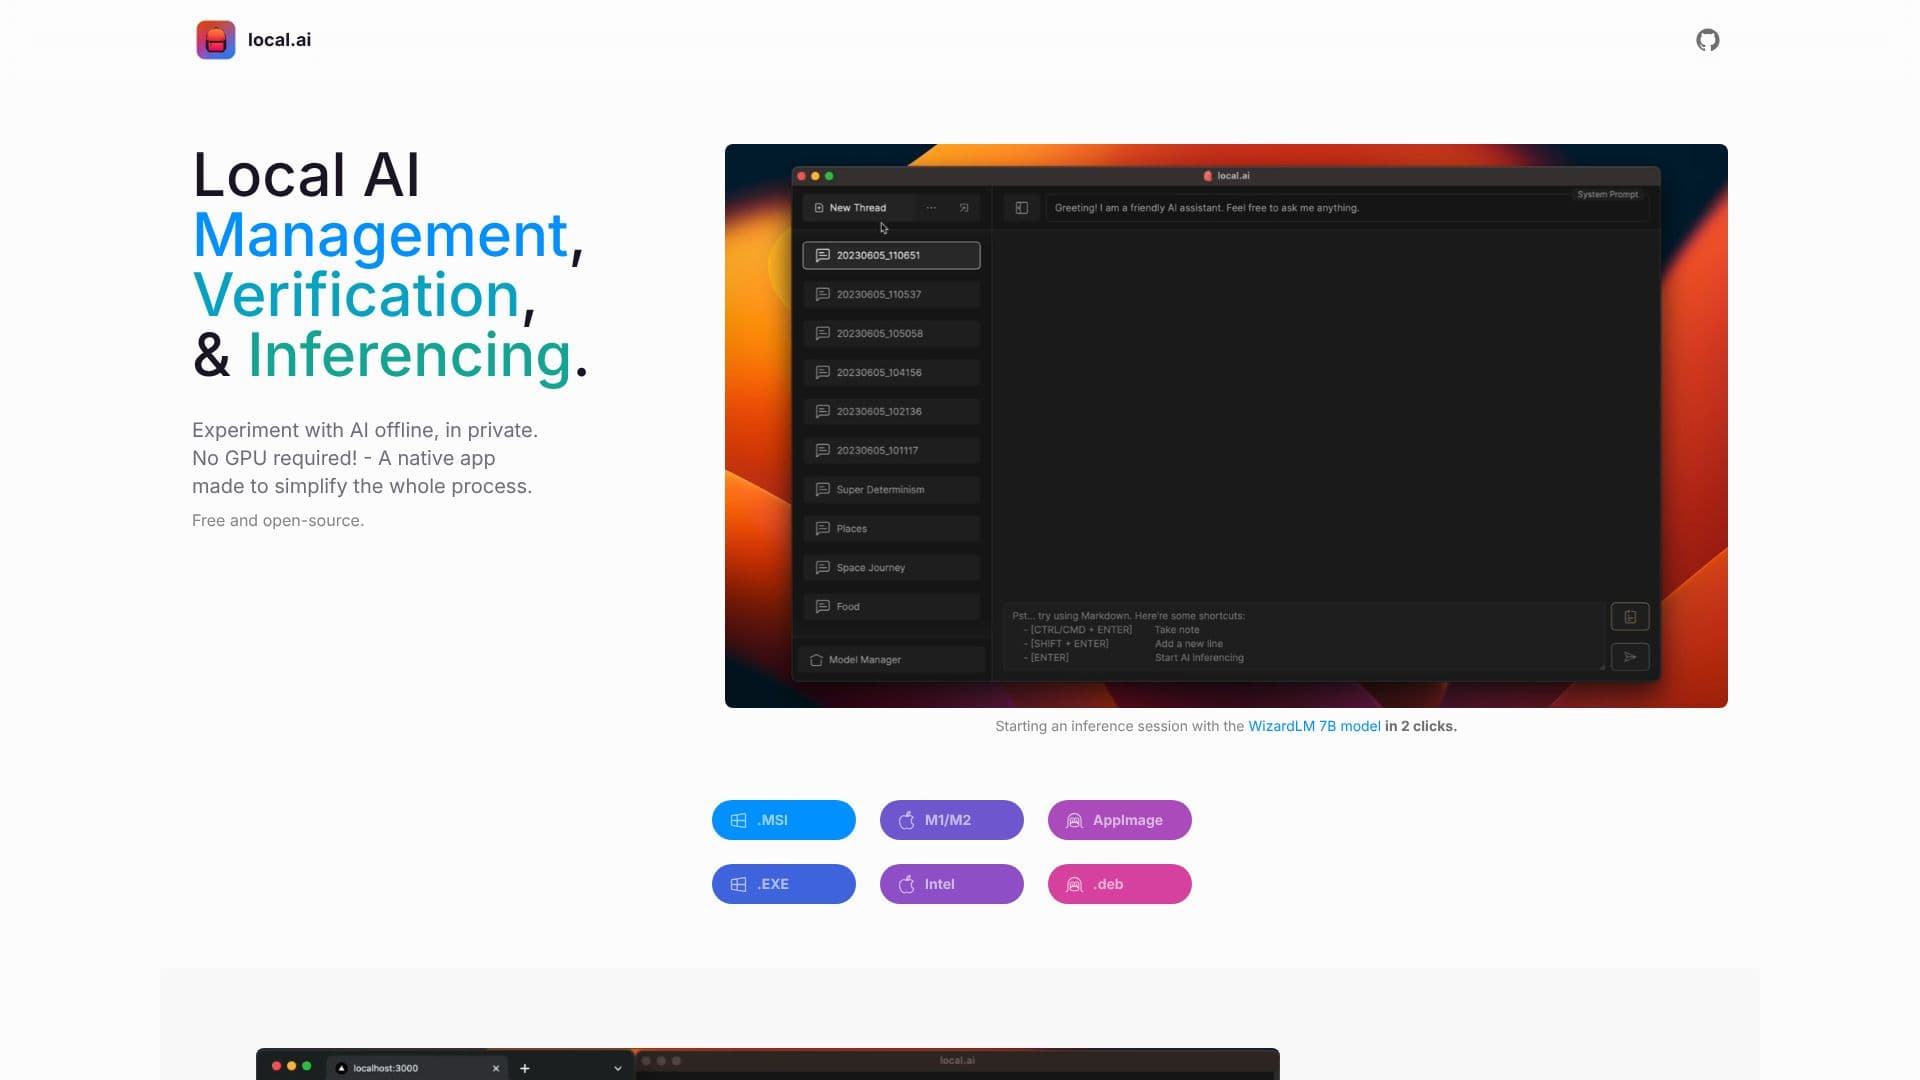
Le Local AI Playground, également connu sous le nom de local.ai, est une application native puissante, gratuite et open-source conçue pour démocratiser l'expérimentation des modèles d'IA. Elle permet aux utilisateurs d'exécuter des modèles d'IA entièrement hors ligne et en privé, éliminant le besoin de configurations techniques complexes ou de GPU dédiés. L'application est construite avec un backend Rust économe en mémoire, garantissant une empreinte compacte sur les plateformes Windows, macOS et Linux.
Lire la suite
Au cœur de son fonctionnement, le Local AI Playground se concentre sur la simplification de l'ensemble du processus d'inférence IA. Les utilisateurs peuvent démarrer une session d'inférence avec des modèles populaires en quelques clics seulement. La plateforme prend en charge l'inférence CPU, s'adapte aux threads disponibles et offre diverses options de quantification GGML telles que q4, 5.1, 8 et f16. Des mises à jour futures sont prévues pour inclure l'inférence GPU et les capacités de sessions parallèles.
La gestion des modèles est une fonctionnalité clé, offrant un emplacement centralisé pour suivre tous les modèles d'IA téléchargés. Les utilisateurs peuvent pointer l'application vers n'importe quel répertoire contenant leurs modèles. Les fonctionnalités actuelles incluent un téléchargeur concurrent et résumable, ainsi qu'un tri basé sur l'utilisation. Les améliorations à venir introduiront la prise en charge des répertoires imbriqués et des fonctionnalités de tri et de recherche personnalisées.
Assurer l'intégrité des modèles téléchargés est primordial. Le Local AI Playground intègre une fonctionnalité robuste de vérification de digests, prenant en charge les calculs BLAKE3 et SHA256. Les fonctionnalités disponibles incluent le calcul de digests, une API de modèles connus, des puces de licence et d'utilisation, des vérifications rapides BLAKE3 et des cartes d'informations sur les modèles. La feuille de route comprend un explorateur de modèles, une recherche de modèles et des fonctionnalités de recommandation de modèles.
Pour les développeurs et les passionnés souhaitant intégrer l'IA dans leurs applications, le Local AI Playground propose un serveur d'inférence. Ce serveur peut être démarré en deux clics : charger un modèle et démarrer le serveur. Il prend en charge les capacités de serveur de streaming, une interface utilisateur d'inférence rapide et écrit dans des fichiers .mdx. Les paramètres d'inférence et le vocabulaire distant sont également pris en charge, avec des plans futurs pour la gestion du serveur et la prise en charge des points d'accès /audio et /image.
Le Local AI Playground est idéal pour les chercheurs en IA, les développeurs, les étudiants et les amateurs qui souhaitent expérimenter avec des modèles d'IA sans les barrières des coûts cloud ou des exigences matérielles complexes. Son interface conviviale et son ensemble de fonctionnalités robustes en font un outil accessible pour quiconque s'intéresse à l'inférence et à la gestion locale de l'IA.
- CatégoriePlateformes de machine learning
- Modèle tarifaireGratuit
- DéploiementApplication native
- PlateformesWindows, macOS, Linux
Fonctionnalités principales de Local AI Playground
Exécuter des modèles d'IA hors ligne et en privé
Aucun GPU requis pour l'inférence CPU
Application native gratuite et open-source
Backend Rust économe en mémoire
Taille d'application compacte (<10 Mo sur Mac M2, Windows, Linux .deb)
Démarrage simplifié de session d'inférence en 2 clics
Inférence CPU avec threads adaptatifs
Prise en charge de la quantification GGML (q4, 5.1, 8, f16)
Gestion centralisée des modèles avec sélection de répertoire
Téléchargeur de modèles concurrent et résumable
Vérification de digests (BLAKE3, SHA256) pour l'intégrité des modèles
Serveur d'inférence de streaming local
Interface utilisateur d'inférence rapide
Écrit les résultats d'inférence dans des fichiers .mdx
Prend en charge les paramètres d'inférence et le vocabulaire distant
Comment utiliser Local AI Playground ?
Télécharger et installer l'application native pour votre OS
Configurer le répertoire des modèles
Sélectionner et charger un modèle d'IA
Démarrer une session d'inférence ou un serveur de streaming
Expérimenter avec des modèles d'IA localement
Vérifier l'intégrité des modèles à l'aide du calcul de digests
Cas d'utilisation de Local AI Playground
- Expérimentation IA Locale
- Inférence IA Privée
- Gestion de Modèles IA
- Développement d'Applications IA
- Apprentissage des Modèles IA
- Utilisation IA Hors Ligne