Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

llmspeed

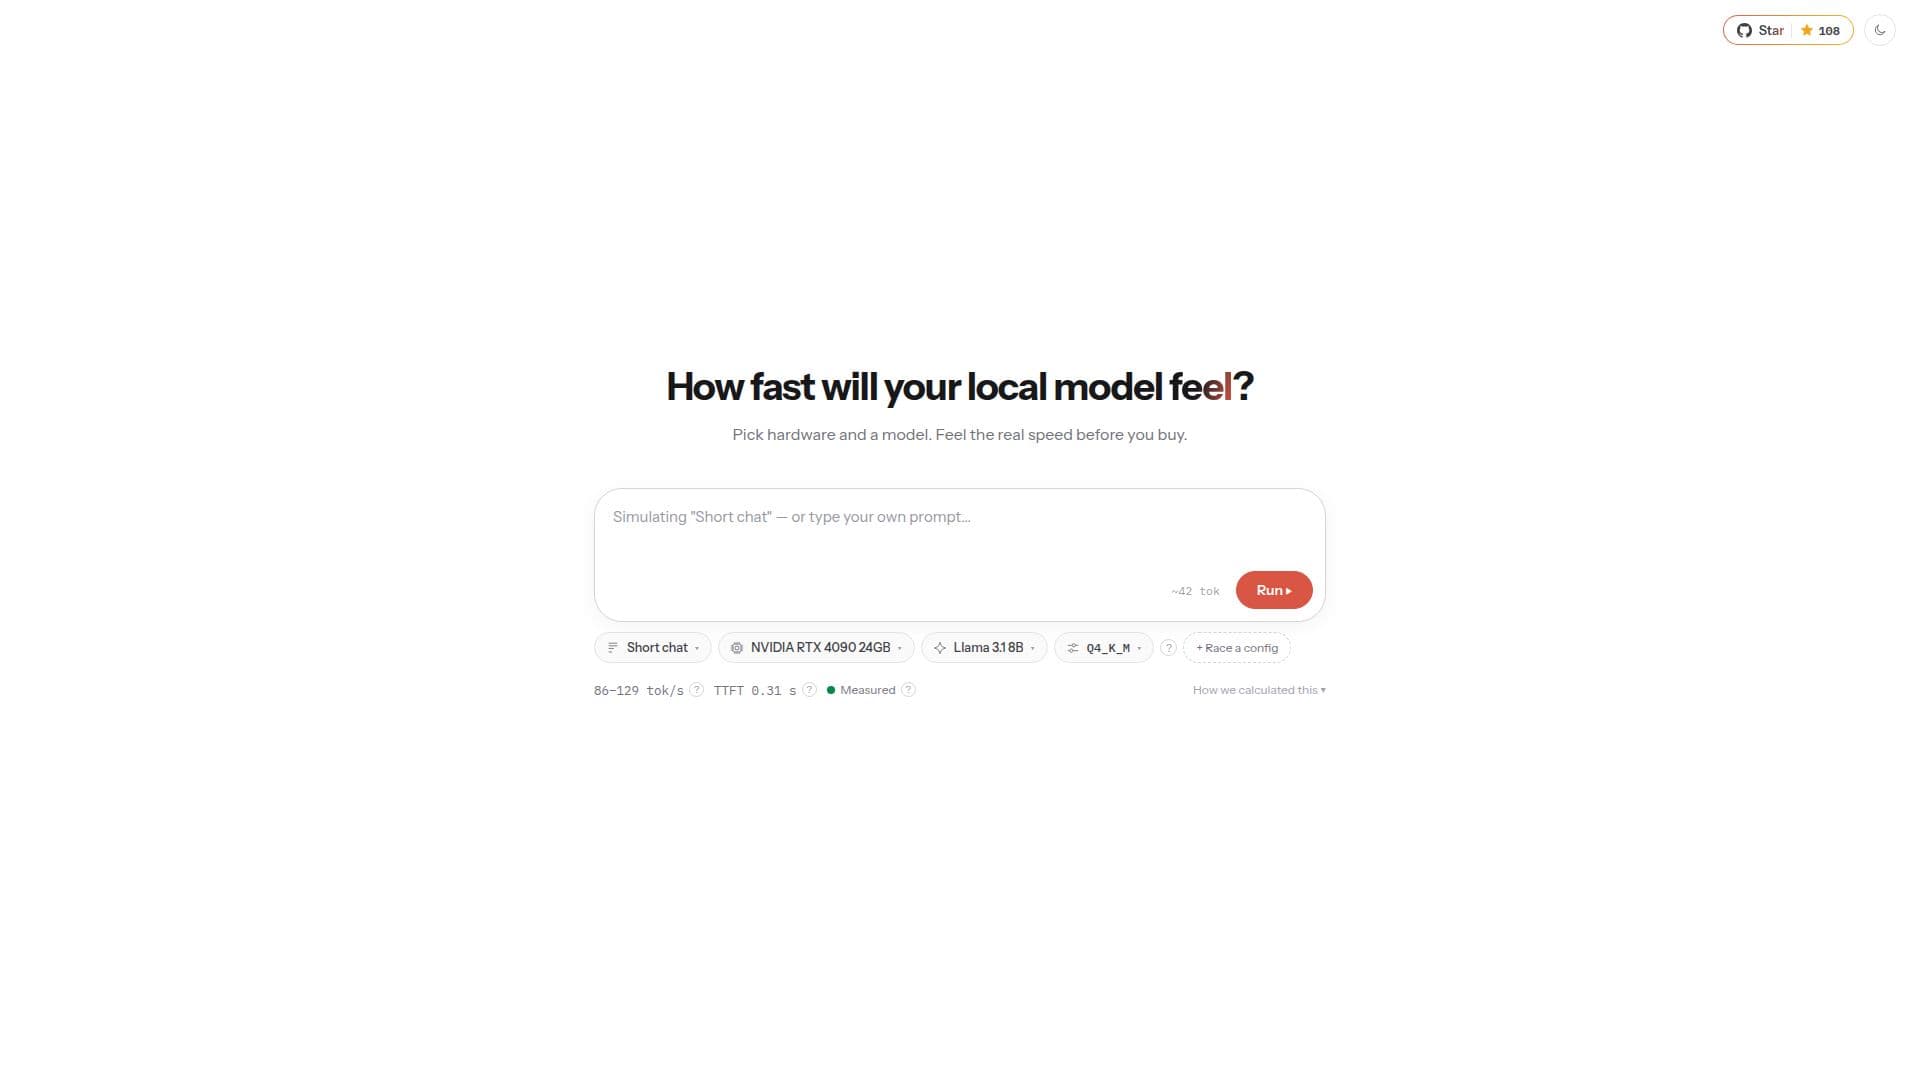
llmspeed permet aux utilisateurs de simuler la vitesse des LLM locaux avant d'acheter. En sélectionnant le matériel et les modèles, les utilisateurs peuvent expérimenter des métriques de performance en temps réel, y compris les tokens par seconde et le temps jusqu'au premier token, basés sur des benchmarks vérifiés.

Visiter l'URL
Partager
Capture d’écran de llmspeed

llmspeed est un outil unique conçu pour aider les utilisateurs à évaluer la performance des grands modèles de langage locaux (LLM) avant de faire un achat. En permettant aux utilisateurs de sélectionner du matériel et des modèles spécifiques, llmspeed fournit une simulation de métriques de performance en temps réel, telles que les tokens par seconde et le temps jusqu'au premier token. Cette simulation est fondée sur des benchmarks vérifiés provenant de diverses sources, garantissant précision et fiabilité.

Lire la suite

La plateforme prend en charge une large gamme d'options matérielles, y compris les GPU NVIDIA, les processeurs AMD et les Macs d'Apple, entre autres. Les utilisateurs peuvent choisir parmi des modèles tels que Qwen, GLM, Gemma et GPT-OSS, offrant une expérience d'évaluation complète. La nature open-source de llmspeed, disponible sur GitHub, permet des contributions communautaires et une transparence.

Avec un modèle de tarification fixé à 0 USD, llmspeed est accessible à tous les utilisateurs intéressés par la compréhension de la vitesse potentielle de leurs LLM locaux. Cet outil est particulièrement bénéfique pour les développeurs, les chercheurs et les passionnés d'IA qui nécessitent des informations précises sur la performance avant d'investir dans du matériel ou des modèles spécifiques.

Dans l'ensemble, llmspeed offre un service précieux en comblant le fossé entre les capacités matérielles et la performance des modèles, permettant des décisions d'achat éclairées et optimisant les flux de travail en IA.

  • CatégorieMLOps et déploiement de modèles
  • Modèle tarifaireGratuit
  • DéploiementCloud
  • PlateformesWeb

  • Simule les tokens par seconde

  • Calcule le temps jusqu'au premier token

  • Prend en charge plusieurs options matérielles

  • Inclut divers modèles de LLM

  • Basé sur des benchmarks vérifiés

  • Open-source sur GitHub

  • Gratuit à utiliser

  • Perspectives communautaires

  1. Sélectionner le matériel : Choisissez parmi une variété d'appareils pris en charge

  2. Sélectionner le modèle : Choisissez un modèle de LLM à tester

  3. Simuler : Exécutez la simulation pour voir les métriques de performance

  4. Évaluer : Analysez les résultats pour prendre des décisions éclairées

  • Évaluation du matériel
  • Comparaison de modèles
  • Évaluation de performance
  • Recherche et développement
  • Optimisation des flux de travail en IA
Avis sur llmspeed

Chargement...

Outils IA populaires comme llmspeed

CanIRun.ai

Applications IA

Un outil gratuit qui détecte votre GPU ou Mac et montre quels modèles d'IA ouverts, y compris les LLM, les modèles de codage, d'image et de vidéo, vous pouvez exécuter localement,…

Machine learning et data science

N°45 en Machine learning et data science

Voir l'outil

Applications IA

Un outil gratuit qui détecte votre GPU ou Mac et montre quels modèles d'IA ouverts, y compris les LLM, les modèles de codage, d'image et de vidéo, vous pouvez exécuter localement,…

Machine learning et data science
N°45 en Machine learning et data science

ComputeArena

Applications IA

ComputeArena fournit une plateforme pour les benchmarks d'IA locaux soumis par la communauté. Elle permet aux utilisateurs de comparer les performances entre différents modèles,…

Machine learning et data science
Voir l'outil

Applications IA

Fournit une plateforme pour les benchmarks d'IA locaux soumis par la communauté. Elle permet aux utilisateurs de comparer les performances entre différents modèles,…ComputeArena fournit une plateforme pour les benchmarks d'IA locaux soumis par la communauté. Elle permet aux utilisateurs de comparer les performances entre différents modèles,…

Machine learning et data science
Voir le Top 250 Applications IA

vLLM

Applications IA

vLLM est un moteur d'inférence et de service à haut débit et économe en mémoire pour les grands modèles de langage (LLMs). Il permet un déploiement plus rapide des modèles d'IA…

MLOps et déploiement de modèles
Voir l'outil

Applications IA

Moteur d'inférence et de service à haut débit et économe en mémoire pour les grands modèles de langage (LLMs). Il permet un déploiement plus rapide des modèles d'IA…vLLM est un moteur d'inférence et de service à haut débit et économe en mémoire pour les grands modèles de langage (LLMs). Il permet un déploiement plus rapide des modèles d'IA…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

Le Chercheur LLM pour Ordinateur Portable aide à déterminer si votre ordinateur portable peut exécuter Qwen3.8-27B ou DeepSeek-V4-Flash-0731 sur un seul CPU. Il fournit des…

Modèles d'IA et LLM
Voir l'outil

Dreamscale Labs

Applications IA

Dreamscale Labs propose une inférence cloud en temps réel pour l'IA physique, permettant aux équipes de robotique de déployer et d'évaluer des modèles sans avoir besoin de GPU…

Robotique et matériel IA

N°179 en Outils DevOps et cloud IA

Voir l'outil

Applications IA

Propose une inférence cloud en temps réel pour l'IA physique, permettant aux équipes de robotique de déployer et d'évaluer des modèles sans avoir besoin de GPU…Dreamscale Labs propose une inférence cloud en temps réel pour l'IA physique, permettant aux équipes de robotique de déployer et d'évaluer des modèles sans avoir besoin de GPU…

Robotique et matériel IA
N°179 en Outils DevOps et cloud IA

Calcul Général

Applications IA

Un fournisseur d'inférence AI à haute vitesse qui sert des modèles sur une infrastructure ASIC conçue sur mesure via une API compatible OpenAI, offrant un faible temps jusqu'au…

MLOps et déploiement de modèles
Voir l'outil

Applications IA

Un fournisseur d'inférence AI à haute vitesse qui sert des modèles sur une infrastructure ASIC conçue sur mesure via une API compatible OpenAI, offrant un faible temps jusqu'au…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

gpt-oss comprend deux modèles de langage à poids ouverts, gpt-oss-120b et gpt-oss-20b, conçus pour des performances élevées et un déploiement efficace. Ils sont disponibles sous…

Modèles d'IA et LLM
Voir l'outil

gpt-oss comprend deux modèles de langage à poids ouverts, gpt-oss-120b et gpt-oss-20b, conçus pour des performances élevées et un déploiement efficace. Ils sont disponibles sous…

En vedetteModèles d'IA et LLM
Voir le Top 50 LLM

ZETIC Melange

Applications IA

ZETIC Melange automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…

MLOps et déploiement de modèles

N°138 en MLOps et déploiement de modèles

Voir l'outil

Applications IA

Automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…ZETIC Melange automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…

MLOps et déploiement de modèles
N°138 en MLOps et déploiement de modèles
1 sur 8