

Description
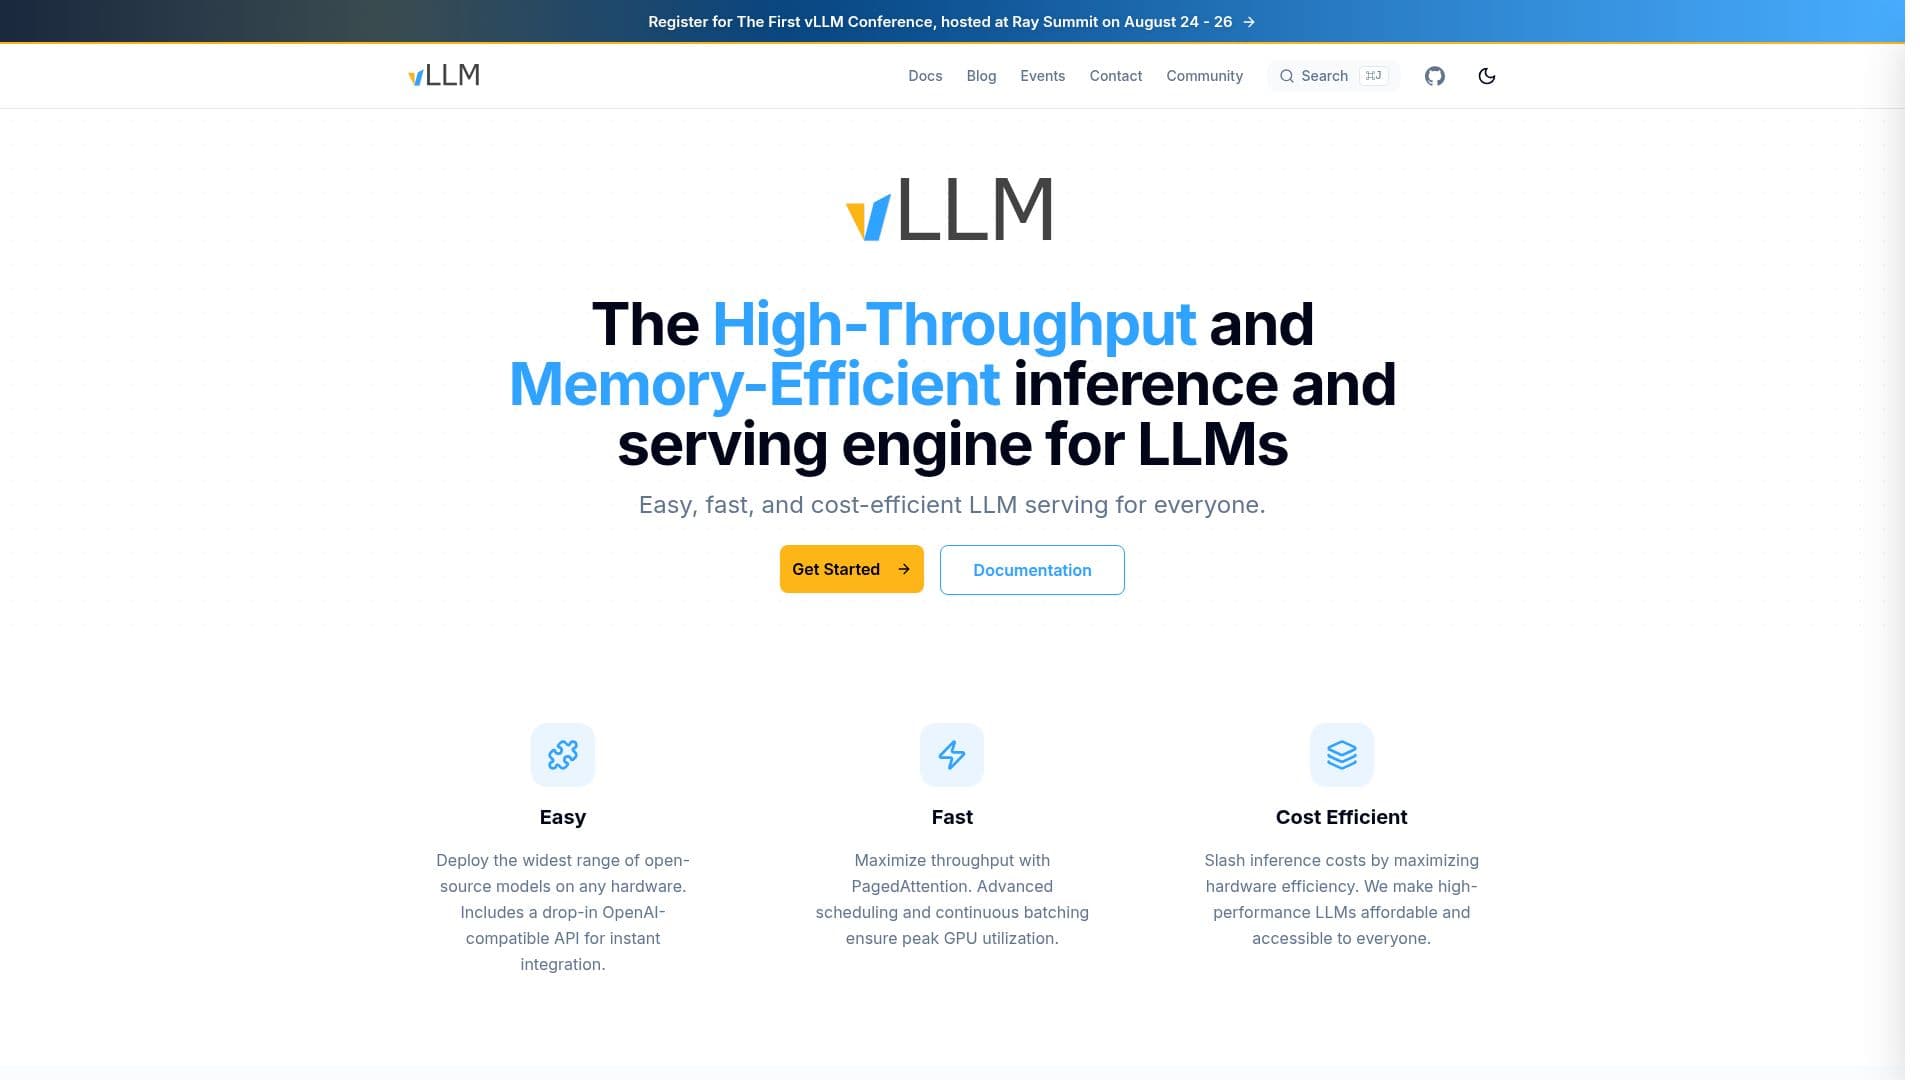
vLLM est conçu pour optimiser l'inférence et le service des grands modèles de langage (LLMs) en mettant l'accent sur un haut débit et une efficacité mémoire. Ce moteur utilise des techniques avancées telles que des noyaux GEMM/MoE optimisés pour diverses précisions, en utilisant des frameworks comme CUTLASS et TRTLLM-GEN.
Lire la suite
L'objectif de vLLM est de fournir une expérience fluide pour le déploiement des modèles d'IA, garantissant que les utilisateurs peuvent atteindre des performances de pointe sans les complexités généralement associées au service LLM.
La plateforme est construite pour une compatibilité universelle, lui permettant de s'intégrer à diverses configurations matérielles, y compris le support des GPU NVIDIA, des GPU AMD et des TPU Google. Cette flexibilité fait de vLLM un choix idéal pour les développeurs et les organisations cherchant à mettre en œuvre des solutions d'IA dans différents environnements. Les utilisateurs peuvent rapidement commencer à utiliser vLLM avec une configuration minimale, grâce à son processus de configuration simple.
vLLM propose également une approche axée sur la communauté, avec des forums disponibles pour que les utilisateurs discutent de sujets allant du support matériel à l'intégration de modèles. Cet environnement collaboratif favorise le partage des connaissances et aide les utilisateurs à optimiser leur utilisation de la plateforme. De plus, vLLM prend en charge une large gamme de modèles, y compris des architectures populaires comme Llama, BART et GPT, entre autres.
En résumé, vLLM se distingue comme un outil puissant pour quiconque cherchant à déployer des LLM de manière efficace. Sa combinaison de performances, de facilité d'utilisation et de soutien communautaire en fait une ressource précieuse dans le domaine en évolution rapide de l'IA.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireOpen Source
- DéploiementCloud
- PlateformesNVIDIA, AMD, Google TPU
Fonctionnalités principales de vLLM
Haut Débit
Efficacité Mémoire
Compatibilité Universelle
Noyaux GEMM/MoE Optimisés
Support pour Matériel Multiple
Forums Communautaires
Configuration de Démarrage Rapide
Large Support de Modèles
Comment utiliser vLLM ?
Configurer : Configurez votre environnement matériel pour prendre en charge vLLM.
Installer : Suivez les instructions d'installation fournies dans la documentation.
Déployer : Chargez votre modèle d'IA souhaité dans le moteur vLLM.
Optimiser : Ajustez les configurations pour les performances en fonction de votre cas d'utilisation spécifique.
Cas d'utilisation de vLLM
- Déploiement de Modèles d'IA
- Optimisation des Performances
- Engagement Communautaire
- Intégration de Modèles Personnalisés
- Compatibilité Multi-Plateforme






