Descripción
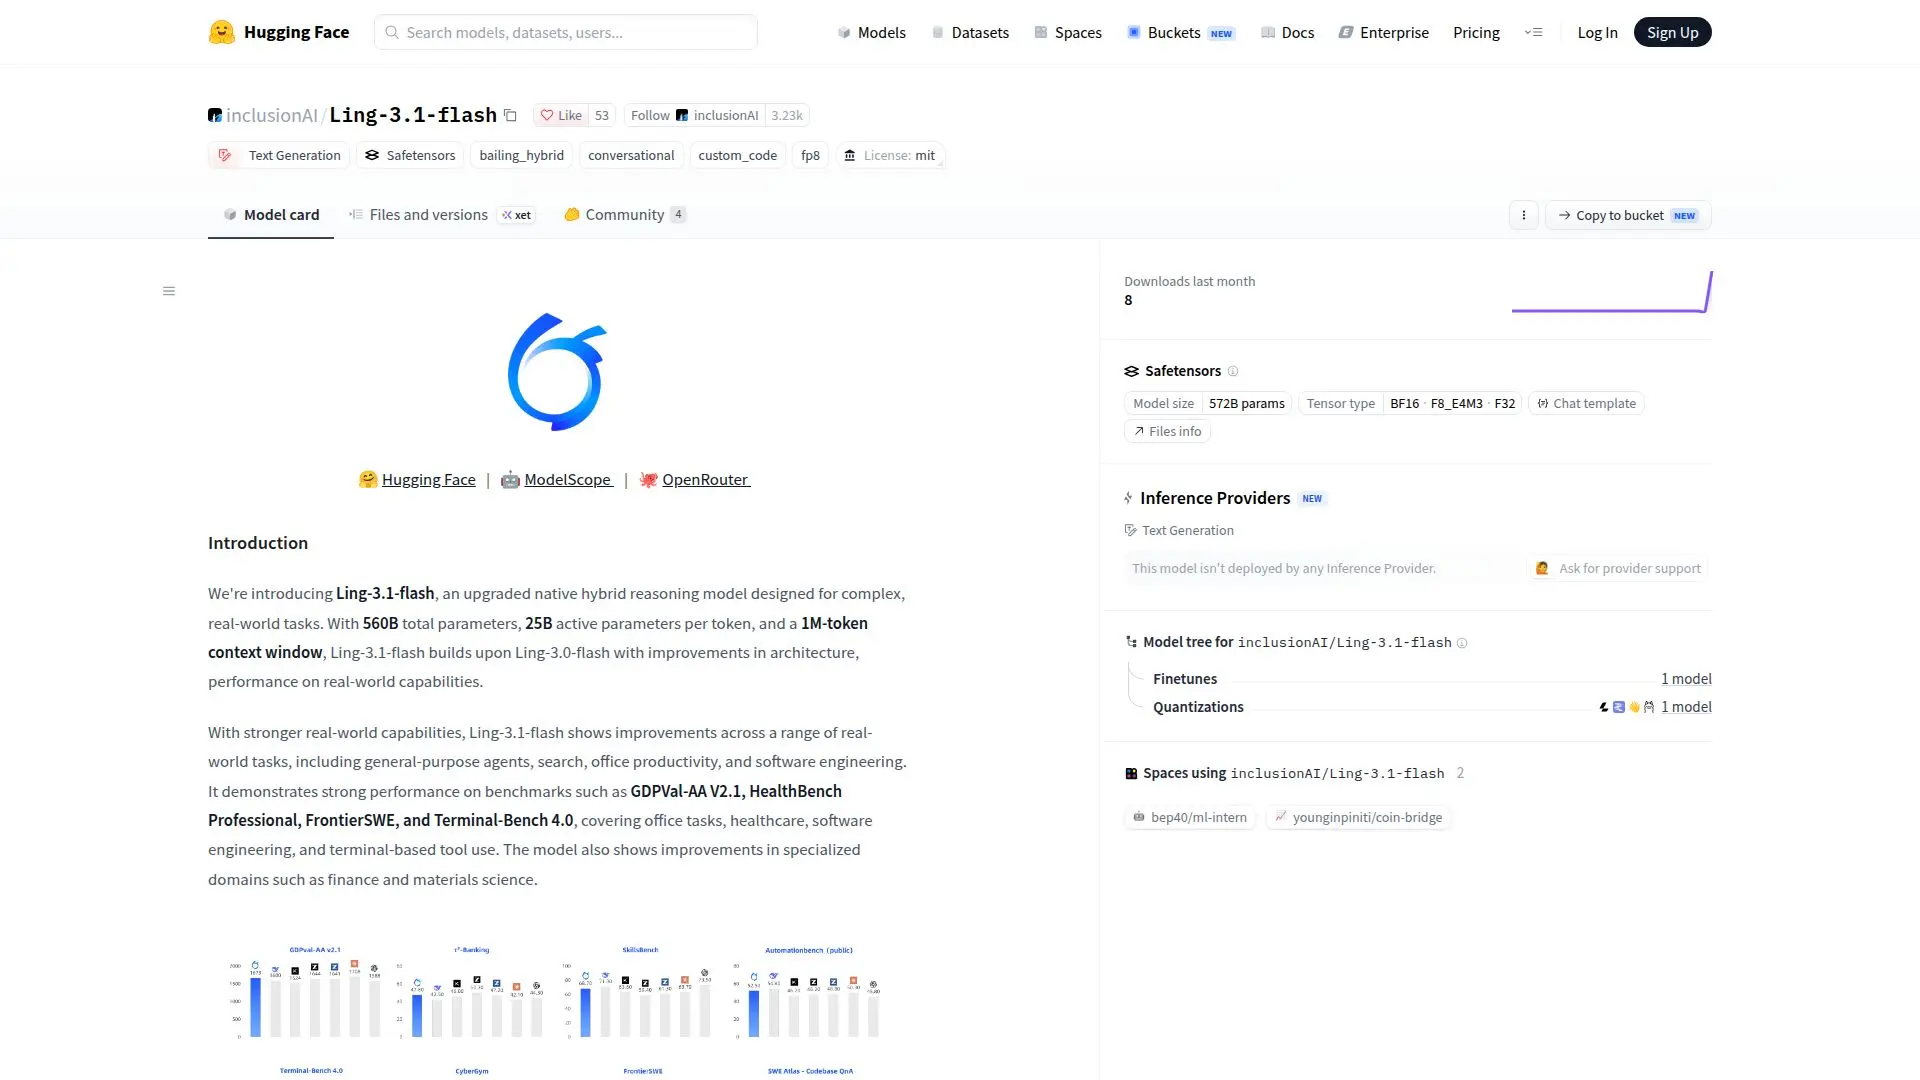
Ling-3.1-flash es un modelo nativo de razonamiento híbrido mejorado introducido por inclusionAI en la plataforma Hugging Face. Diseñado para abordar tareas complejas del mundo real, este modelo cuenta con un total de 560 mil millones de parámetros, con 25 mil millones de parámetros activos por token y una ventana de contexto de 1 millón de tokens. Estas mejoras se basan en su predecesor, Ling-3.0-flash, ofreciendo una arquitectura y rendimiento mejorados.
Leer más
El modelo sobresale en una variedad de aplicaciones del mundo real, como agentes de propósito general, búsqueda, productividad en la oficina e ingeniería de software. Ha demostrado un rendimiento sólido en benchmarks como GDPVal-AA V2.1, HealthBench Professional, FrontierSWE y Terminal-Bench 4.0. Estos benchmarks cubren una amplia gama de tareas, incluyendo tareas de oficina, salud, ingeniería de software y uso de herramientas basadas en terminal. Además, Ling-3.1-flash muestra mejoras notables en dominios especializados como finanzas y ciencia de materiales.
La arquitectura de Ling-3.1-flash se basa en un modelo híbrido-lineal de mezcla de expertos (MoE), con 63 KDA y 9 capas de transformadores Gated MLA, 4 capas densas y 512 expertos enrutados. El modelo también incluye 64 cabezas de atención y un tamaño oculto de 4096, con un tamaño de vocabulario de 157,184.
Ling-3.1-flash ha sido evaluado en múltiples benchmarks autorizados, mostrando su sólido rendimiento en tareas de codificación y tareas agénticas. Soporta marcos como Claude Code, Kilo Code, Qwen Code, Hermes Agent y OpenClaw. El modelo también introduce LingCode, un arnés construido sobre el agente de codificación de código abierto Pi, que mejora el rendimiento en tareas de codificación complejas y de largo plazo.
Para los usuarios que buscan comenzar, la imagen recomendada de SGLang incluye soporte para Ling-3.1-flash, decodificación especulativa MTP y optimizaciones de decodificación Hopper. El modelo está disponible para inferencia en varias configuraciones de servidor, y se proporcionan recetas verificadas para diferentes configuraciones de hardware.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de Ling-3.1-flash
560B parámetros en total
Ventana de contexto de 1M tokens
Arquitectura híbrido-lineal MoE
63 KDA + 9 capas Gated MLA
512 expertos enrutados
64 cabezas de atención
Soporta múltiples marcos
Rendimiento sólido en benchmarks
Primeros pasos con Ling-3.1-flash
Acceder a la página del modelo: Visitar Hugging Face
Autenticarse: Iniciar sesión en su cuenta
Configurar: Configurar el entorno del servidor o cliente
Enviar solicitudes: Usar recetas verificadas para la inferencia
Casos de uso de Ling-3.1-flash
- Agentes de propósito general
- Productividad en la oficina
- Ingeniería de software
- Aplicaciones de salud
- Análisis financiero