Descripción
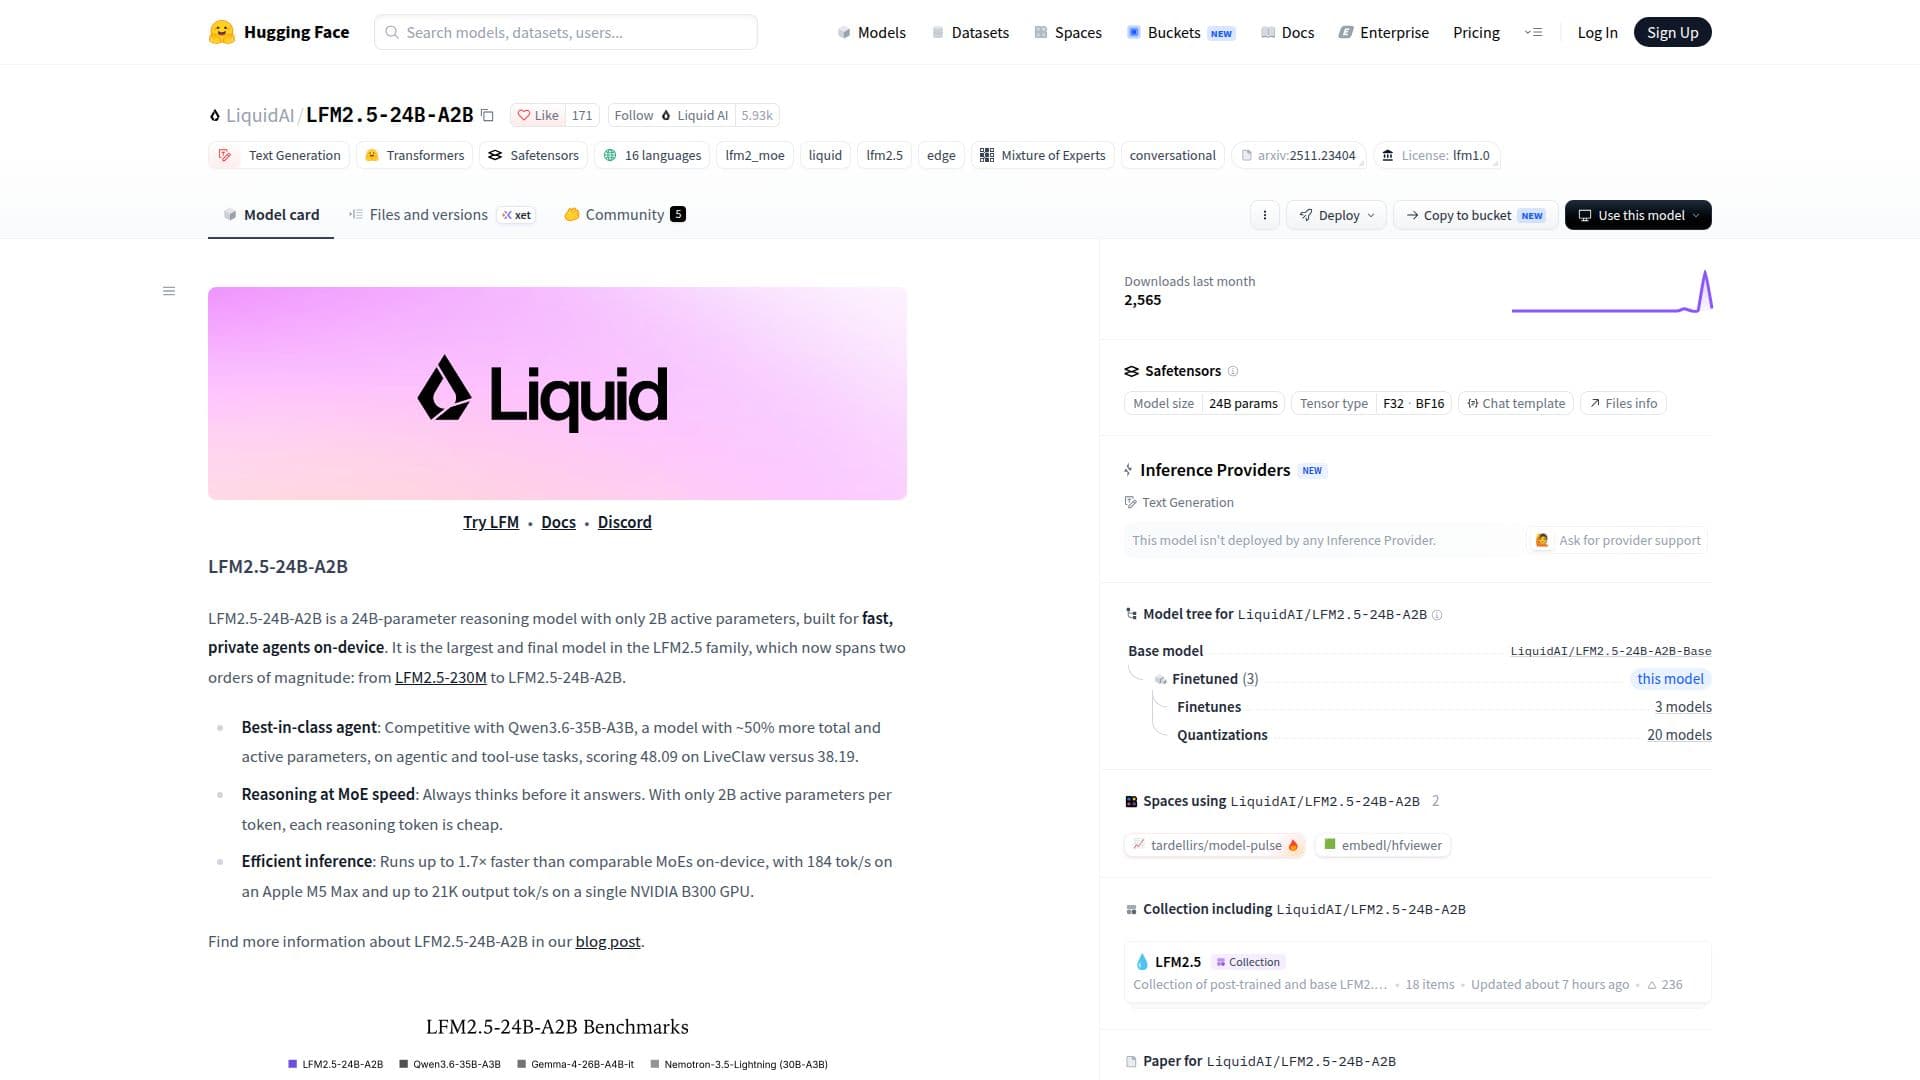
LiquidAI LFM2.5-24B-A2B es un modelo de razonamiento de última generación diseñado para operar de manera eficiente con solo 2B de parámetros activos de un total de 24B. Este modelo es parte de la familia LFM2.5 y está adaptado para aplicaciones rápidas y privadas en el dispositivo. Destaca en tareas de uso de herramientas y agentes, demostrando un rendimiento competitivo frente a modelos más grandes como Qwen3.6-35B-A3B.
Leer más
El modelo está diseñado para una inferencia eficiente, funcionando hasta 1.7 veces más rápido que modelos comparables en dispositivos como el Apple M5 Max y la GPU NVIDIA B300. Soporta una amplia gama de idiomas, incluyendo inglés, árabe, chino y más, lo que lo hace versátil para aplicaciones multilingües.
LFM2.5-24B-A2B está disponible en varios formatos, incluyendo FP8 para servicio GPU de alto rendimiento, GGUF para inferencia en CPU y ONNX para implementación multiplataforma. Esta flexibilidad permite su integración en diversos entornos, desde la nube hasta el borde y dispositivos móviles.
El modelo es particularmente adecuado para aplicaciones que requieren capacidades de razonamiento y llamada a herramientas. Soporta la llamada a funciones en un proceso estructurado de cuatro pasos, mejorando su utilidad en flujos de trabajo de agentes. Sin embargo, no se recomienda para tareas que requieren mucho conocimiento sin capacidades de recuperación o búsqueda en la web suplementarias.
Para los desarrolladores, LFM2.5-24B-A2B ofrece amplias opciones de ajuste fino, incluyendo ajuste fino supervisado y optimización de preferencias directas utilizando marcos como Unsloth y TRL. El rendimiento del modelo ha sido evaluado en diversas tareas, mostrando consistentemente alta eficiencia y velocidad.
En general, LiquidAI LFM2.5-24B-A2B es una opción robusta para desarrolladores que buscan un modelo de razonamiento potente y eficiente para aplicaciones en el dispositivo.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube, Local (on-premises)
- PlataformasWeb, Windows, macOS
Aspectos destacados de LiquidAI LFM2.5-24B-A2B
24B parámetros totales
2B parámetros activos
Inferencia eficiente en el dispositivo
Soporta múltiples idiomas
Capacidades de llamada a herramientas
Disponible en múltiples formatos
Soporte para ajuste fino
Inferencia GPU de alta velocidad
Primeros pasos con LiquidAI LFM2.5-24B-A2B
Acceder a la página del modelo: Visita la página del modelo en Hugging Face
Autenticarse: Inicia sesión en tu cuenta de Hugging Face
Configurar: Configura el modelo para tu caso de uso específico
Enviar indicaciones: Utiliza el modelo para tareas de razonamiento
Ajustar: Personaliza el modelo con tus datos
Casos de uso de LiquidAI LFM2.5-24B-A2B
- Soporte Multilingüe
- Agentes en el Dispositivo
- Flujos de Trabajo de Llamada a Herramientas
- Implementación Multiplataforma
- Aplicaciones de Ajuste Fino