Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 es un modelo de lenguaje eficiente y escaso de Mixture-of-Experts (MoE) con 280 mil millones de parámetros en total. Preentrenado en 33.5 billones de tokens, admite ajuste fino e inferencia con un contexto de 1 millón de tokens. Este modelo está diseñado para diversas aplicaciones, incluyendo adaptación de dominio, ajuste de instrucciones e investigación en aprendizaje por refuerzo, ofreciendo un rendimiento sólido en múltiples benchmarks.

Visitar URL
Compartir
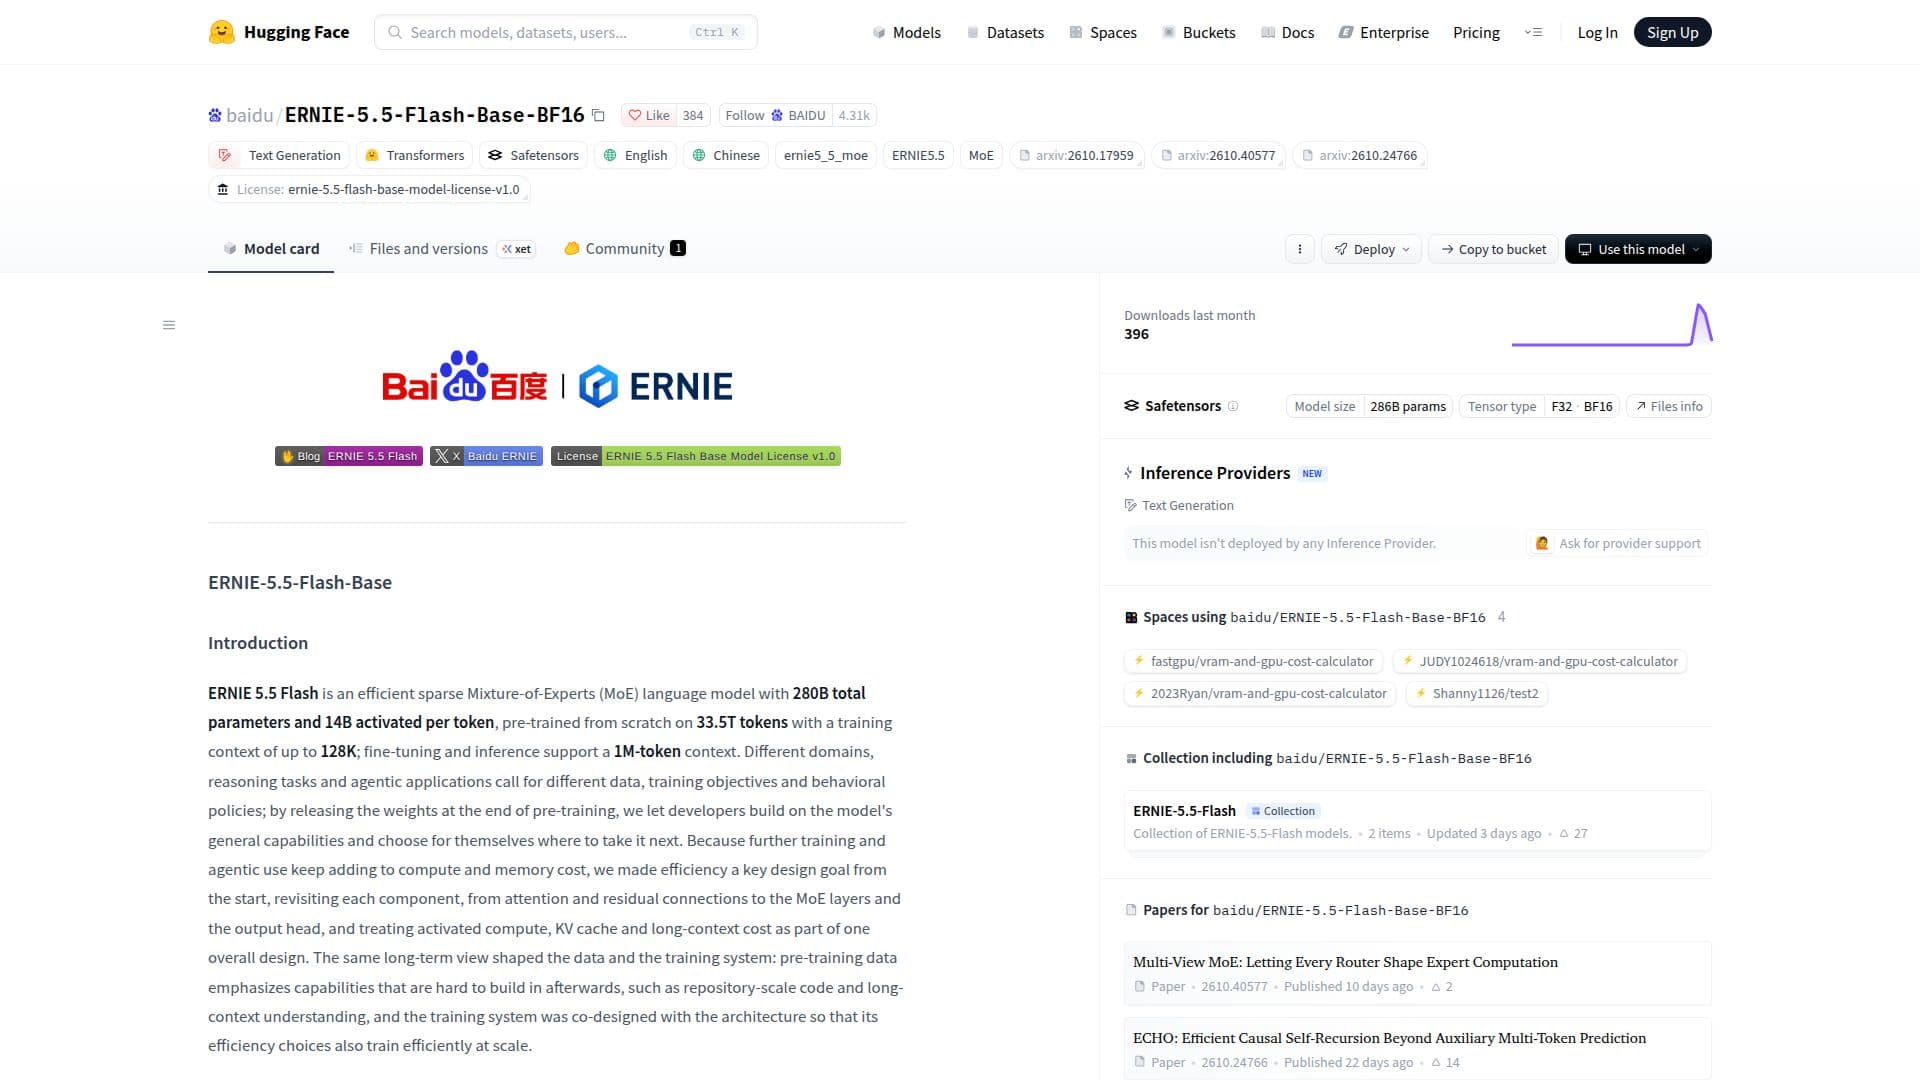
Captura de pantalla de ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 es un sofisticado modelo de lenguaje escaso de Mixture-of-Experts (MoE) desarrollado por Baidu. Cuenta con un total sustancial de 280 mil millones de parámetros, con 14 mil millones activados por token, lo que lo hace altamente eficiente para tareas complejas de lenguaje. El modelo fue preentrenado desde cero en un extenso conjunto de datos de 33.5 billones de tokens, utilizando un contexto de entrenamiento de hasta 128,000 tokens. Para el ajuste fino y la inferencia, admite una impresionante longitud de contexto de 1 millón de tokens, lo que permite una comprensión profunda y generación de contenido extenso.

Leer más

Diseñado con la eficiencia como principio fundamental, ERNIE 5.5 Flash revisita cada componente, desde mecanismos de atención y conexiones residuales hasta capas de MoE y la cabeza de salida. Este enfoque holístico asegura un rendimiento óptimo mientras gestiona los costos de computación, caché KV y contexto largo. Los datos de preentrenamiento enfatizan capacidades cruciales para aplicaciones avanzadas, como la comprensión de código a escala de repositorio y la comprensión de contexto largo, permitiendo a los desarrolladores construir sobre sus capacidades generales para diversos casos de uso.

ERNIE-5.5-Flash-Base-BF16 representa el punto de control al final del preentrenamiento, sirviendo como un modelo fundamental antes de cualquier etapa de entrenamiento medio o posterior. Esto lo convierte en un punto de partida ideal para investigadores y desarrolladores involucrados en adaptación de dominio, ajuste de instrucciones e investigación en aprendizaje por refuerzo. El modelo ha demostrado resultados sólidos a través de un pipeline de evaluación unificado, destacándose en benchmarks relacionados con conocimiento, razonamiento, matemáticas, código, tareas multilingües y comprensión de contexto largo.

La arquitectura incorpora un MoE de atención híbrida 280B-A14B con 43 capas, incluyendo 1 FFN denso y 42 capas de MoE Latente Multi-Router. Cuenta con 37 capas de Atención Comprimida (HCA) y 6 capas de Atención Latente Multi-cabeza (MLA + DSA) con atención escasa. El modelo utiliza 512 expertos enrutados (top-10) más 1 experto compartido por capa de MoE. Innovaciones como Atención Gated de Bajo Rango, Atención de Cabeza Virtual (VHA), MoE Latente Multi-Router, ECHO, Conexiones Hiper-construidas con Manifold (mHC) y Cabeza de Salida MultiMax contribuyen a sus capacidades avanzadas y eficiencia. El tokenizador admite aproximadamente 200,000 entradas y tokeniza números de derecha a izquierda en grupos de hasta tres dígitos.

El despliegue es compatible con SGLang y vLLM, permitiendo el servicio en producción con longitudes de contexto de hasta 1,048,576 tokens. El modelo está disponible bajo el Acuerdo de Licencia del Modelo Base ERNIE 5.5 Flash v1.0.

  • CategoríaModelos de IA y LLM
  • ImplementaciónNube
  • PlataformasWeb

  • 280 mil millones de parámetros en total

  • 14 mil millones de parámetros activados por token

  • Preentrenado en 33.5 billones de tokens

  • Contexto de entrenamiento de hasta 128,000 tokens

  • El ajuste fino y la inferencia admiten un contexto de 1 millón de tokens

  • Arquitectura escasa de Mixture-of-Experts (MoE) eficiente

  • MoE de atención híbrida con 43 capas

  • 37 capas de Atención Comprimida (HCA)

  • 6 capas de Atención Latente Multi-cabeza (MLA + DSA)

  • 512 expertos enrutados (top-10) más 1 experto compartido por capa de MoE

  • Atención Gated de Bajo Rango y Atención de Cabeza Virtual (VHA)

  • MoE Latente Multi-Router para selección precisa de expertos

  • ECHO para pérdida multi-horizonte y decodificación especulativa

  • Conexiones Hiper-construidas con Manifold (mHC) para propagación de señales

  • Cabeza de Salida MultiMax para distribución de vocabulario afinada

  • Tokenizador BPE de aproximadamente 200,000 entradas

  • Soporte para SGLang y vLLM para servicio en producción

  1. Acceder a la Página del Modelo: Navegar a la página de ERNIE-5.5-Flash-Base-BF16 en Hugging Face.

  2. Explorar Archivos: Revisar los archivos del modelo y la documentación disponible en la página.

  3. Descargar Modelo: Descargar el punto de control del modelo ERNIE-5.5-Flash-Base-BF16.

  4. Instalar vLLM y Plugin: Instalar vLLM y el plugin de ERNIE 5.5 para el despliegue.

  5. Lanzar Servidor: Usar SGLang o vLLM para lanzar el servidor del modelo.

  6. Enviar Solicitudes: Enviar solicitudes al endpoint de completions usando herramientas como curl para inferencia.

  • Generación de Texto
  • Adaptación de Dominio
  • Ajuste de Instrucciones
  • Investigación en Aprendizaje por Refuerzo
  • Comprensión de Código
  • Comprensión de Contexto Largo
  • Aplicaciones Multilingües
  • Tareas de Razonamiento
  • Aplicaciones Agentes

De Baidu

Un modelo de Asistente Baidu Wenxin.

Reseñas de ERNIE-5.5-Flash-Base-BF16

Cargando...

Herramientas de IA populares como ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base es un modelo de lenguaje eficiente y escaso de Mixture-of-Experts (MoE) con 280B de parámetros totales, diseñado para la generación de texto. Preentrenado en…

Modelos de IA y LLM
Ver herramienta

Modelo de lenguaje eficiente y escaso de Mixture-of-Experts (MoE) con 280B de parámetros totales, diseñado para la generación de texto. Preentrenado en…ERNIE-5.5-Flash-Base es un modelo de lenguaje eficiente y escaso de Mixture-of-Experts (MoE) con 280B de parámetros totales, diseñado para la generación de texto. Preentrenado en…

Modelos de IA y LLM
Ver el Top 100 de LLM

DeepSeek-V4-Pro es un modelo de IA avanzado diseñado para una inteligencia contextual eficiente de un millón de tokens. Presenta una arquitectura de atención híbrida y está…

Modelos de IA y LLM
Ver herramienta

Modelo de IA avanzado diseñado para una inteligencia contextual eficiente de un millón de tokens. Presenta una arquitectura de atención híbrida y está…DeepSeek-V4-Pro es un modelo de IA avanzado diseñado para una inteligencia contextual eficiente de un millón de tokens. Presenta una arquitectura de atención híbrida y está…

DestacadaModelos de IA y LLM
Ver el Top 100 de LLM

DeepSeek-V3 es un modelo de lenguaje Mixture-of-Experts con 671 mil millones de parámetros, diseñado para una inferencia eficiente y un entrenamiento rentable. Destaca en varios…

Modelos de IA y LLM

N.º 42 en LLM

Ver herramienta

Modelo de lenguaje Mixture-of-Experts con 671 mil millones de parámetros, diseñado para una inferencia eficiente y un entrenamiento rentable. Destaca en varios…DeepSeek-V3 es un modelo de lenguaje Mixture-of-Experts con 671 mil millones de parámetros, diseñado para una inferencia eficiente y un entrenamiento rentable. Destaca en varios…

DestacadaModelos de IA y LLM
N.º 42 en LLM

DeepSeek-V4-Pro-DSpark es un modelo de lenguaje avanzado que presenta una arquitectura de atención híbrida y hiperconexiones restringidas por variedades. Soporta una longitud de…

Modelos de IA y LLM

N.º 71 en LLM

Ver herramienta

Modelo de lenguaje avanzado que presenta una arquitectura de atención híbrida y hiperconexiones restringidas por variedades. Soporta una longitud de…DeepSeek-V4-Pro-DSpark es un modelo de lenguaje avanzado que presenta una arquitectura de atención híbrida y hiperconexiones restringidas por variedades. Soporta una longitud de…

Modelos de IA y LLM
N.º 71 en LLM

AliceAI-Foundation-80B-A3B-Base es un modelo de lenguaje fundamental con una arquitectura híbrida y capas de MoE, que cuenta con 80 mil millones de parámetros. Destaca en tareas…

Modelos de IA y LLM

N.º 29 en LLM

Ver herramienta

Modelo de lenguaje fundamental con una arquitectura híbrida y capas de MoE, que cuenta con 80 mil millones de parámetros. Destaca en tareas…AliceAI-Foundation-80B-A3B-Base es un modelo de lenguaje fundamental con una arquitectura híbrida y capas de MoE, que cuenta con 80 mil millones de parámetros. Destaca en tareas…

Modelos de IA y LLM
N.º 29 en LLM

Ling-3.0-flash es un modelo de razonamiento híbrido de próxima generación diseñado para la eficiencia y el rendimiento. Con 124 mil millones de parámetros, sobresale en…

Modelos de IA y LLM

N.º 65 en LLM

Ver herramienta

Modelo de razonamiento híbrido de próxima generación diseñado para la eficiencia y el rendimiento. Con 124 mil millones de parámetros, sobresale en…Ling-3.0-flash es un modelo de razonamiento híbrido de próxima generación diseñado para la eficiencia y el rendimiento. Con 124 mil millones de parámetros, sobresale en…

Modelos de IA y LLM
N.º 65 en LLM

DeepSeek-V3

Repositorios de IA en GitHub

DeepSeek-V3 es un modelo de lenguaje Mixture-of-Experts de peso abierto de DeepSeek, con un total de 671 mil millones de parámetros y 37 mil millones activados por token.…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Modelo de lenguaje Mixture-of-Experts de peso abierto de DeepSeek, con un total de 671 mil millones de parámetros y 37 mil millones activados por token.…DeepSeek-V3 es un modelo de lenguaje Mixture-of-Experts de peso abierto de DeepSeek, con un total de 671 mil millones de parámetros y 37 mil millones activados por token.…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub

Kimi-K2-Instruct es un modelo de lenguaje de última generación basado en mezcla de expertos, diseñado para tareas avanzadas de IA. Destaca en razonamiento, codificación y uso de…

Modelos de IA y LLM

N.º 51 en LLM

Ver herramienta

Kimi-K2-Instruct es un modelo de lenguaje de última generación basado en mezcla de expertos, diseñado para tareas avanzadas de IA. Destaca en razonamiento, codificación y uso de…

Modelos de IA y LLM
N.º 51 en LLM
1 de 8