Descripción
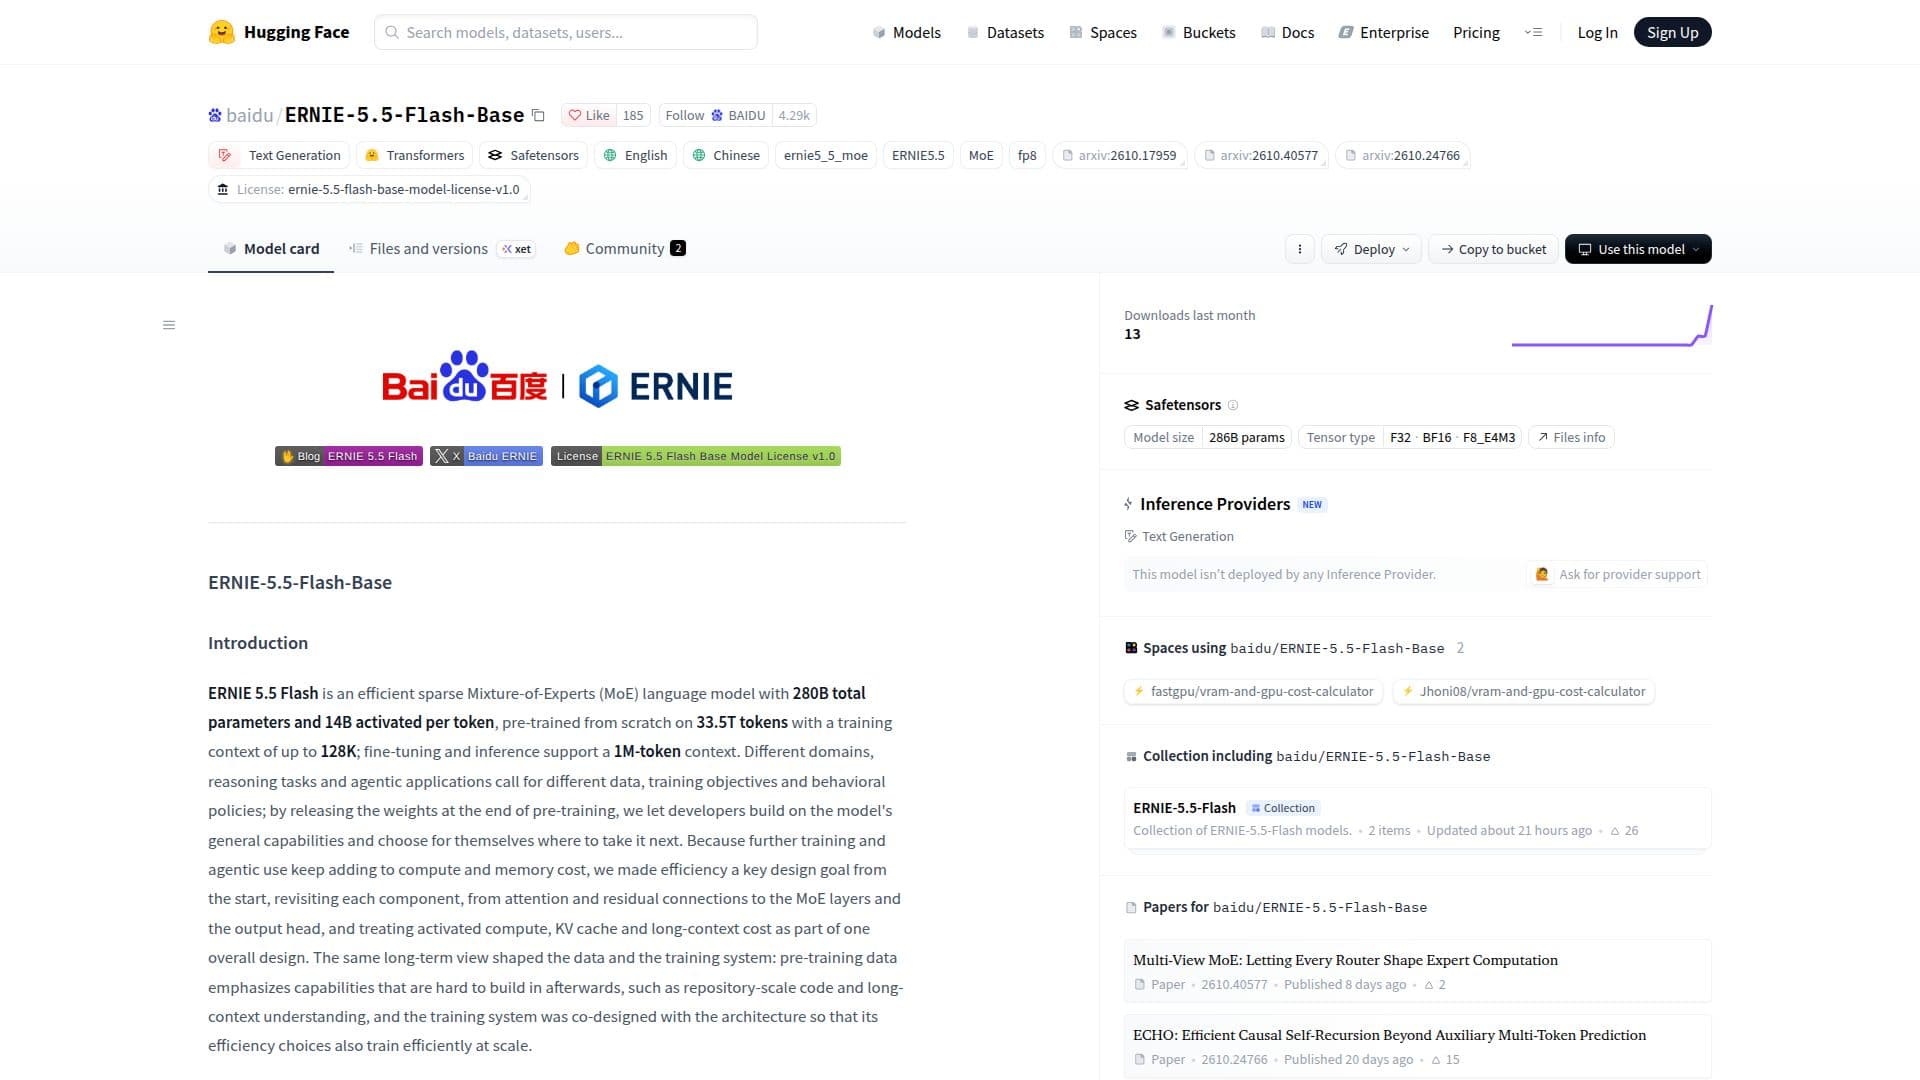
ERNIE-5.5-Flash-Base es un sofisticado modelo de generación de texto desarrollado por Baidu, disponible en Hugging Face. Es un modelo de lenguaje eficiente y escaso de Mixture-of-Experts (MoE), con 280 mil millones de parámetros totales y 14 mil millones activados por token. El modelo fue preentrenado desde cero en un extenso conjunto de datos de 33.5 billones de tokens, utilizando un contexto de entrenamiento de hasta 128K. Para el ajuste fino y la inferencia, admite una impresionante longitud de contexto de 1M de tokens.
Leer más
Diseñado con la eficiencia como objetivo central, ERNIE 5.5 Flash revisita cada componente, desde los mecanismos de atención y las conexiones residuales hasta las capas de MoE y la cabeza de salida. Este enfoque holístico considera el cómputo activado, la caché KV y los costos de contexto largo como parte de un diseño integrado. Los datos de preentrenamiento enfatizan capacidades que son difíciles de construir después del entrenamiento, como la comprensión de código a escala de repositorio y la comprensión de contexto largo. El sistema de entrenamiento fue co-diseñado con la arquitectura para asegurar una escalabilidad eficiente.
ERNIE-5.5-Flash-Base representa el punto de control al final del preentrenamiento, lo que lo convierte en una base ideal para los desarrolladores. Permite la adaptación de dominio, el ajuste de instrucciones y la investigación en aprendizaje por refuerzo. El modelo demuestra resultados sólidos a través de un pipeline de evaluación unificado, cubriendo conocimiento, razonamiento, matemáticas, código, tareas multilingües y benchmarks de contexto largo. Su rendimiento se compara con otros modelos grandes como DeepSeek-V4-Flash-Base, Hy3-preview-Base y MiMo-V2.5-Base, todos evaluados bajo condiciones consistentes.
La arquitectura incorpora un MoE de atención híbrida 280B-A14B con 43 capas, incluyendo 1 FFN denso y 42 capas de MoE Latente Multi-Router. Presenta 37 capas de Atención Comprimida (HCA) y 6 capas de Atención Latente Multi-cabeza con atención escasa (MLA + DSA). El modelo utiliza 512 expertos enrutados (top-10) más 1 experto compartido por capa de MoE. Las innovaciones clave incluyen atención híbrida MLA + HCA con dimensiones de cabeza específicas por capa, Atención Gated de Bajo Rango, Atención de Cabeza Virtual (VHA), MoE Latente Multi-Router, ECHO para la predicción de tokens futuros, Conexiones Hiper-construidas restringidas por Manifold (mHC) y una Cabeza de Salida MultiMax. El tokenizador utiliza un tokenizador BPE de ≈200K entradas que tokeniza números de derecha a izquierda en grupos de hasta tres dígitos.
El despliegue de ERNIE-5.5-Flash-Base es compatible con SGLang y vLLM, permitiendo el servicio en producción con longitudes de contexto de hasta 1,048,576 tokens para inferencia de contexto largo. El modelo se proporciona bajo el Acuerdo de Licencia del Modelo ERNIE 5.5 Flash Base v1.0, con derechos de autor retenidos por Baidu.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de ERNIE-5.5-Flash-Base
280B de parámetros totales con 14B activados por token
Preentrenado en 33.5T de tokens
Admite un contexto de 1M de tokens para ajuste fino e inferencia
Arquitectura eficiente de Mixture-of-Experts (MoE) escasa
Atención híbrida MLA + HCA con dimensiones de cabeza específicas por capa
Atención Gated de Bajo Rango y Atención de Cabeza Virtual (VHA)
MoE Latente Multi-Router con 512 expertos enrutados y 1 experto compartido
ECHO para pérdida multi-horizonte y decodificación especulativa
Conexiones Hiper-construidas restringidas por Manifold (mHC) para propagación de señales
Cabeza de Salida MultiMax para distribución de vocabulario afinada
Tokenizador BPE de ≈200K entradas con tokenización de números de derecha a izquierda
Admite despliegue con SGLang y vLLM
Rendimiento sólido en benchmarks de conocimiento, razonamiento, matemáticas, código, multilingües y de contexto largo
Pesos de precisión FP8 y BF16 disponibles
Primeros pasos con ERNIE-5.5-Flash-Base
Acceder al Modelo: Navegar a la página de ERNIE-5.5-Flash-Base en Hugging Face.
Descargar Modelo: Elegir entre precisión FP8 (safetensors) o BF16 (safetensors) para la descarga.
Instalar Herramientas de Despliegue: Instalar vLLM y el plugin de ERNIE 5.5, o usar la imagen Docker preconstruida oficial de SGLang.
Iniciar Servidor: Iniciar el servidor vLLM o SGLang para alojar el modelo.
Enviar Solicitudes: Usar curl u otros clientes API para enviar solicitudes al endpoint de completions para la generación de texto.
Ajustar Modelo: Utilizar el punto de control preentrenado para la adaptación de dominio, ajuste de instrucciones o investigación en aprendizaje por refuerzo.
Casos de uso de ERNIE-5.5-Flash-Base
- Generación de Texto
- Adaptación de Dominio
- Ajuste de Instrucciones
- Investigación en Aprendizaje por Refuerzo
- Generación y Comprensión de Código
- Comprensión de Contexto Largo
- Aplicaciones Multilingües
- Tareas de Razonamiento