Descripción
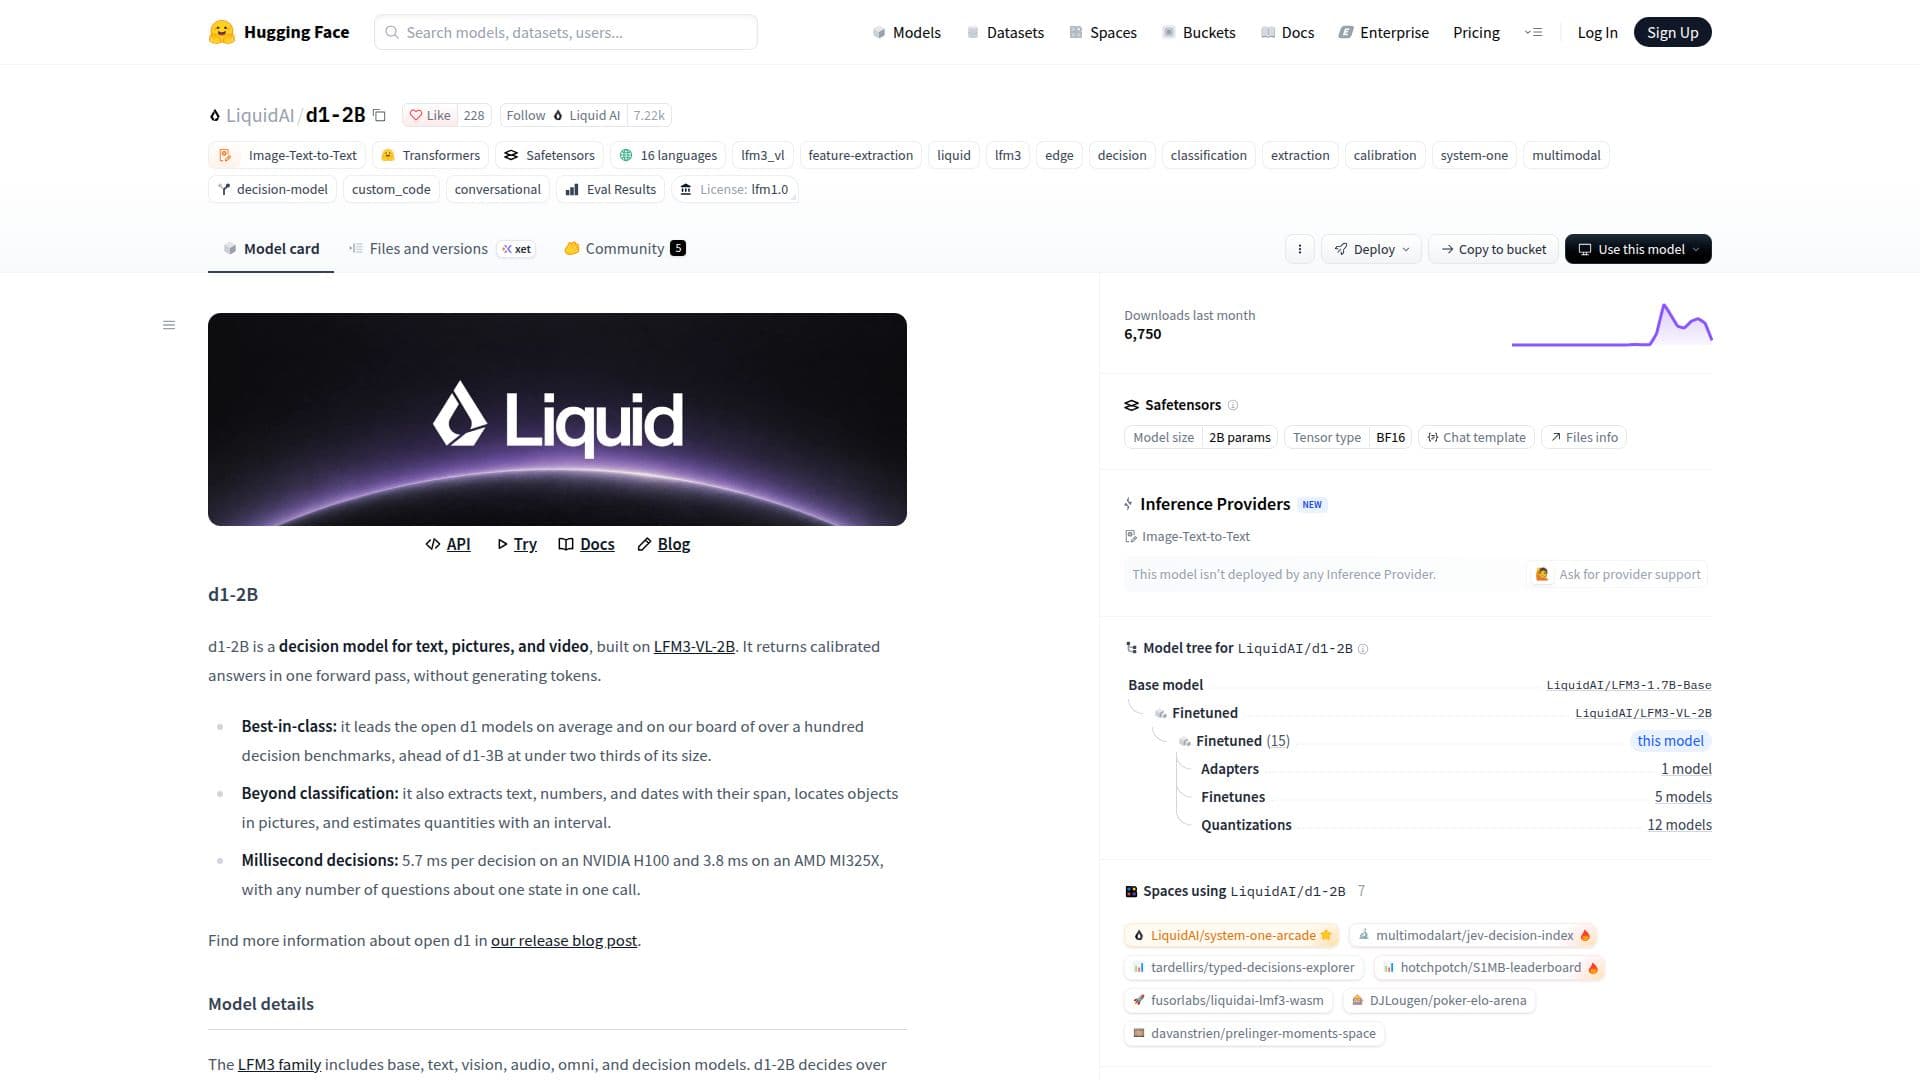
d1-2B es un modelo de decisión altamente eficiente desarrollado por LiquidAI, disponible en Hugging Face. Construido sobre la arquitectura LFM3-VL-2B, este modelo está diseñado para procesar y tomar decisiones basadas en entradas multimodales, incluyendo texto, imágenes y video. Una característica clave de d1-2B es su capacidad para devolver respuestas calibradas en una única pasada hacia adelante, eliminando la necesidad de generación de tokens, lo que contribuye a su velocidad y eficiencia.
Leer más
El modelo demuestra un rendimiento de clase mundial entre los modelos d1 abiertos, liderando en promedio en más de un centenar de benchmarks de decisión. A pesar de ser más pequeño que d1-3B, a menudo lo supera, mostrando su diseño optimizado. Más allá de las tareas de clasificación tradicionales, d1-2B ofrece capacidades avanzadas como la extracción de texto específico, números y fechas con sus intervalos, localizando objetos con precisión dentro de las imágenes y estimando cantidades con intervalos definidos.
El rendimiento es una ventaja significativa, con d1-2B logrando tiempos de decisión de 5.7 milisegundos en un NVIDIA H100 y 3.8 milisegundos en un AMD MI325X. Este procesamiento rápido se mantiene incluso con múltiples preguntas sobre un único estado en una sola llamada. La familia LFM3, que incluye d1-2B, presenta modelos base, de texto, visión, audio, omni y de decisión. Mientras d1-2B maneja texto, imágenes y video, su hermano d1-Omni-2B extiende las capacidades para incluir audio.
Con 1.92 mil millones de parámetros y una arquitectura de respaldo LFM3 que comprende 24 capas (13 convoluciones cortas con compuertas, 5 atenciones de ventana deslizante, 6 atenciones globales), d1-2B soporta una longitud de contexto de 128K tokens y un vocabulario de 128,000 tokens. Acepta entradas como un estado (texto o JSON), imágenes o video, junto con cualquier número de preguntas nombradas, produciendo respuestas tipadas con probabilidades sin generar tokens. Soporta una amplia gama de idiomas, incluyendo inglés, árabe, chino, francés, alemán, italiano, japonés, coreano, portugués, español, vietnamita, tailandés, indonesio, hindi, ruso y polaco.
d1-2B es versátil, adecuado para varios pasos de pipeline que requieren decisiones, como enrutamiento y triaje, moderación de contenido, clasificación de intención y tema, extracción de datos de documentos, evaluación y reordenamiento, e inspección visual. Se señala explícitamente que no es un modelo de chat. Aunque es efectivo para preguntas que requieren mucho conocimiento, la fiabilidad puede disminuir más allá de 64K tokens de estado. Las estimaciones son fiables para conteos y puntuaciones, pero menos para cantidades libres. El modelo se ejecuta en Transformers con su propio código, sin requerir parámetros de muestreo.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de d1-2B
Modelo de Decisión Multimodal (Texto, Imágenes, Video)
2 Mil millones de Parámetros
Pasada Única hacia Adelante para Respuestas Calibradas
Sin Generación de Tokens
Rendimiento en Benchmarks de Decisión de Clase Mundial
Extracción de Texto, Números y Fechas
Localización de Objetos en Imágenes
Estimación de Cantidades con Intervalos
Velocidad de Decisión en Milisegundos (por ejemplo, 3.8 ms en AMD MI325X)
Arquitectura de Respaldo LFM3
Longitud de Contexto de 128K Tokens
Vocabulario de 128,000 Tokens
Soporte Multilingüe (más de 15 idiomas)
Diseñado para Enrutamiento, Triage, Moderación, Extracción
Se Ejecuta en Transformers con Código de Modelo Personalizado
Primeros pasos con d1-2B
Acceder a la Página del Modelo: Navega a la página del modelo LiquidAI/d1-2B en Hugging Face.
Explorar Archivos: Revisa los detalles del modelo, la arquitectura y las especificaciones proporcionadas.
Configurar Inferencia: Utiliza la biblioteca Transformers para configurar el modelo para la inferencia.
Preparar Entradas: Proporciona un estado (texto o JSON), imágenes o video, junto con preguntas nombradas.
Ejecutar Llamadas: Usa `system_one` para solicitudes individuales o `system_one_batch` para solicitudes por lotes.
Interpretar Salida: Recibe respuestas tipadas con probabilidades, sin tokens generados.
Casos de uso de d1-2B
- Enrutamiento y Triage
- Moderación y Guardrails
- Clasificación de Intención
- Clasificación de Temas
- Extracción de Documentos
- Evaluación y Reordenamiento
- Inspección Visual
- Toma de Decisiones Multimodal