Beschreibung
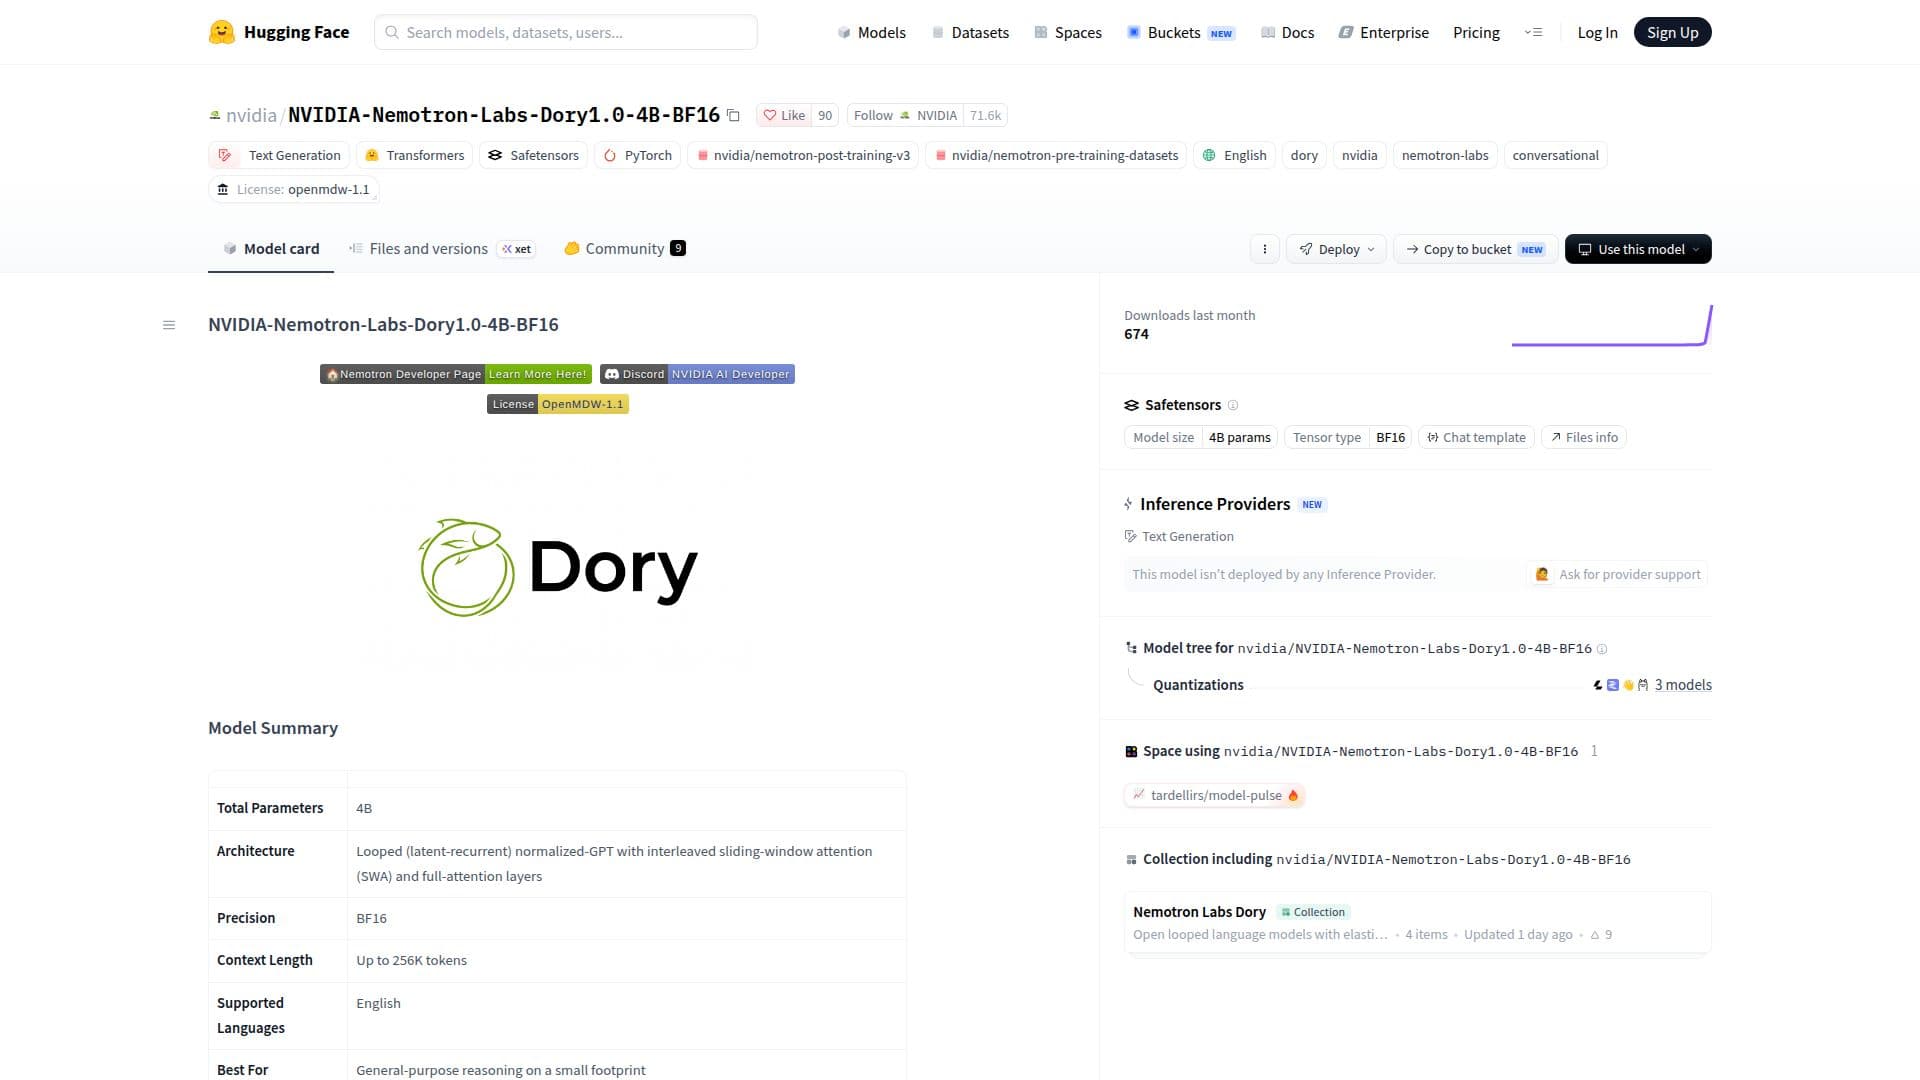
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 ist ein großes Sprachmodell, das von NVIDIA entwickelt wurde und eine geschleifte (latent-rekurrente) normalisierte GPT-Architektur nutzt. Dieses Modell ist darauf ausgelegt, allgemeine Denkaufgaben zu bewältigen und dabei einen geringen Rechenaufwand zu haben. Es verfügt über eine interleaved gleitende Fenster-Attention (SWA) und vollständige Attention-Schichten, die es ermöglichen, bis zu 256K Tokens in der Kontextlänge effizient zu verarbeiten.
Weiterlesen
Das Modell ist mit 4 Milliarden Parametern ausgestattet und verwendet BF16-Präzision, was es sowohl für kommerzielle als auch für nicht-kommerzielle Anwendungen geeignet macht. Es unterstützt die Verarbeitung der englischen Sprache und ist am besten für Aufgaben geeignet, die allgemeine Denkfähigkeiten erfordern. Die Architektur des Modells ermöglicht elastische Inferenzberechnungen, sodass Benutzer die Anzahl der Schleifen anpassen können, um ein Gleichgewicht zwischen Recheneffizienz und Genauigkeit zu finden, ohne dass eine erneute Schulung erforderlich ist.
Dory1.0-4B-BF16 wird vorab mit dem NVFP4-Format von NVIDIA trainiert, bevor es in BF16 fortgesetzt wird, um eine hohe Leistung auf NVIDIA GPU-beschleunigten Systemen sicherzustellen. Es ist in mehreren Formaten erhältlich, darunter BF16, MXFP8, NVFP4 und Q5_K_M, was Flexibilität bei der Bereitstellung über verschiedene Hardware-Konfigurationen hinweg bietet.
Das Training des Modells umfasste 6 Billionen Tokens, wobei der Schwerpunkt auf verschiedenen Bereichen wie Mathematik, Wissenschaft und Allgemeinwissen lag. Es wurde einer überwachten Feinabstimmung und verstärkendem Lernen unterzogen, um die Leistung bei der Nutzung mehrstufiger Werkzeuge, dem Befolgen von Anweisungen und strukturierten Ausgabenumgebungen zu verbessern. Die Benchmarks des Modells zeigen eine wettbewerbsfähige Leistung in verschiedenen Aufgaben, einschließlich Programmierung, Denken und Befolgen von Anweisungen.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 unterliegt der OpenMDW-Lizenzvereinbarung, Version 1.1, und wurde am 16. Oktober 2026 veröffentlicht. Es ist darauf ausgelegt, optimal auf den Architekturen Hopper und Blackwell von NVIDIA zu laufen, mit Unterstützung für Linux-Betriebssysteme.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenLinux
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 im Überblick
Geschleifte latent-rekurrente Architektur
Interleaved gleitende Fenster-Attention
256K Token Kontextlänge
BF16-Präzision
Elastische Inferenzberechnung
Native NVFP4-Vorabtrainierung
Speichereffizientes Schleifen
OpenMDW-Lizenzvereinbarung
Erste Schritte mit NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite für NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16.
Authentifizieren: Stellen Sie sicher, dass Sie die erforderlichen Anmeldeinformationen haben, um auf das Modell zuzugreifen.
Konfigurieren: Richten Sie die Modellparameter ein, einschließlich Schleifenzahl und KV-Cache-Einstellungen.
Eingabeaufforderungen senden: Geben Sie Textsequenzen an das Modell zur Verarbeitung ein.
Feinabstimmung: Passen Sie die Modelleinstellungen für spezifische Aufgaben an, falls erforderlich.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16's Anwendungsfälle
- Allgemeines Denken
- Programmierungsaufgaben
- Befolgen von Anweisungen
- Verarbeitung langer Kontexte
- Wissenschaftliche Forschung