Beschreibung
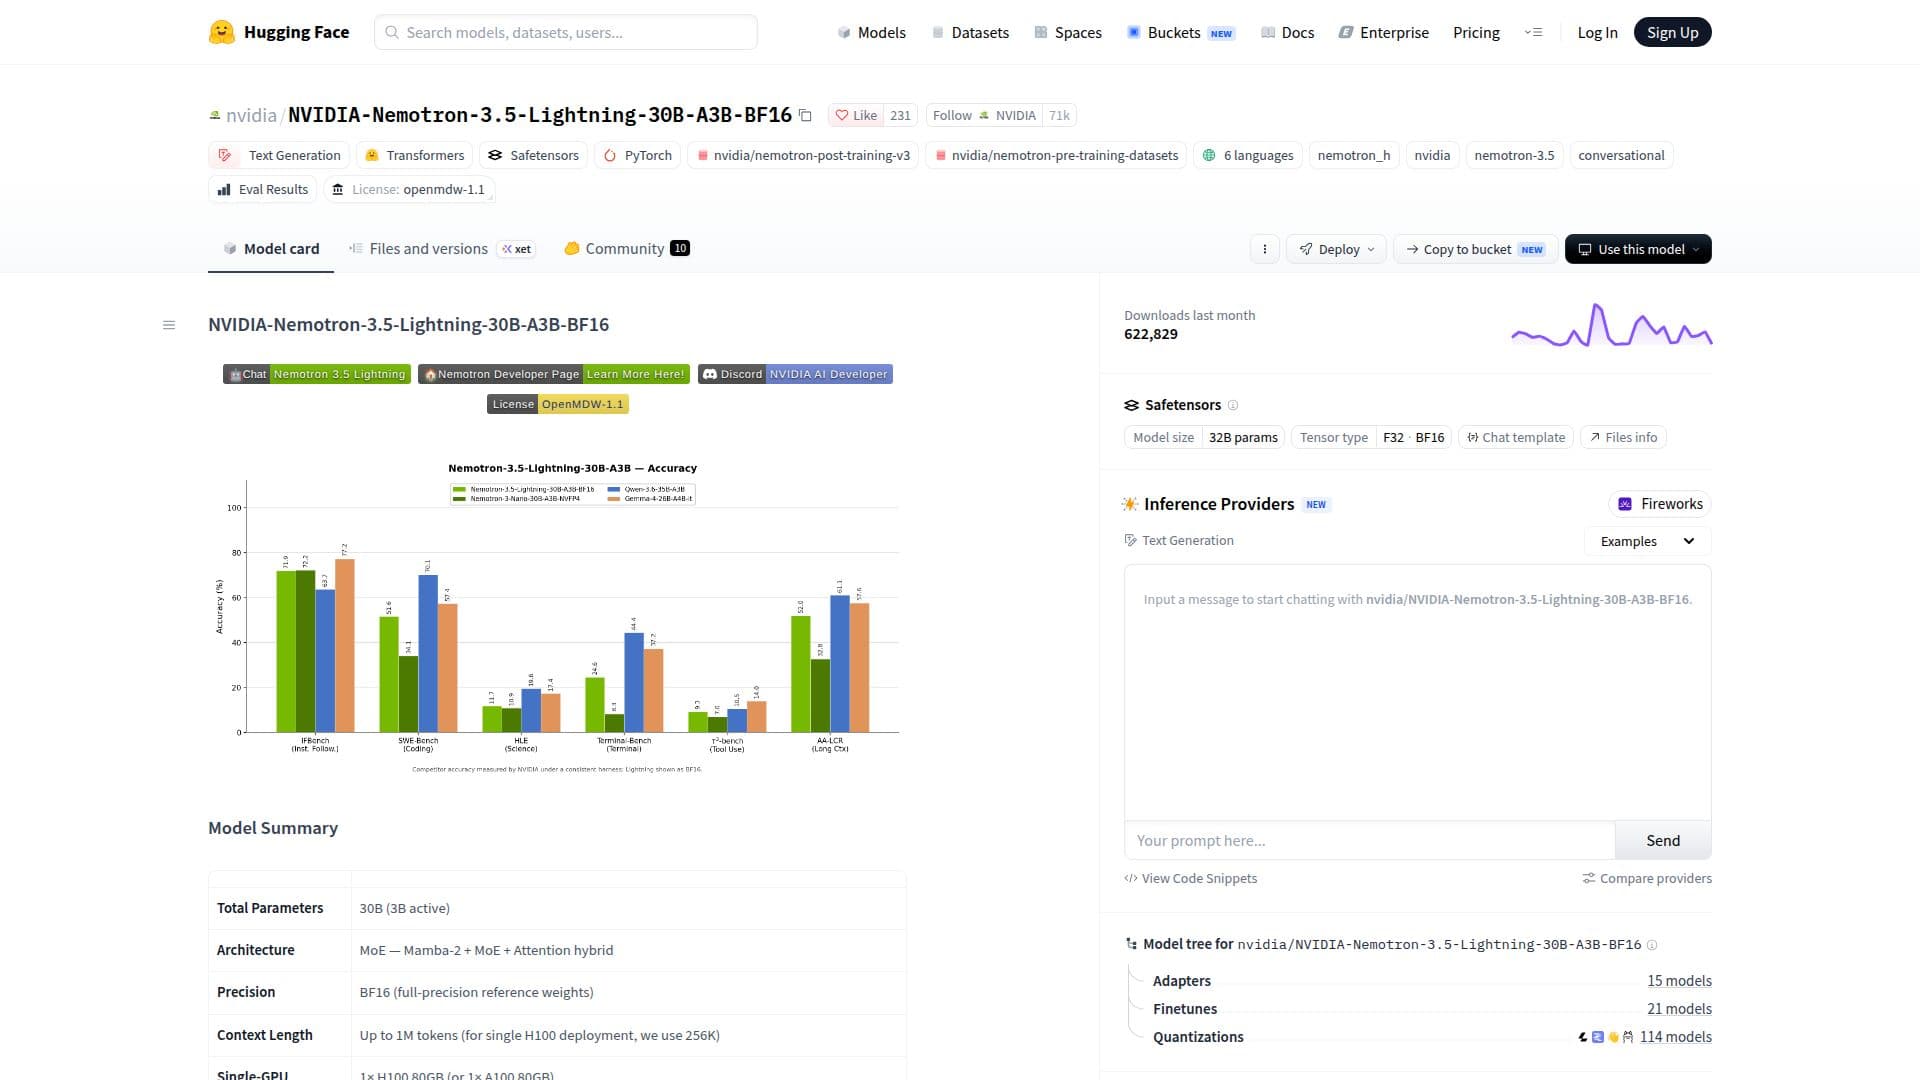
NVIDIA Nemotron 3.5 Lightning 30B A3B BF16 ist ein anspruchsvolles großes Sprachmodell, das von NVIDIA entwickelt wurde. Es verfügt über eine hybride Architektur, die MoE, Mamba-2 und Aufmerksamkeitsmechanismen kombiniert, mit insgesamt 30 Milliarden Parametern, von denen 3 Milliarden aktiv sind. Das Modell arbeitet mit BF16-Präzision, was eine hohe Genauigkeit bei der Verarbeitung von Aufgaben gewährleistet. Es unterstützt eine Kontextlänge von bis zu 1 Million Tokens, wenn es auf einer einzelnen H100-GPU eingesetzt wird, was es geeignet macht, umfangreiche Dateninputs zu verarbeiten.
Weiterlesen
Das Modell ist so konzipiert, dass es hochgradig anpassbar ist und Techniken nach dem Training wie überwachte Feinabstimmung, Verstärkungslernen und Destillation unterstützt. Diese Flexibilität ermöglicht es den Nutzern, das Modell an spezifische Domänen anzupassen, quantisierte Varianten zu erstellen und Forschung sowie Evaluierung in voller Präzision durchzuführen. NVIDIA Nemotron 3.5 Lightning 30B A3B BF16 eignet sich besonders gut für Aufgaben, die umfangreiche Schlussfolgerungen und komplexe Datenverarbeitung erfordern.
Das Modell unterstützt mehrere Sprachen, darunter Englisch, Spanisch, Französisch, Deutsch, Italienisch und Japanisch sowie verschiedene Programmiersprachen. Es ist für den Einsatz auf NVIDIA-Hardware optimiert, einschließlich Blackwell-, Hopper- und Ampere-Serie GPUs. Das Modell umfasst auch spekulative Dekodierungsfähigkeiten für Datenzentrumseinsätze mit niedriger Parallelität, was seine Effizienz in bestimmten Anwendungsfällen erhöht.
Veröffentlicht unter der OpenMDW-Lizenzvereinbarung Version 1.1, ist NVIDIA Nemotron 3.5 Lightning 30B A3B BF16 für den globalen Einsatz verfügbar. Es ist ideal für Organisationen, die fortschrittliche KI-Funktionen für Anpassungen, Domänenanpassungen und hochpräzise Forschung nutzen möchten.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
NVIDIA Nemotron 3.5 Lightning 30B A3B BF16 im Überblick
30 Milliarden Parameter
BF16-Präzision
Hybride Architektur aus MoE, Mamba-2 und Aufmerksamkeitsmechanismen
Unterstützt bis zu 1 Million Tokens
Anpassbar nach dem Training
Unterstützt mehrere Sprachen
Optimiert für NVIDIA-Hardware
Spekulative Dekodierungsfähigkeiten
Erste Schritte mit NVIDIA Nemotron 3.5 Lightning 30B A3B BF16
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite
Authentifizieren: Melden Sie sich bei Ihrem Hugging Face-Konto an
Konfigurieren: Richten Sie das Modell mit den gewünschten Parametern ein
Eingabeaufforderungen senden: Geben Sie Daten zur Verarbeitung ein
Feinabstimmung: Passen Sie das Modell für spezifische Aufgaben an
NVIDIA Nemotron 3.5 Lightning 30B A3B BF16's Anwendungsfälle
- Domänenanpassung
- Forschung und Evaluierung
- Anpassung
- Mehrsprachige Unterstützung
- Spekulative Dekodierung