Beschreibung
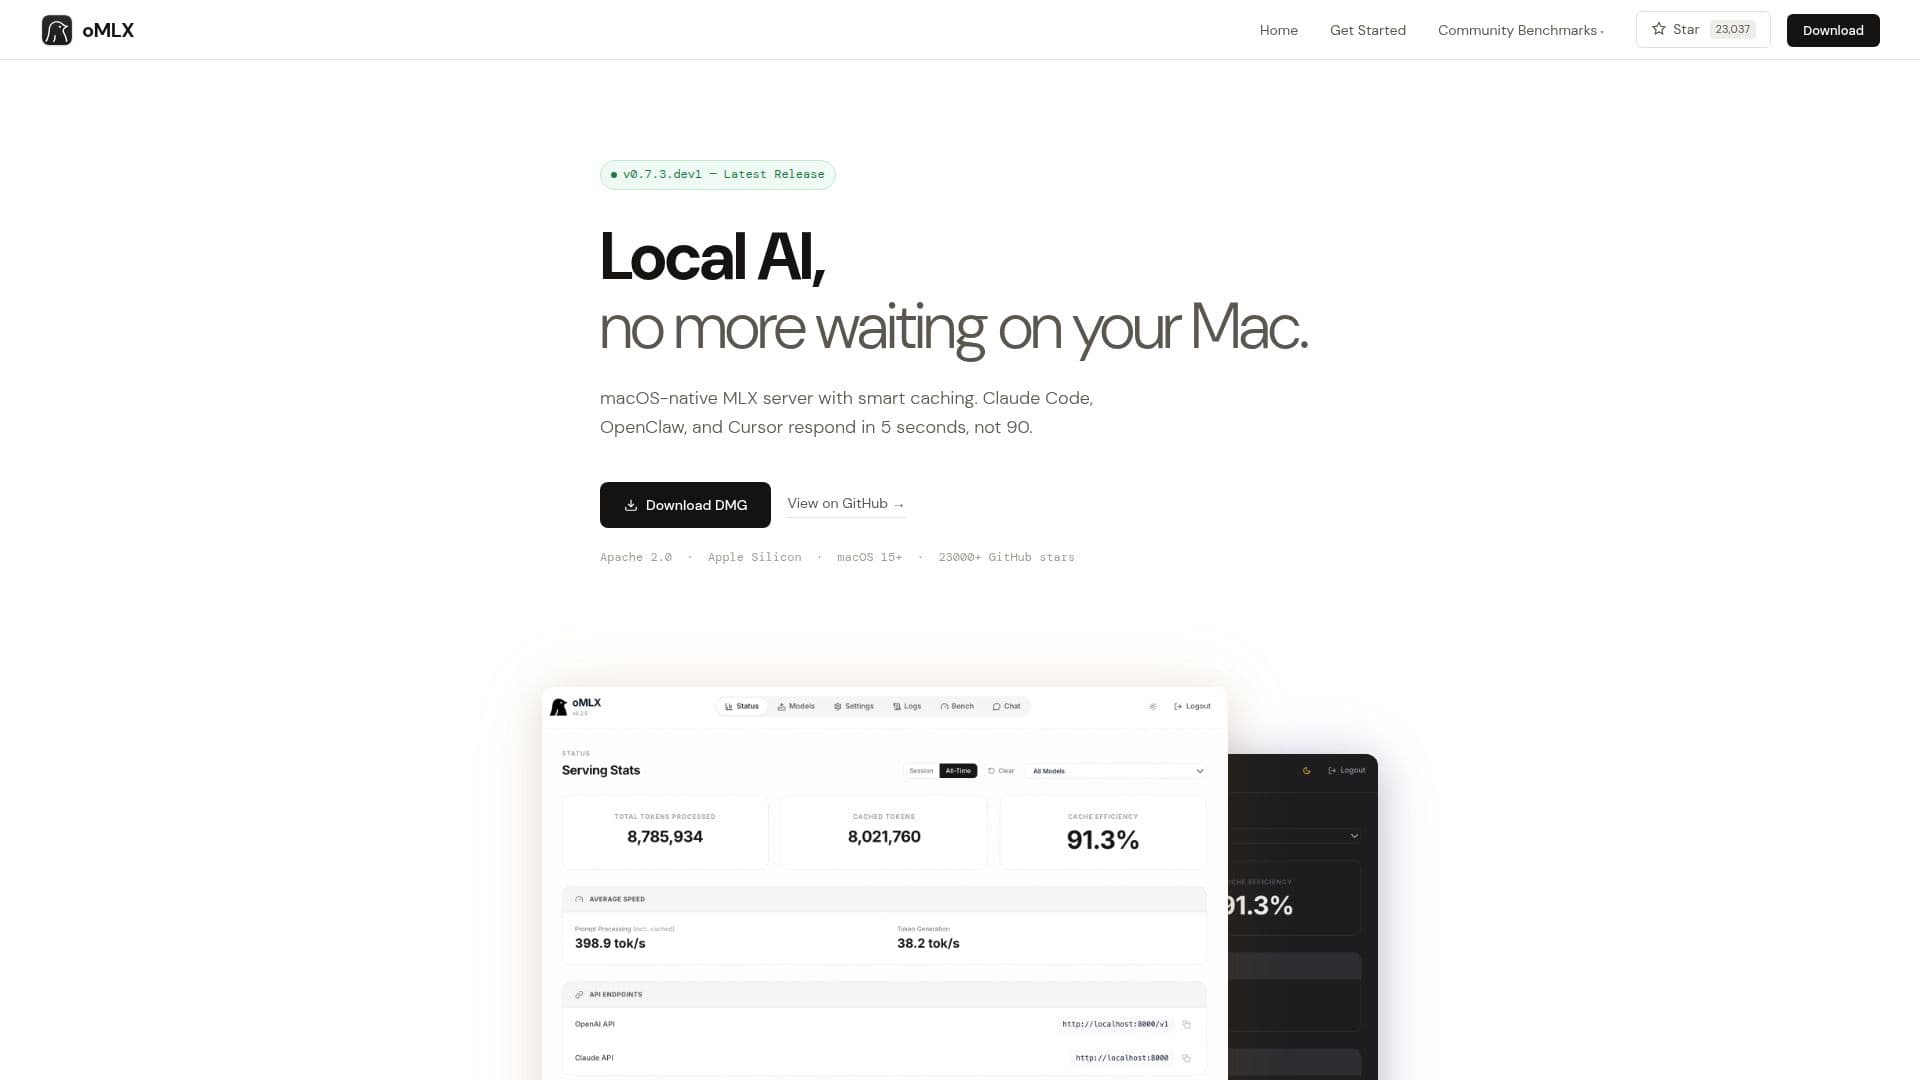
oMLX ist ein hochmoderner Inferenzserver, der speziell für macOS entwickelt wurde und die Leistung von Apple Silicon nutzt. Basierend auf dem MLX-Framework bietet er eine native Lösung zum Ausführen großer Sprachmodelle (LLMs) lokal auf Mac-Computern. Eine seiner herausragenden Funktionen ist das paged SSD KV-Caching, das die Zeit bis zum ersten Token (TTFT) drastisch von typischen 30-90 Sekunden auf unter 5 Sekunden reduziert. Diese Verbesserung ist besonders vorteilhaft für Codierungsagenten, die den Cache häufig ungültig machen, da oMLX sicherstellt, dass jeder Cacheblock auf SSD gespeichert wird, was eine schnelle Wiederherstellung von der Festplatte ermöglicht.
Weiterlesen
Der Server ist mit beliebten APIs wie OpenAI und Anthropic kompatibel, was ihn zu einem vielseitigen Werkzeug für Entwickler macht, die mit diesen Plattformen arbeiten. Er unterstützt kontinuierliches Batching und bietet eine Drop-in-API für Modelle wie Claude Code, OpenClaw und Cursor, sodass Antworten in nur wenigen Sekunden geliefert werden. Die Leistungstests, die auf einem M3 Ultra mit 512 GB RAM durchgeführt wurden, zeigen beeindruckende Durchsatz- und Speichereffizienz in verschiedenen Kontexten und Batchgrößen.
oMLX ist für Entwickler und KI-Enthusiasten konzipiert, die eine zuverlässige und schnelle lokale KI-Lösung auf ihren Macs benötigen. Er beseitigt die Notwendigkeit für cloudbasierte Inferenz, reduziert die Latenz und die Abhängigkeit von externen Servern. Das Tool ist Open Source unter der Apache 2.0-Lizenz und hat eine starke Community-Präsenz, wie die über 23.000 GitHub-Sterne belegen. Benutzer können einfach loslegen, indem sie die DMG herunterladen oder aus dem Quellcode installieren, mit Kompatibilität für Standard-Hugging Face-Caches und LM Studio-Ordner.
Insgesamt bietet oMLX eine robuste und effiziente Lösung zum Ausführen von KI-Modellen lokal auf macOS, die erhebliche Geschwindigkeitsverbesserungen und nahtlose Integration in bestehende KI-Workflows ermöglicht.
- KategorieMLOps & Modell-Deployment
- PreismodellOpen Source
- BereitstellungLokal
- PlattformenmacOS 15+
oMLX's Kernfunktionen
Nativer macOS-Inferenzserver
Paged SSD KV-Caching
Kompatibilität mit OpenAI & Anthropic APIs
Unterstützung für kontinuierliches Batching
Drop-in-API für Claude Code, OpenClaw und Cursor
Schnelle Cache-Wiederherstellung von SSD
Open Source unter Apache 2.0
Über 23.000 GitHub-Sterne
Wie verwendet man oMLX?
Herunterladen: DMG oder Quellcode erhalten
Installieren: Installationsanweisungen befolgen
Konfigurieren: Mit Hugging Face-Cache einrichten
Verwenden: Modelle mit reduziertem TTFT ausführen
Optimieren: Kontinuierliches Batching nutzen
oMLX's Anwendungsfälle
- Lokale KI-Entwicklung
- API-Integration
- Codierungsagenten
- Batchverarbeitung
- Open-Source-Beitrag