

Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

vLLM

KI-AppsMLOps & Modell-DeploymentOpen Source · NVIDIA, AMD, Google TPU

vLLM ist eine leistungsstarke und speichereffiziente Inferenz- und Bereitstellungs-Engine für große Sprachmodelle (LLMs). Es ermöglicht eine schnellere Bereitstellung von KI-Modellen mit modernster Leistung und macht die Bereitstellung von LLMs für Benutzer in verschiedenen Branchen einfach, schnell und kosteneffizient.

URL besuchen
Teilen
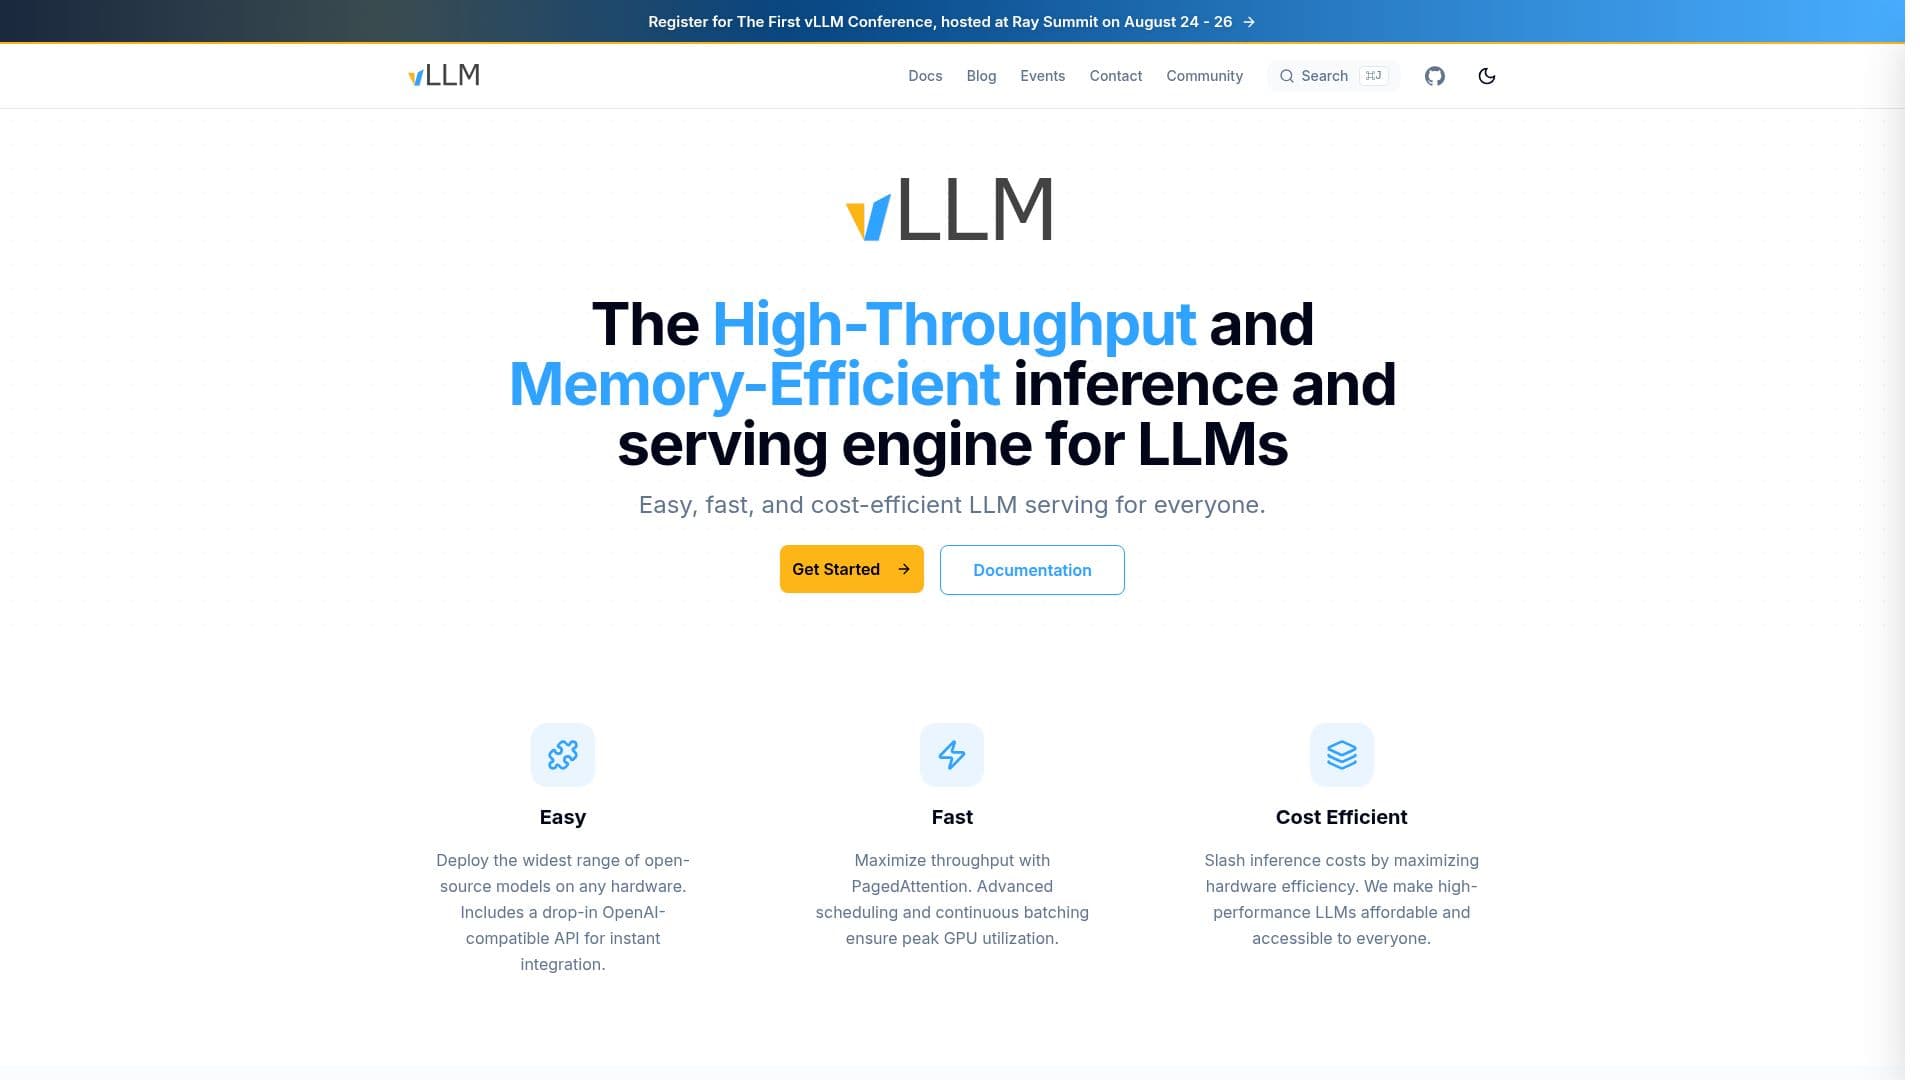
Screenshot von vLLM
Screenshot von vLLM

vLLM wurde entwickelt, um die Inferenz und Bereitstellung von großen Sprachmodellen (LLMs) mit einem Fokus auf hohe Durchsatzraten und Speichereffizienz zu optimieren. Diese Engine nutzt fortschrittliche Techniken wie optimierte GEMM/MoE-Kerne für verschiedene Präzisionen und verwendet Frameworks wie CUTLASS und TRTLLM-GEN. Das Ziel von vLLM ist es, eine nahtlose Erfahrung bei der Bereitstellung von KI-Modellen zu bieten, sodass Benutzer eine modernste Leistung erzielen können, ohne die typischen Komplexitäten, die mit der Bereitstellung von LLMs verbunden sind.

Weiterlesen

Die Plattform ist für universelle Kompatibilität ausgelegt und ermöglicht die Integration mit verschiedenen Hardwarekonfigurationen, einschließlich Unterstützung für NVIDIA GPUs, AMD GPUs und Google TPUs. Diese Flexibilität macht vLLM zu einer idealen Wahl für Entwickler und Organisationen, die KI-Lösungen in unterschiedlichen Umgebungen implementieren möchten. Benutzer können vLLM dank des einfachen Konfigurationsprozesses schnell mit minimalem Aufwand nutzen.

vLLM bietet auch einen gemeinschaftsorientierten Ansatz, mit Foren, in denen Benutzer Themen von Hardwareunterstützung bis zur Modellintegration diskutieren können. Diese kollaborative Umgebung fördert den Wissensaustausch und hilft Benutzern, ihre Nutzung der Plattform zu optimieren. Darüber hinaus unterstützt vLLM eine breite Palette von Modellen, einschließlich beliebter Architekturen wie Llama, BART und GPT, unter anderem.

Zusammenfassend lässt sich sagen, dass vLLM als leistungsstarkes Werkzeug für alle, die LLMs effizient bereitstellen möchten, herausragt. Die Kombination aus Leistung, Benutzerfreundlichkeit und Gemeinschaftsunterstützung positioniert es als wertvolle Ressource im sich schnell entwickelnden Bereich der KI.

  • KategorieMLOps & Modell-Deployment
  • PreismodellOpen Source
  • BereitstellungCloud
  • PlattformenNVIDIA, AMD, Google TPU

  • Hoher Durchsatz

  • Speichereffizient

  • Universelle Kompatibilität

  • Optimierte GEMM/MoE-Kerne

  • Unterstützung für mehrere Hardware

  • Gemeinschaftsforen

  • Schnelle Startkonfiguration

  • Breite Modellsupport

  1. Konfigurieren: Richten Sie Ihre Hardwareumgebung ein, um vLLM zu unterstützen.

  2. Installieren: Befolgen Sie die Installationsanweisungen in der Dokumentation.

  3. Bereitstellen: Laden Sie Ihr gewünschtes KI-Modell in die vLLM-Engine.

  4. Optimieren: Passen Sie die Konfigurationen für die Leistung basierend auf Ihrem spezifischen Anwendungsfall an.

  • Bereitstellung von KI-Modellen
  • Leistungsoptimierung
  • Gemeinschaftsengagement
  • Integration benutzerdefinierter Modelle
  • Plattformübergreifende Kompatibilität

Von vLLM

Teil von vLLM.

vLLM Bewertungen

Wird geladen...

Beliebte KI-Tools wie vLLM

vLLM

KI-GitHub-Repos

vllm-project/vllm ist eine hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…

MLOps & Modell-Deployment

Platz 23 in KI-GitHub-Repos

Tool ansehen

KI-GitHub-Repos

Hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…vllm-project/vllm ist eine hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…

EmpfohlenMLOps & Modell-Deployment
Platz 23 in KI-GitHub-Repos

Runware

KI-Apps

Runware ist eine generative KI-Inferenzplattform, die eine einheitliche API für Bild-, Video-, Audio-, 3D-, LLM- und Vision-Modelle bereitstellt. Sie bietet über 400.000 Modelle,…

MLOps & Modell-Deployment
Tool ansehen

KI-Apps

Generative KI-Inferenzplattform, die eine einheitliche API für Bild-, Video-, Audio-, 3D-, LLM- und Vision-Modelle bereitstellt. Sie bietet über 400.000 Modelle,…Runware ist eine generative KI-Inferenzplattform, die eine einheitliche API für Bild-, Video-, Audio-, 3D-, LLM- und Vision-Modelle bereitstellt. Sie bietet über 400.000 Modelle,…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

Ein Hochgeschwindigkeits-Anbieter für KI-Inferenz, der Modelle auf speziell entwickelter ASIC-Infrastruktur über eine OpenAI-kompatible API bereitstellt und eine geringe Zeit bis…

MLOps & Modell-Deployment
Tool ansehen

Ein Hochgeschwindigkeits-Anbieter für KI-Inferenz, der Modelle auf speziell entwickelter ASIC-Infrastruktur über eine OpenAI-kompatible API bereitstellt und eine geringe Zeit bis…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

SiliconFlow

KI-Plattformen

Eine KI-Infrastrukturplattform für Entwickler, um über eine OpenAI-kompatible API mehr als 200 optimierte LLMs und multimodale Modelle bereitzustellen, anzupassen und auszuführen,…

MLOps & Modell-Deployment
Tool ansehen

KI-Plattformen

Eine KI-Infrastrukturplattform für Entwickler, um über eine OpenAI-kompatible API mehr als 200 optimierte LLMs und multimodale Modelle bereitzustellen, anzupassen und auszuführen,…

EmpfohlenMLOps & Modell-Deployment
Top 150 KI-Plattformen ansehen

ZETIC Melange automatisiert die On-Device-KI-Bereitstellung für jedes Modell auf jedem Gerät. Entwickelt von ehemaligen Qualcomm-Ingenieuren, optimiert es die NPU-Beschleunigung,…

MLOps & Modell-Deployment

Platz 137 in MLOps & Modell-Deployment

Tool ansehen

Automatisiert die On-Device-KI-Bereitstellung für jedes Modell auf jedem Gerät. Entwickelt von ehemaligen Qualcomm-Ingenieuren, optimiert es die NPU-Beschleunigung,…ZETIC Melange automatisiert die On-Device-KI-Bereitstellung für jedes Modell auf jedem Gerät. Entwickelt von ehemaligen Qualcomm-Ingenieuren, optimiert es die NPU-Beschleunigung,…

MLOps & Modell-Deployment
Platz 137 in MLOps & Modell-Deployment

BigDL LLM

KI-Frameworks

BigDL-LLM ist eine Open-Source-Bibliothek zum Ausführen großer Sprachmodelle (LLMs) auf Intel XPU-Hardware, von Laptops bis hin zu Cloud-GPUs. Sie unterstützt…

MLOps & Modell-Deployment
Tool ansehen

KI-Frameworks

BigDL-LLM ist eine Open-Source-Bibliothek zum Ausführen großer Sprachmodelle (LLMs) auf Intel XPU-Hardware, von Laptops bis hin zu Cloud-GPUs. Sie unterstützt…

MLOps & Modell-Deployment
Top 50 KI-Frameworks ansehen

deAPI

KI-Apps

deAPI ist eine einheitliche API für Open-Source-generative KI-Modelle, die Bildgenerierung, Text-zu-Sprache, Transkription und mehr abdeckt. Anfragen laufen über eine dezentrale…

MLOps & Modell-Deployment
Tool ansehen

KI-Apps

Einheitliche API für Open-Source-generative KI-Modelle, die Bildgenerierung, Text-zu-Sprache, Transkription und mehr abdeckt. Anfragen laufen über eine dezentrale…deAPI ist eine einheitliche API für Open-Source-generative KI-Modelle, die Bildgenerierung, Text-zu-Sprache, Transkription und mehr abdeckt. Anfragen laufen über eine dezentrale…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

Bento

KI-Plattformen

Bento ist eine Inferenzplattform, die auf Geschwindigkeit und Kontrolle ausgelegt ist und es Ihnen ermöglicht, jedes KI-Modell überall bereitzustellen. Sie bietet maßgeschneiderte…

MLOps & Modell-Deployment
Tool ansehen

KI-Plattformen

Inferenzplattform, die auf Geschwindigkeit und Kontrolle ausgelegt ist und es Ihnen ermöglicht, jedes KI-Modell überall bereitzustellen. Sie bietet maßgeschneiderte…Bento ist eine Inferenzplattform, die auf Geschwindigkeit und Kontrolle ausgelegt ist und es Ihnen ermöglicht, jedes KI-Modell überall bereitzustellen. Sie bietet maßgeschneiderte…

EmpfohlenMLOps & Modell-Deployment
Top 150 KI-Plattformen ansehen
1 von 8



