Beschreibung
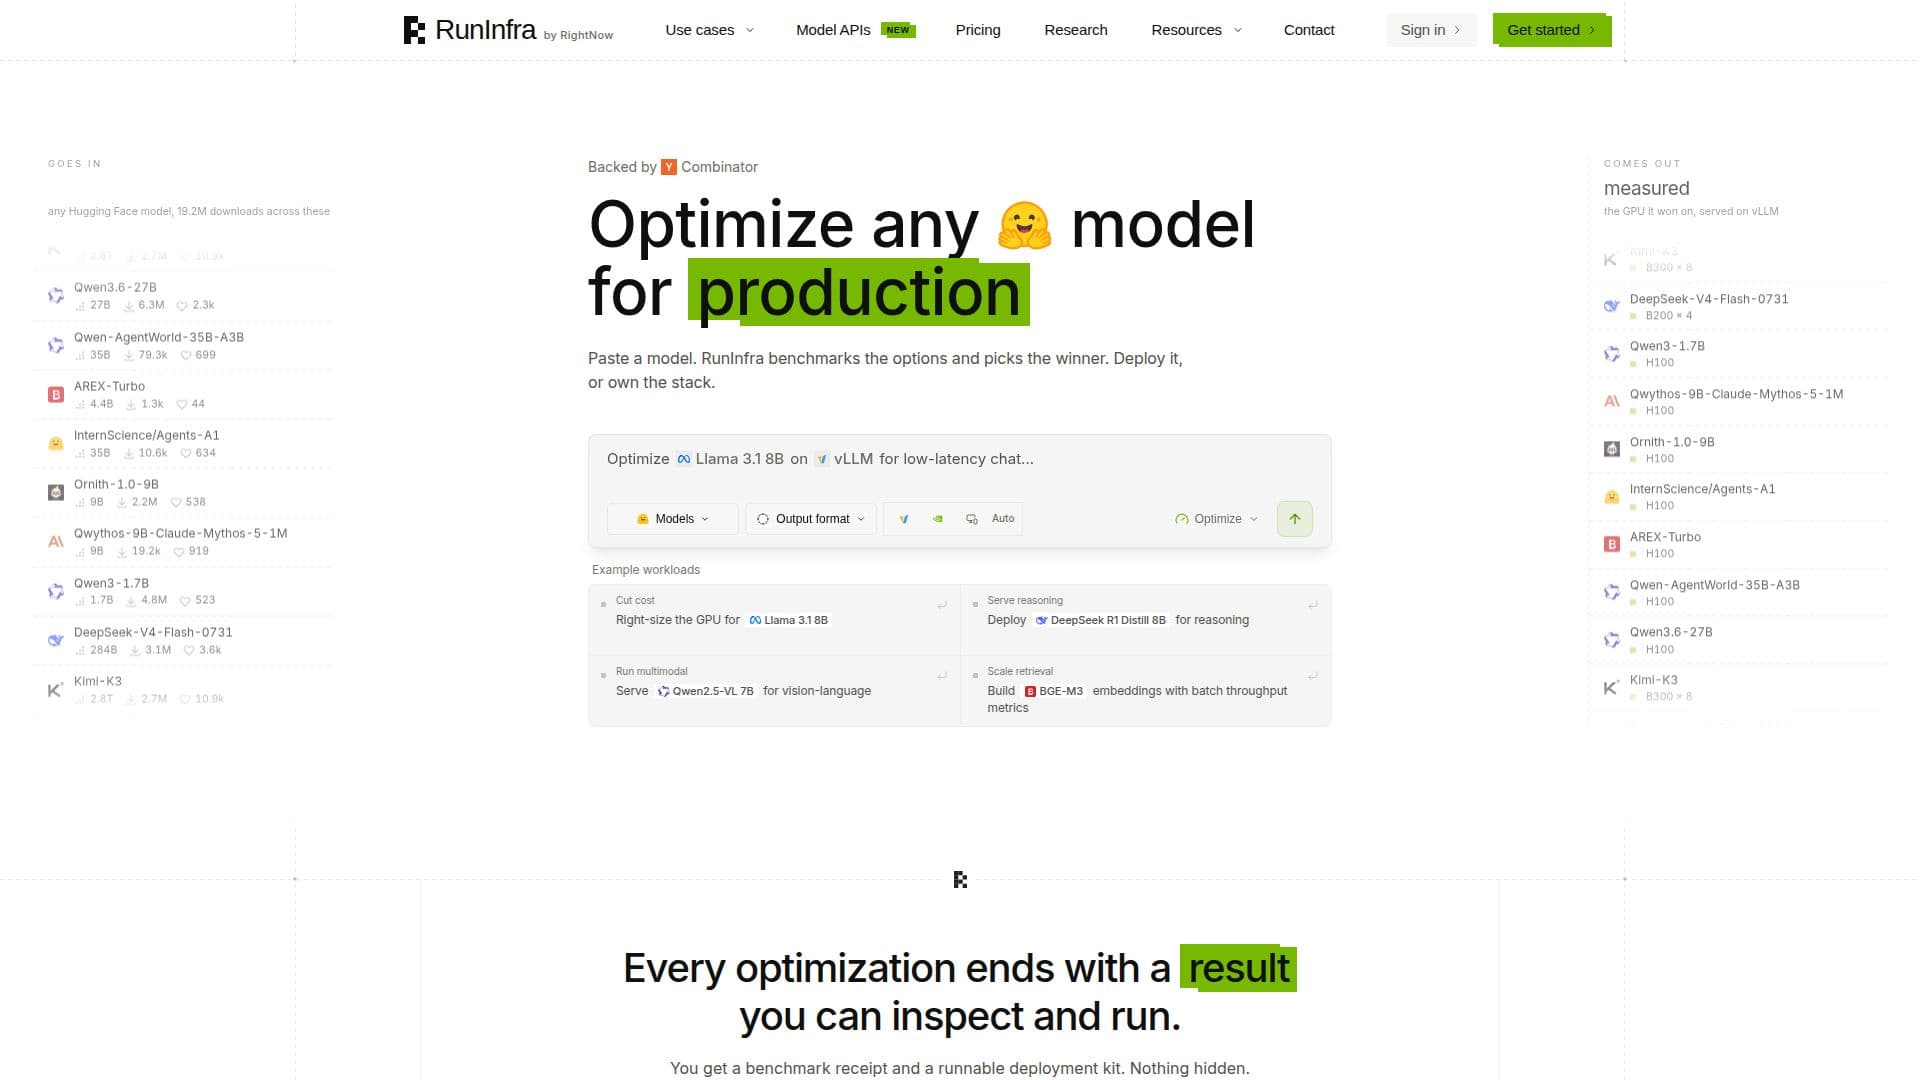
RunInfra ermöglicht Entwicklern, Open-Source-AI-Modelle über eine einzige, mit OpenAI und Anthropic kompatible API aufzurufen, anstatt die Modellinfrastruktur selbst zu hosten und zu optimieren.
Weiterlesen
RunInfra hostet eine kleine Bibliothek offener Modelle, darunter Nemotron 3.5 Lightning 30B, Qwen3.8 27B und Ornith 1.5 35B zum Zeitpunkt des Schreibens, hinter einem Gateway, das mit den OpenAI- oder Anthropic-Python- und Node-SDKs erreichbar ist, indem die Basis-URL auf die API von RunInfra zeigt. Anfragen werden pro Eingabe- und Ausgabetoken abgerechnet, wobei ein separater, niedrigerer Preis für zwischengespeicherte Eingabetokens gilt. Um die Cache-Treffer zu verbessern, verwendet RunInfra sitzungsbewusste Routing-Techniken: Es hält eine gegebene Agentensitzung an derselben Backend-Replica bei wiederholten Aufrufen fest, sodass der bereits geladene Kontext warm bleibt, anstatt bei jedem Mal auf eine zufällige Replica zu landen. Die Cache-Trefferquoten werden pro Modell gemessen und veröffentlicht, über 95 % für einige Modelle in einem aktuellen 24-Stunden-Fenster, und Treffer werden zum zwischengespeicherten Tarif abgerechnet, obwohl das Unternehmen Cache-Treffer als bestmöglichen Aufwand beschreibt.
Zu den wichtigsten Funktionen gehören eine mit OpenAI und Anthropic kompatible API für Chat-Vervollständigungen; modellabhängige Preisgestaltung mit veröffentlichten Benchmarks für Cache-Treffer und Ausgabegeschwindigkeit; Toolaufrufe, JSON-Modus, Streaming und Bildinput je nach Modell; eine CLI, die RunInfra-gehostete Modelle mit Codierungsagenten wie Claude Code, Codex, OpenCode, Cline, Droid und Grok Build verbindet; und eine Option zur Anforderung eines Modells für Modelle, die noch nicht gehostet werden.
Die Modellnutzung wird pro Token abgerechnet, zum Beispiel 0,05 USD pro 1 Million Eingabetokens und 0,15 USD pro 1 Million Ausgabetokens für ein gehostetes Modell, wobei zwischengespeicherte Eingaben separat zu einem niedrigeren Tarif abgerechnet werden, der so niedrig wie 0,01 USD pro 1 Million zwischengespeicherter Tokens ist. Pläne für Codierungsagenten beginnen bei 10 USD pro Monat.
Zur Sicherheit erklärt RunInfra, dass seine gehosteten Modell-APIs standardmäßig keine Eingabeaufforderungen speichern (null Datenaufbewahrung), Daten mit TLS während der Übertragung und AES-256 im Ruhezustand verschlüsseln, Arbeitsbereiche mit Rollen und zeilenbasierter Sicherheit anbieten, nicht auf Kundenaufforderungen oder -vervollständigungen trainieren und eine SOC 2 Typ II-Bestätigung besitzen.
RunInfra ist für Entwickler und Teams konzipiert, die AI-Agenten oder Codierungsagenten-Workflows erstellen möchten und eine Inferenz mit offenen Modellen wünschen, ohne ihre eigene GPU-Infrastruktur verwalten zu müssen; das Unternehmen, das Teil von RightNow ist, wird von Y Combinator unterstützt. Die gehostete Modellbibliothek ist klein, drei Modelle zum Zeitpunkt der Recherche, obwohl eine Option zur Anforderung eines Modells für Teams besteht, die etwas anderes benötigen.
- KategorieMLOps & Modell-Deployment
- PreismodellBezahlen nach Nutzung
- BereitstellungVerwaltet und selbst gehostet
- PlattformenCloud
RunInfra's Kernfunktionen
Ein API-Schlüssel, der mit den OpenAI- und Anthropic-SDKs kompatibel ist
Hostet offene Modelle einschließlich Nemotron, Qwen und Ornith
Sitzungsbewusstes Routing, das wiederholte Agentenaufrufe auf derselben warmen Replica hält
Veröffentlichte modellabhängige Preisgestaltung, Cache-Trefferquote und Benchmarks zur Ausgabegeschwindigkeit
Toolaufrufe, JSON-Modus, Streaming und Bildinput-Unterstützung je nach Modell
CLI-Integration mit Codierungsagenten einschließlich Claude Code, Codex, OpenCode, Cline, Droid und Grok Build
Standardmäßig keine Eingabeaufforderungsspeicherung, mit SOC 2 Typ II-Bestätigung
Arbeitsbereiche mit Rollen und zeilenbasierter Sicherheit
Wie verwendet man RunInfra?
API-Schlüssel erhalten: Registrieren Sie sich bei RunInfra und generieren Sie einen Gateway-API-Schlüssel
SDK auf RunInfra ausrichten: Setzen Sie die Basis-URL auf den Endpunkt von RunInfra im OpenAI- oder Anthropic-SDK
Modell auswählen: Wählen Sie aus der gehosteten Modellbibliothek basierend auf Funktionalität und Preis
Modell aufrufen: Senden Sie Chat-Vervollständigungsanfragen mit Ihrem vorhandenen SDK-Code
Codierungsagenten verbinden: Installieren Sie die RunInfra-CLI, um Agenten wie Claude Code oder Cline mit RunInfra-gehosteten Modellen zu verbinden
Kosten und Cache-Treffer überwachen: Überprüfen Sie die veröffentlichten Preise und die Cache-Trefferquote pro Modell, um die Ausgaben zu verwalten
RunInfra's Anwendungsfälle
- Zugriff auf Open-Model-API
- Inference von AI-Agenten
- Backend für Codierungsagenten