الوصف
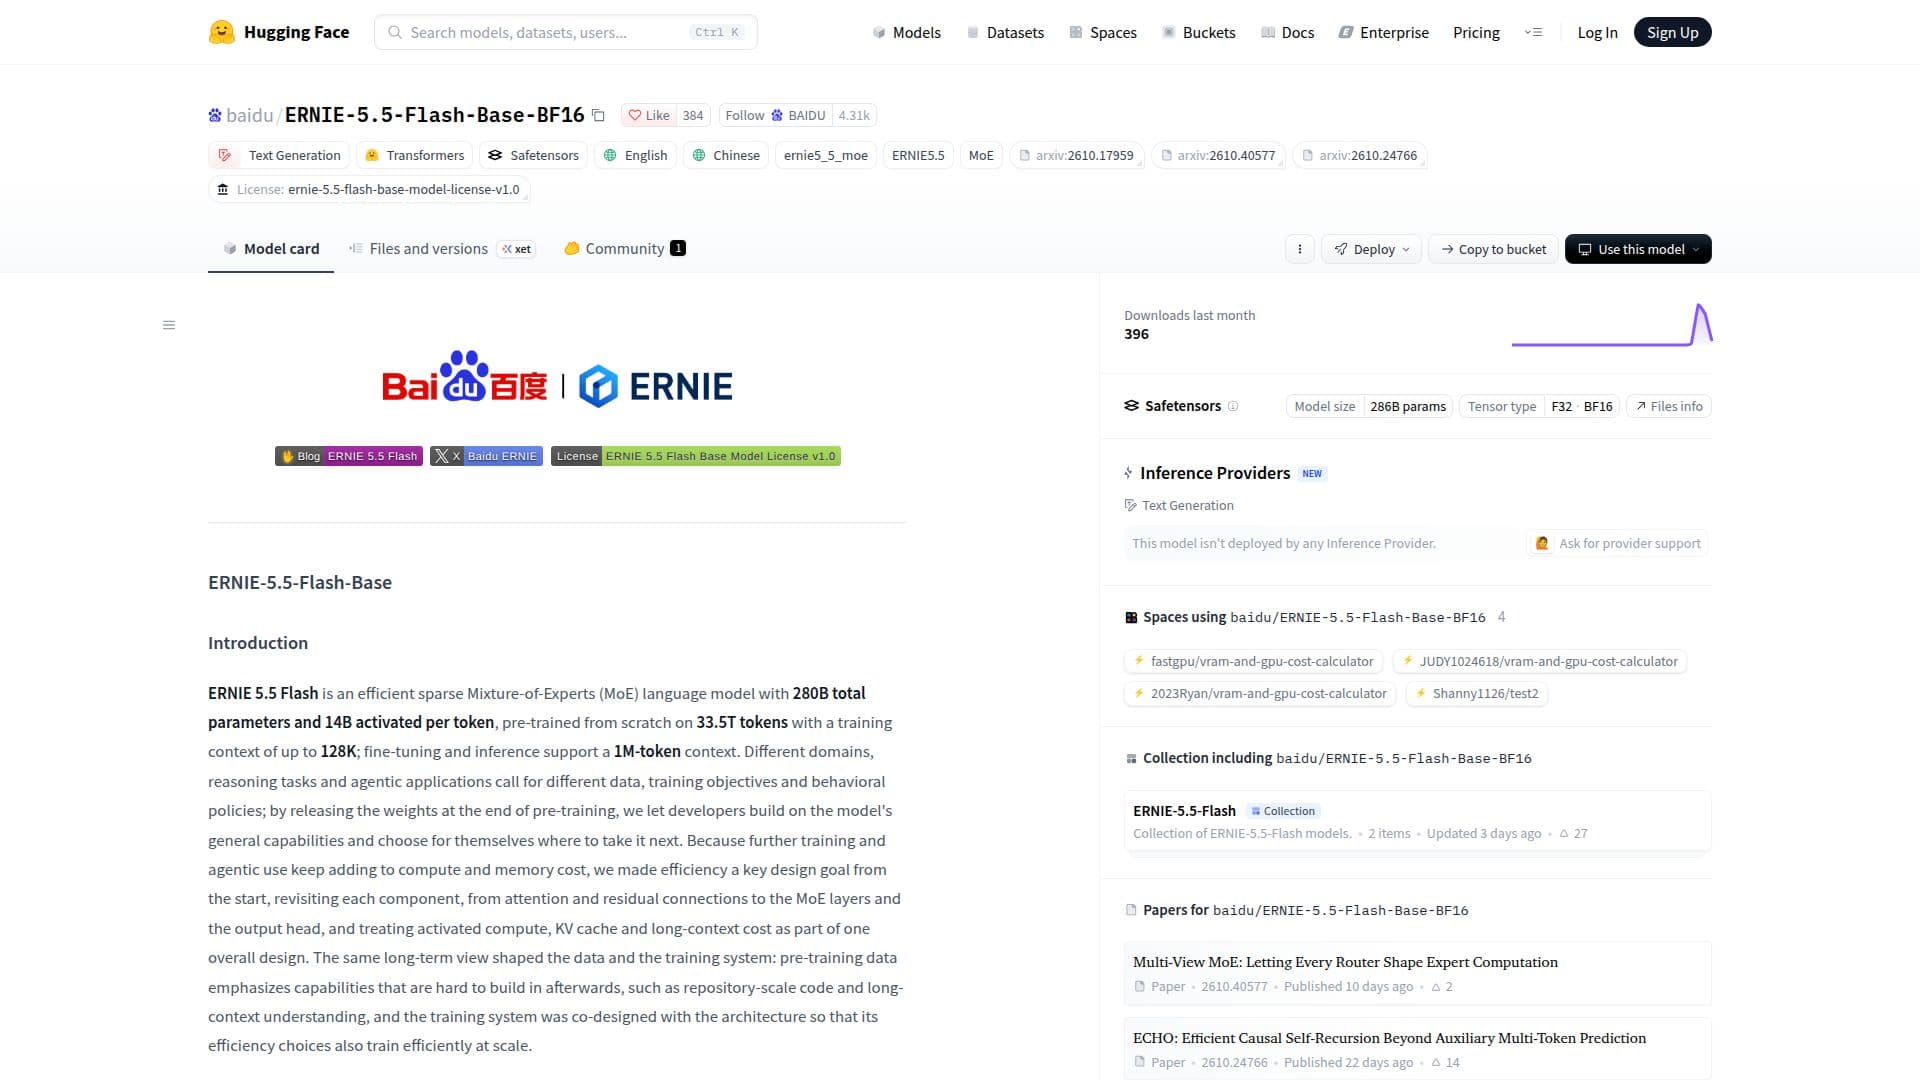
ERNIE-5.5-Flash-Base-BF16 هو نموذج لغوي متقدم من نوع Mixture-of-Experts (MoE) تم تطويره بواسطة Baidu. يتميز بـ 280 مليار معلمة إجمالية، مع 14 مليار معلمة مفعلة لكل رمز، مما يجعله فعالًا للغاية في المهام اللغوية المعقدة. تم تدريبه مسبقًا من الصفر على مجموعة بيانات واسعة تضم 33.5 تريليون رمز، مستخدمًا سياق تدريب يصل إلى 128,000 رمز. لدعم التخصيص والاستدلال، يدعم طول سياق مثير للإعجاب يصل إلى 1 مليون رمز، مما يمكّن من فهم عميق وتوليد محتوى طويل.
قراءة المزيد
تم تصميم ERNIE 5.5 Flash مع الكفاءة كمبدأ أساسي، حيث يعيد النظر في كل مكون، من آليات الانتباه والاتصالات المتبقية إلى طبقات MoE ورأس الإخراج. تضمن هذه المقاربة الشاملة أداءً مثاليًا مع إدارة تكاليف الحوسبة وذاكرة KV وسياقات طويلة. تركز بيانات التدريب المسبق على القدرات الحيوية للتطبيقات المتقدمة، مثل فهم الشيفرات على نطاق المستودعات وفهم السياقات الطويلة، مما يسمح للمطورين بالبناء على قدراته العامة لمجموعة متنوعة من حالات الاستخدام.
يمثل ERNIE-5.5-Flash-Base-BF16 نقطة التحقق في نهاية التدريب المسبق، ويعمل كنموذج أساسي قبل أي مراحل تدريب وسطى أو لاحقة. وهذا يجعله نقطة انطلاق مثالية للباحثين والمطورين المشاركين في التكيف مع المجالات، وضبط التعليمات، وأبحاث التعلم المعزز. لقد أظهر النموذج نتائج قوية عبر خط تقييم موحد، متفوقًا في المعايير المتعلقة بالمعرفة، والتفكير، والرياضيات، والشيفرة، والمهام متعددة اللغات، وفهم السياقات الطويلة.
تتضمن البنية المعمارية نموذج MoE هجين مع 280B-A14B مع 43 طبقة، بما في ذلك 1 طبقة FFN كثيفة و42 طبقة MoE متعددة الموجهات. يحتوي على 37 طبقة انتباه مضغوط بشدة (HCA) و6 طبقات انتباه متعدد الرؤوس (MLA + DSA) مع انتباه متفرق. يستخدم النموذج 512 خبيرًا موجهًا (الأعلى-10) بالإضافة إلى 1 خبير مشترك لكل طبقة MoE. تساهم الابتكارات مثل الانتباه البوابة منخفضة الرتبة، والانتباه الافتراضي للرأس (VHA)، وMoE متعددة الموجهات، وECHO، والاتصالات الفائقة المقيدة بالمنحنيات (mHC)، ورأس الإخراج MultiMax في قدراته المتقدمة وكفاءته. يدعم المحلل اللغوي حوالي 200,000 إدخال ويحلل الأرقام من اليمين إلى اليسار في مجموعات تصل إلى ثلاثة أرقام.
يدعم النشر مع SGLang وvLLM، مما يسمح بتقديم الإنتاج مع أطوال سياق تصل إلى 1,048,576 رمز. النموذج متاح بموجب اتفاقية ترخيص نموذج ERNIE 5.5 Flash Base v1.0.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- النشرسحابي
- المنصاتالويب
أبرز ملامح ERNIE-5.5-Flash-Base-BF16
280 مليار معلمة إجمالية
14 مليار معلمة مفعلة لكل رمز
تم تدريبه مسبقًا على 33.5 تريليون رمز
سياق التدريب يصل إلى 128,000 رمز
يدعم التخصيص والاستدلال بسياق يصل إلى 1 مليون رمز
بنية Mixture-of-Experts (MoE) فعالة
MoE هجين مع 43 طبقة
37 طبقة انتباه مضغوط بشدة (HCA)
6 طبقات انتباه متعدد الرؤوس (MLA + DSA)
512 خبيرًا موجهًا (الأعلى-10) بالإضافة إلى 1 خبير مشترك لكل طبقة MoE
انتباه بوابة منخفضة الرتبة والانتباه الافتراضي للرأس (VHA)
MoE متعددة الموجهات لاختيار الخبراء بدقة
ECHO لفقدان متعدد الآفاق وفك تشفير تخميني
اتصالات فائقة مقيدة بالمنحنيات (mHC) لنقل الإشارة
رأس الإخراج MultiMax لتوزيع مفردات أكثر حدة
محلل لغوي BPE يدعم حوالي 200,000 إدخال
دعم لـ SGLang وvLLM لتقديم الإنتاج
البدء مع ERNIE-5.5-Flash-Base-BF16
الوصول إلى صفحة النموذج: انتقل إلى صفحة ERNIE-5.5-Flash-Base-BF16 على Hugging Face.
استكشاف الملفات: راجع ملفات النموذج والوثائق المتاحة على الصفحة.
تنزيل النموذج: قم بتنزيل نقطة تحقق نموذج ERNIE-5.5-Flash-Base-BF16.
تثبيت vLLM والإضافة: قم بتثبيت vLLM وإضافة ERNIE 5.5 للنشر.
إطلاق الخادم: استخدم SGLang أو vLLM لإطلاق خادم النموذج.
إرسال الطلبات: أرسل الطلبات إلى نقطة نهاية الاكتمال باستخدام أدوات مثل curl للاستدلال.
حالات استخدام ERNIE-5.5-Flash-Base-BF16
- توليد النصوص
- التكيف مع المجالات
- ضبط التعليمات
- أبحاث التعلم المعزز
- فهم الشيفرة
- فهم السياقات الطويلة
- التطبيقات متعددة اللغات
- مهام التفكير
- التطبيقات الوكيلة