الوصف
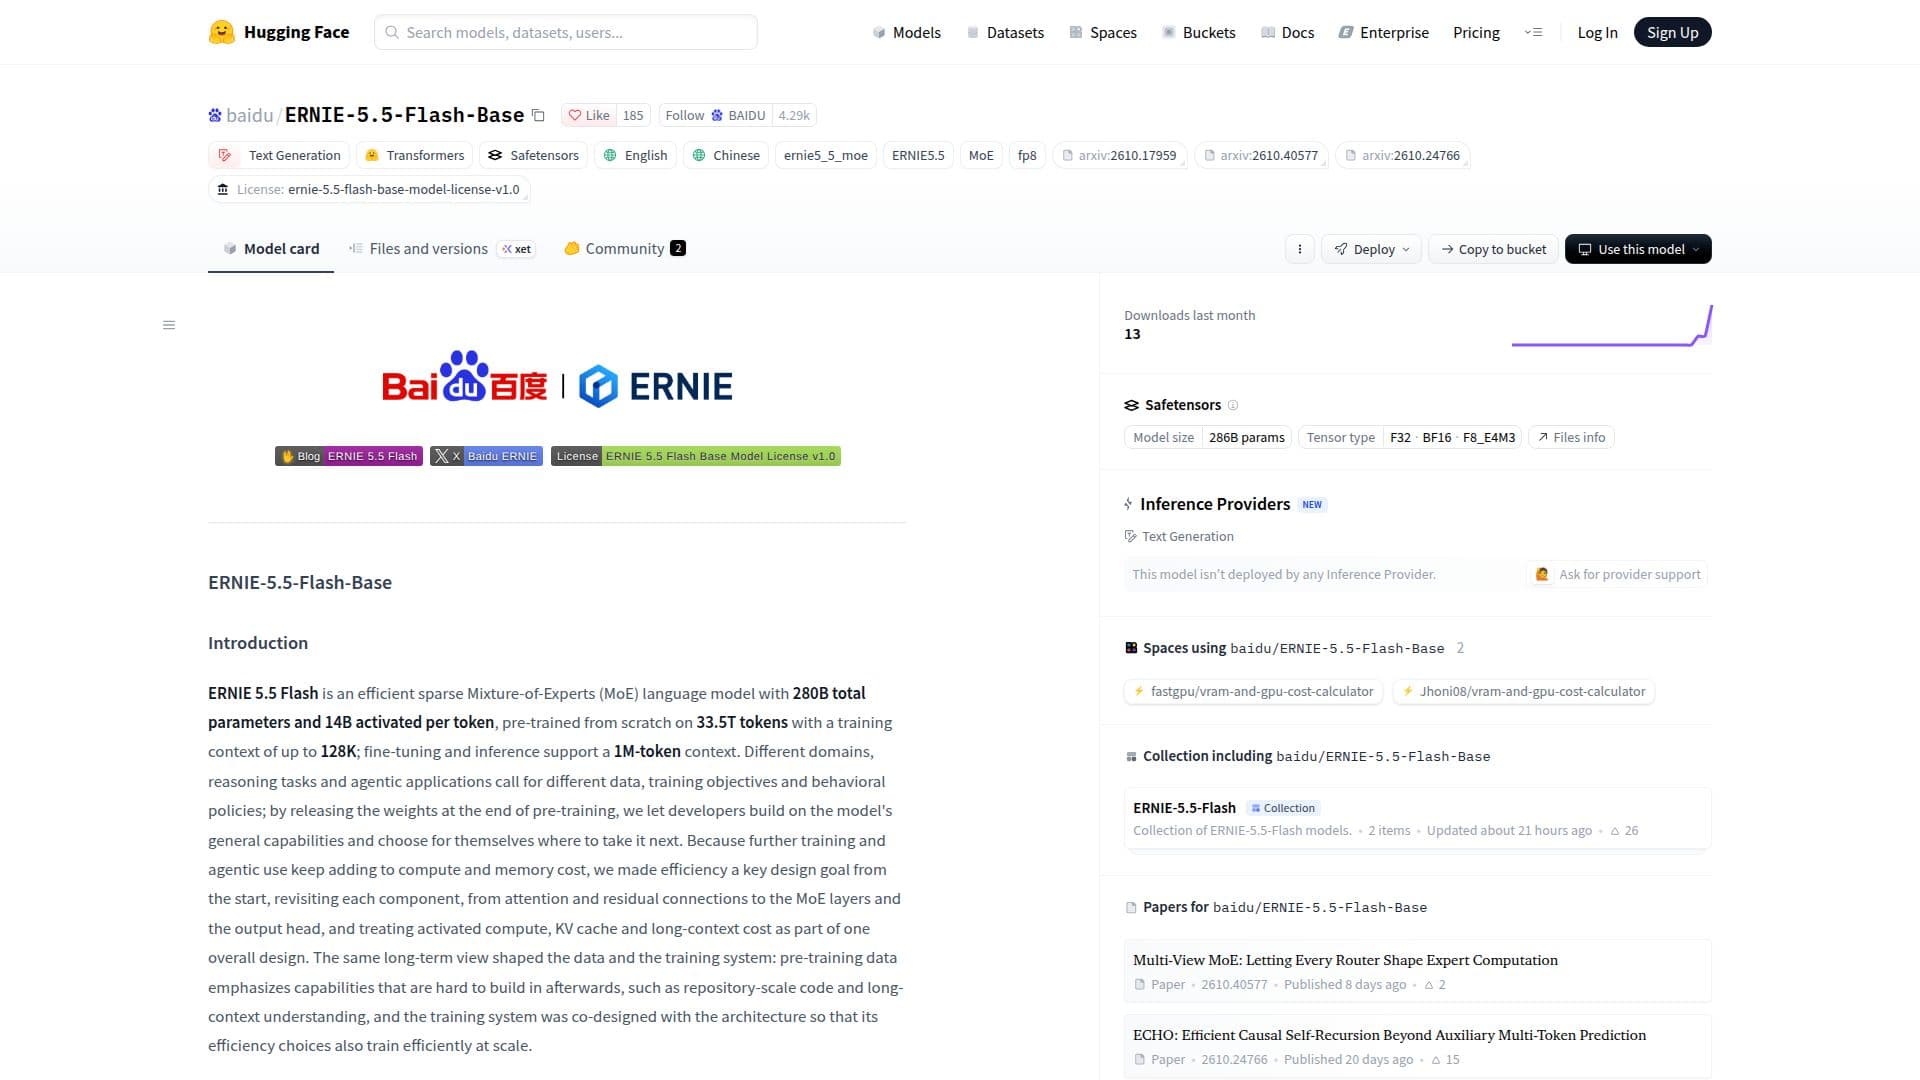
ERNIE-5.5-Flash-Base هو نموذج متطور لتوليد النصوص تم تطويره بواسطة Baidu، ومتوفر على Hugging Face. إنه نموذج لغوي فعال من نوع Mixture-of-Experts (MoE)، يتميز بـ 280 مليار معلمة إجمالية مع 14 مليار معلمة مفعلة لكل رمز. تم تدريبه مسبقًا من الصفر على مجموعة بيانات واسعة تضم 33.5 تيرابايت من الرموز، باستخدام سياق تدريبي يصل إلى 128K. لدعم التخصيص والاستدلال، يدعم طول سياق مثير للإعجاب يصل إلى 1 مليون رمز.
قراءة المزيد
تم تصميم ERNIE 5.5 Flash مع الكفاءة كهدف أساسي، حيث يعيد النظر في كل مكون، من آليات الانتباه والاتصالات المتبقية إلى طبقات MoE ورأس الإخراج. تأخذ هذه المقاربة الشاملة في الاعتبار تكاليف الحساب المفعلة، وذاكرة KV، وتكاليف السياق الطويل كجزء من تصميم متكامل. تركز بيانات التدريب على القدرات التي يصعب بناؤها بعد التدريب، مثل فهم الشيفرات على نطاق المستودع وفهم السياقات الطويلة. تم تصميم نظام التدريب بالتعاون مع الهيكل لضمان التوسع الفعال.
يمثل ERNIE-5.5-Flash-Base نقطة التحقق في نهاية التدريب المسبق، مما يجعله أساسًا مثاليًا للمطورين. يسمح بتكييف المجالات، وضبط التعليمات، وأبحاث التعلم المعزز. يظهر النموذج نتائج قوية عبر خط تقييم موحد، يغطي المعرفة، والتفكير، والرياضيات، والشيفرة، والمهام متعددة اللغات، ومعايير السياقات الطويلة. يتم تقييم أدائه مقارنةً بنماذج كبيرة أخرى مثل DeepSeek-V4-Flash-Base، وHy3-preview-Base، وMiMo-V2.5-Base، جميعها تم تقييمها تحت ظروف متسقة.
تتضمن البنية المعمارية نموذج MoE هجين مع 280B-A14B مع 43 طبقة، بما في ذلك 1 FFN كثيف و42 طبقة MoE متعددة الموجهات. تحتوي على 37 طبقة انتباه مضغوط بشدة (HCA) و6 طبقات انتباه متعددة الرؤوس مع انتباه متفرق (MLA + DSA). يستخدم النموذج 512 خبيرًا موجهًا (الأعلى 10) بالإضافة إلى خبير مشترك واحد لكل طبقة MoE. تشمل الابتكارات الرئيسية انتباه MLA + HCA الهجين مع أبعاد رأس محددة لكل طبقة، والانتباه المغلق منخفض الرتبة، والانتباه الافتراضي للرأس (VHA)، وMoE متعدد الموجهات، وECHO لتوقع الرموز المستقبلية، والاتصالات الفائقة المقيدة بالمنحنيات (mHC)، ورأس الإخراج MultiMax. يستخدم المحلل اللغوي محلل BPE يحتوي على ≈200K إدخال يقوم بتحليل الأرقام من اليمين إلى اليسار في مجموعات تصل إلى ثلاثة أرقام.
يدعم نشر ERNIE-5.5-Flash-Base مع SGLang وvLLM، مما يمكّن من تقديم الخدمة الإنتاجية مع أطوال سياق تصل إلى 1,048,576 رمز للاستدلال في السياقات الطويلة. يتم توفير النموذج بموجب اتفاقية ترخيص نموذج ERNIE 5.5 Flash Base v1.0، مع حقوق الطبع والنشر المحتفظ بها بواسطة Baidu.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
أبرز ملامح ERNIE-5.5-Flash-Base
280 مليار معلمة إجمالية مع 14 مليار مفعلة لكل رمز
تم تدريبه مسبقًا على 33.5 تيرابايت من الرموز
يدعم سياق 1 مليون رمز للتخصيص والاستدلال
بنية MoE فعالة ومتفرقة
انتباه MLA + HCA الهجين مع أبعاد رأس محددة لكل طبقة
انتباه مغلق منخفض الرتبة وانتباه افتراضي للرأس (VHA)
MoE متعدد الموجهات مع 512 خبيرًا موجهًا و1 خبير مشترك
ECHO لفقدان متعدد الآفاق وفك تشفير تخميني
اتصالات فائقة مقيدة بالمنحنيات (mHC) لنقل الإشارة
رأس الإخراج MultiMax لتوزيع مفردات أكثر حدة
محلل BPE يحتوي على ≈200K إدخال مع تحليل الأرقام من اليمين إلى اليسار
يدعم النشر مع SGLang وvLLM
أداء قوي عبر المعرفة، والتفكير، والرياضيات، والشيفرة، والمهام متعددة اللغات، ومعايير السياقات الطويلة
أوزان دقة FP8 وBF16 متاحة
البدء مع ERNIE-5.5-Flash-Base
الوصول إلى النموذج: انتقل إلى صفحة ERNIE-5.5-Flash-Base على Hugging Face.
تنزيل النموذج: اختر بين دقة FP8 (safetensors) أو BF16 (safetensors) للتنزيل.
تثبيت أدوات النشر: قم بتثبيت vLLM وملحق ERNIE 5.5، أو استخدم صورة Docker مسبقة البناء الرسمية لـ SGLang.
إطلاق الخادم: ابدأ خادم vLLM أو SGLang لاستضافة النموذج.
إرسال الطلبات: استخدم curl أو عملاء API آخرين لإرسال الطلبات إلى نقطة النهاية للتوليد النصي.
ضبط النموذج: استخدم نقطة التحقق المدربة مسبقًا لتكييف المجال، وضبط التعليمات، أو أبحاث التعلم المعزز.
حالات استخدام ERNIE-5.5-Flash-Base
- توليد النصوص
- تكييف المجال
- ضبط التعليمات
- أبحاث التعلم المعزز
- توليد وفهم الشيفرة
- فهم السياقات الطويلة
- التطبيقات متعددة اللغات
- مهام التفكير