Описание
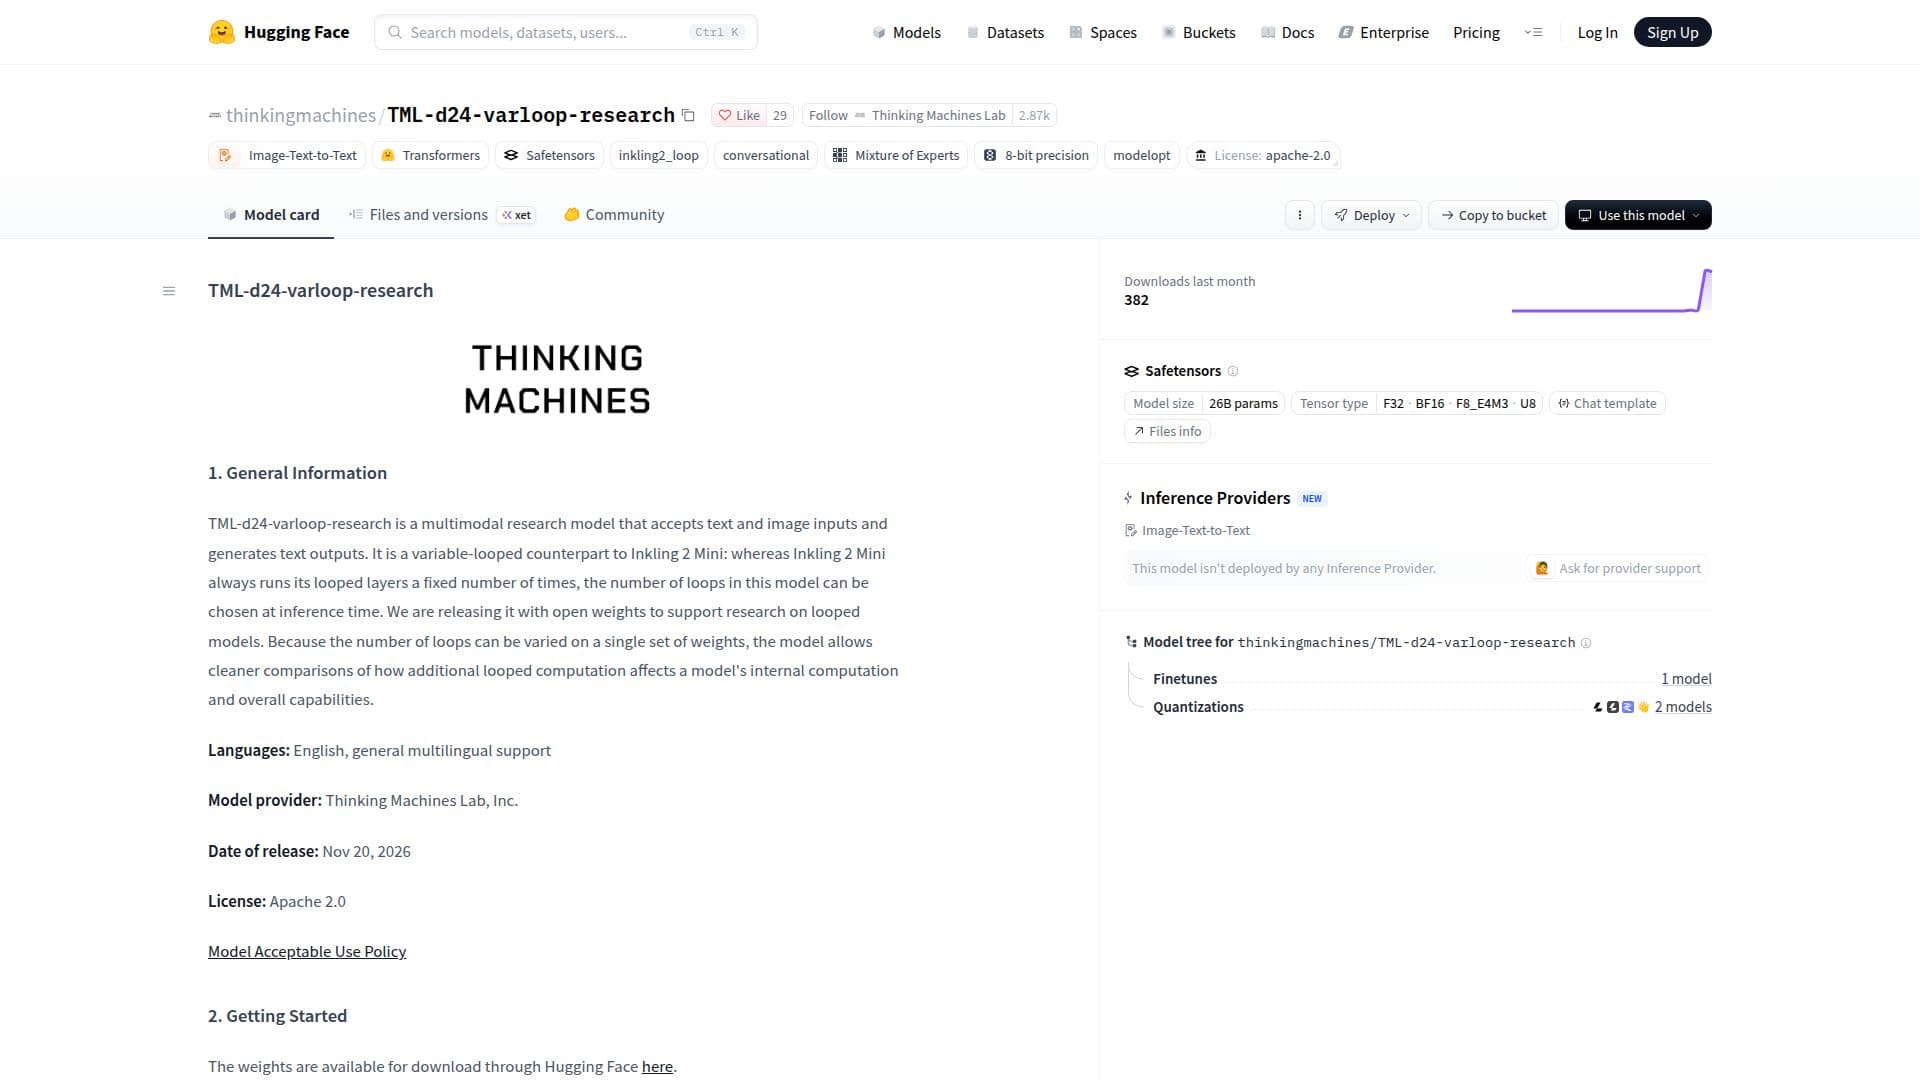
TML-d24-varloop-research — это многомодальная исследовательская модель, разработанная компанией Thinking Machines Lab, Inc., предназначенная для обработки как текстовых, так и изображенческих входных данных и генерации текстовых выходных данных. Выпущенная 20 ноября 2026 года под лицензией Apache 2.0, эта модель является значительным вкладом в область петлевых моделей, предлагая архитектуру с переменной петлей, в отличие от ее фиксированной петли, Inkling 2 Mini. Исследователи могут динамически настраивать количество петель во время вывода, что позволяет более точно сравнивать, как дополнительная вычислительная нагрузка влияет на внутренние процессы модели и ее общие возможности.
Читать далее
Модель распространяется с открытыми весами через Hugging Face, с размером контрольной точки около 20 ГБ. Она требует машину с как минимум 32 ГБ GPU или унифицированной памяти, совместимую с такими конфигурациями, как NVIDIA DGX Spark, графические процессоры NVIDIA (например, GeForce RTX 5090 или RTX PRO 6000 Blackwell) или Mac на базе Apple silicon. TML-d24-varloop-research поддерживает локальный вывод с использованием различных фреймворков, включая Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama и Exo Labs. Она также поддерживает постобучение с Miles и SkyRL.
Архитектурно TML-d24-varloop-research представляет собой трансформер только для декодирования с 24 слоями и разреженными слоями Mixture-of-Experts (MoE). Средние 12 слоев могут выполняться переменное количество раз, деля веса, и были обучены с 1 до 5 проходов. Каждый слой направляет токены к 8 из 128 экспертов, а внимание является гибридом локальных и глобальных слоев. Модель изначально многомодальна, кодируя изображения через визуальный трансформер и обрабатывая их совместно с текстом в общем скрытом пространстве. Она имеет 26,4 миллиарда параметров (3,4 миллиарда активных при 1 проходе) и поддерживает числовые форматы NVFP4 и MXFP8. Она обрабатывает текст, закодированный в UTF-8, и изображения на основе пикселей (от 40px до 4096px по размеру) с контекстным окном до 1 миллиона токенов.
Данные для обучения TML-d24-varloop-research включают широкий спектр типов контента из общедоступных источников, приобретений третьих сторон и внутренне/синтетически сгенерированных данных. Курация данных включала очистку, дедупликацию и фильтрацию для обеспечения качества и безопасности. Модель делит свое предварительное обучение и первую стадию промежуточного обучения с Inkling 2 Mini, но расходится на более поздних стадиях, особенно в своем обучении с переменной петлей, где были выбраны от 1 до 5 проходов. Хотя оценки показывают различную производительность по сравнению с Inkling 2 Mini по таким показателям, как Agentic Coding, Vision Interpretation и Reasoning, она в первую очередь предназначена как исследовательский артефакт и не рекомендуется для производственного использования из-за потенциально непредсказуемого поведения при различных количествах проходов и общих ограничений, характерных для базовых моделей, таких как галлюцинации и предвзятости из обучающих данных.
- КатегорияИИ-модели и LLM
- Модель ценообразованияОткрытый код
- РазвёртываниеРаботает локально
- ПлатформыВеб
Главное о TML-d24-varloop-research
Многомодальный ввод: Принимает как текстовые, так и изображенческие входные данные
Текстовый вывод: Генерирует текст на основе входных данных
Переменная петля: Количество петлевых слоев можно выбирать во время вывода
Открытые веса: Доступны для загрузки для поддержки исследований
26,4 миллиарда параметров: Модель крупного масштаба с 3,4 миллиарда активных параметров при 1 проходе
Многоязычная поддержка: Общая поддержка нескольких языков
Лицензия Apache 2.0: Лицензирование с открытым исходным кодом для использования и модификации
Поддержка локального вывода: Совместима с Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth, llama.cpp, Llama App, Ollama, Exo Labs
Поддержка постобучения: Может быть дообучена с Miles и SkyRL
Разреженная смесь экспертов (MoE): Использует слои MoE для прямого распространения
Гибридное внимание: Сочетает локальные и глобальные слои внимания
Нативная многомодальность: Изображения кодируются через визуальный трансформер и обрабатываются совместно с текстом
Высокое контекстное окно: Поддерживает до 1 миллиона токенов
Смешанная точность чисел: Поддерживает NVFP4 и MXFP8
Начало работы с TML-d24-varloop-research
Скачать веса: Получите доступ к весам модели через Hugging Face.
Подготовить оборудование: Убедитесь, что доступна одна машина с как минимум 32 ГБ GPU или унифицированной памяти.
Установить программное обеспечение: Настройте необходимые фреймворки вывода, такие как Hugging Face, SGLang или vLLM, вместе с их зависимостями.
Настроить модель: Загрузите контрольную точку размером 20 ГБ в выбранный вами фреймворк.
Установить проходы петли: Выберите желаемое количество петлевых слоев для вывода.
Предоставить входные данные: Введите текст, закодированный в UTF-8, и изображения на основе пикселей (размеры от 40px до 4096px) в модель.
Сгенерировать вывод: Получите текстовые выходные данные от модели на основе предоставленных входных данных.
Варианты использования TML-d24-varloop-research
- Многомодальные исследования
- Исследования петлевых моделей
- Генерация текста из изображений
- Многоязычная обработка текста
- Разработка модели с открытыми весами
- Развертывание локального вывода
- Тонкая настройка модели