Описание
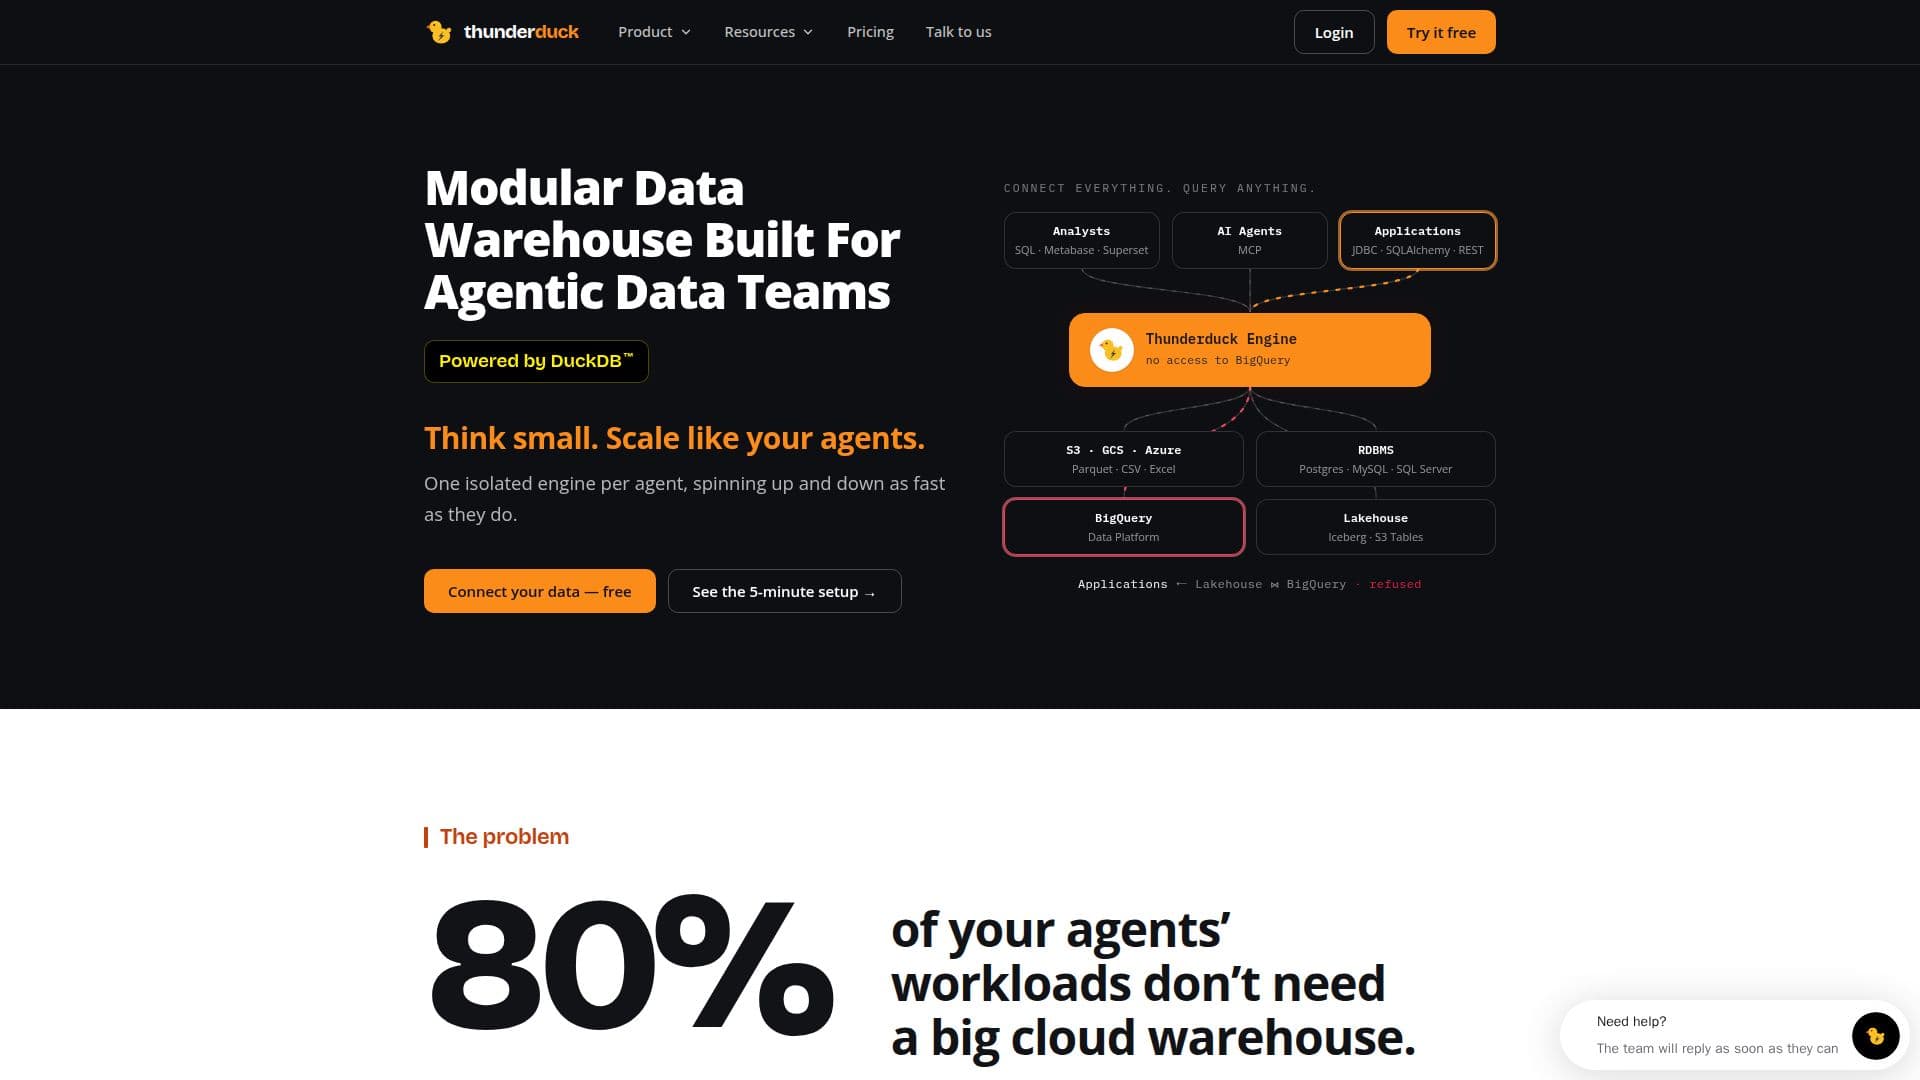
Thunderduck предлагает модульное решение для хранилища данных, специально разработанное для агентских команд по работе с данными, используя мощь DuckDB. Оно решает общую проблему, когда 80% рабочих нагрузок агентов не требуют большого облачного хранилища, но команды несут значительные затраты на распределенные системы и премии за управляемые услуги. Предоставляя один изолированный движок для каждого агента, Thunderduck позволяет быстро запускать и останавливать движки, соответствуя динамическому характеру агентских рабочих нагрузок.
Читать далее
Платформа спроектирована для выполнения запросов за доли секунды на терабайтах данных, независимо от количества работающих агентов. Она упрощает построение конвейеров данных и автоматизирует задачи DevOps, при этом поддерживая корпоративное управление. Пользователи имеют возможность развернуть Thunderduck в любом месте, будь то на месте с облачной гибкостью или в рамках существующей облачной инфраструктуры.
В своей основе Thunderduck использует DuckDB, открытое аналитическое хранилище данных с векторизированным движком. Эта архитектура означает, что оно работает там, где работает ваш код, устраняя необходимость в управлении серверами. Оно поддерживает многопользовательский режим и предлагает корпоративную безопасность, обеспечивая суверенитет данных, сохраняя данные в облаке или центре обработки данных пользователя в соответствии с их правилами доступа.
Thunderduck облегчает бесшовную интеграцию с AI-агентами, такими как Claude, ChatGPT или Cursor через MCP. Агенты могут интерпретировать значения таблиц и столбцов, а не только их названия, чтобы находить правильные таблицы, читать разделы и индексы, а также писать эффективные запросы. Эти запросы выполняются в рамках предопределенных ролей и лимитов по затратам. Платформа также может автоматизировать создание моделей dbt, следуя медальонным слоям, тестируя на ветках и открывая запросы на слияние для поддержания чистых и управляемых хранилищ данных.
Она поддерживает федерацию запросов без ETL, позволяя пользователям объединять данные из различных источников, таких как Postgres, BigQuery, таблицы Iceberg и файлы в одном запросе, с фильтрами, применяемыми к каждому источнику. Это устраняет необходимость в копиях данных, загрузочных заданиях или синхронизации для небольших и произвольных данных. Когда объемы данных растут или требуют моделирования, пользователи могут строить конвейеры dbt в Iceberg и продолжать последовательно выполнять запросы к ним. Thunderduck также предоставляет оценку затрат для каждого запроса перед его выполнением, позволяя контролировать бюджет и предотвращать неожиданные расходы.
- КатегорияAI-инструменты для SQL и баз данных
- Модель ценообразованияFreemium
- РазвёртываниеОблако, Локально
- ПлатформыВеб
Основные функции Thunderduck
Модульная архитектура хранилища данных
Один изолированный движок DuckDB для каждого агента
Запросы за доли секунды на терабайтах данных
Варианты развертывания на месте или в облаке
Автоматизированные задачи DevOps
Корпоративное управление
Поддержка многопользовательского режима
Низкая задержка без распределенных накладных расходов
Суверенитет данных и правила доступа
Интеграция с AI-агентами (Claude, ChatGPT, Cursor) через MCP
Генерация запросов с помощью AI и создание моделей dbt
Федерация запросов из различных источников (PostgreSQL, BigQuery, Iceberg, S3)
Автоматическое обнаружение схем, таблиц, столбцов и типов
Оценка затрат и времени выполнения для каждого запроса перед выполнением
Диагностика неудачных запросов с помощью AI и предложенные исправления
Контроль доступа на основе ролей для каталогов
Кэширование запросов для мгновенных, бесплатных повторных запросов
Как использовать Thunderduck?
Подключите каталог: предоставьте учетные данные для ваших источников данных, таких как базы данных, хранилища, озера данных или объектное хранилище.
Обнаружьте данные: Thunderduck автоматически считывает схемы, таблицы, столбцы и выводит значения столбцов, поддерживая их актуальными.
Запрашивайте и объединяйте: обращайтесь к любой таблице как catalog.schema.table и объединяйте данные из нескольких источников в одном SQL-запросе.
Интегрируйте AI-агентов: подключите Claude, ChatGPT или другие клиенты MCP, чтобы AI-агенты могли просматривать каталоги и выполнять SQL.
Автоматизируйте рабочие процессы: планируйте SQL-запросы по расписанию cron или подключайте репозитории dbt для выполнения сборок, тестов и снимков.
Мониторьте и управляйте: используйте предварительные оценки затрат на запросы, журналы аудита и контроль доступа на основе ролей для управления использованием и безопасностью.
Варианты использования Thunderduck
- Агентские рабочие нагрузки с данными
- Оптимизация затрат для команд по работе с данными
- Аналитика данных в реальном времени
- Автоматизация конвейеров данных
- Суверенитет и безопасность данных
- Запросы с помощью AI
- Объединение данных из разных источников
- Проактивное управление затратами
- Управление данными и аудит
- Создание озер данных