Описание
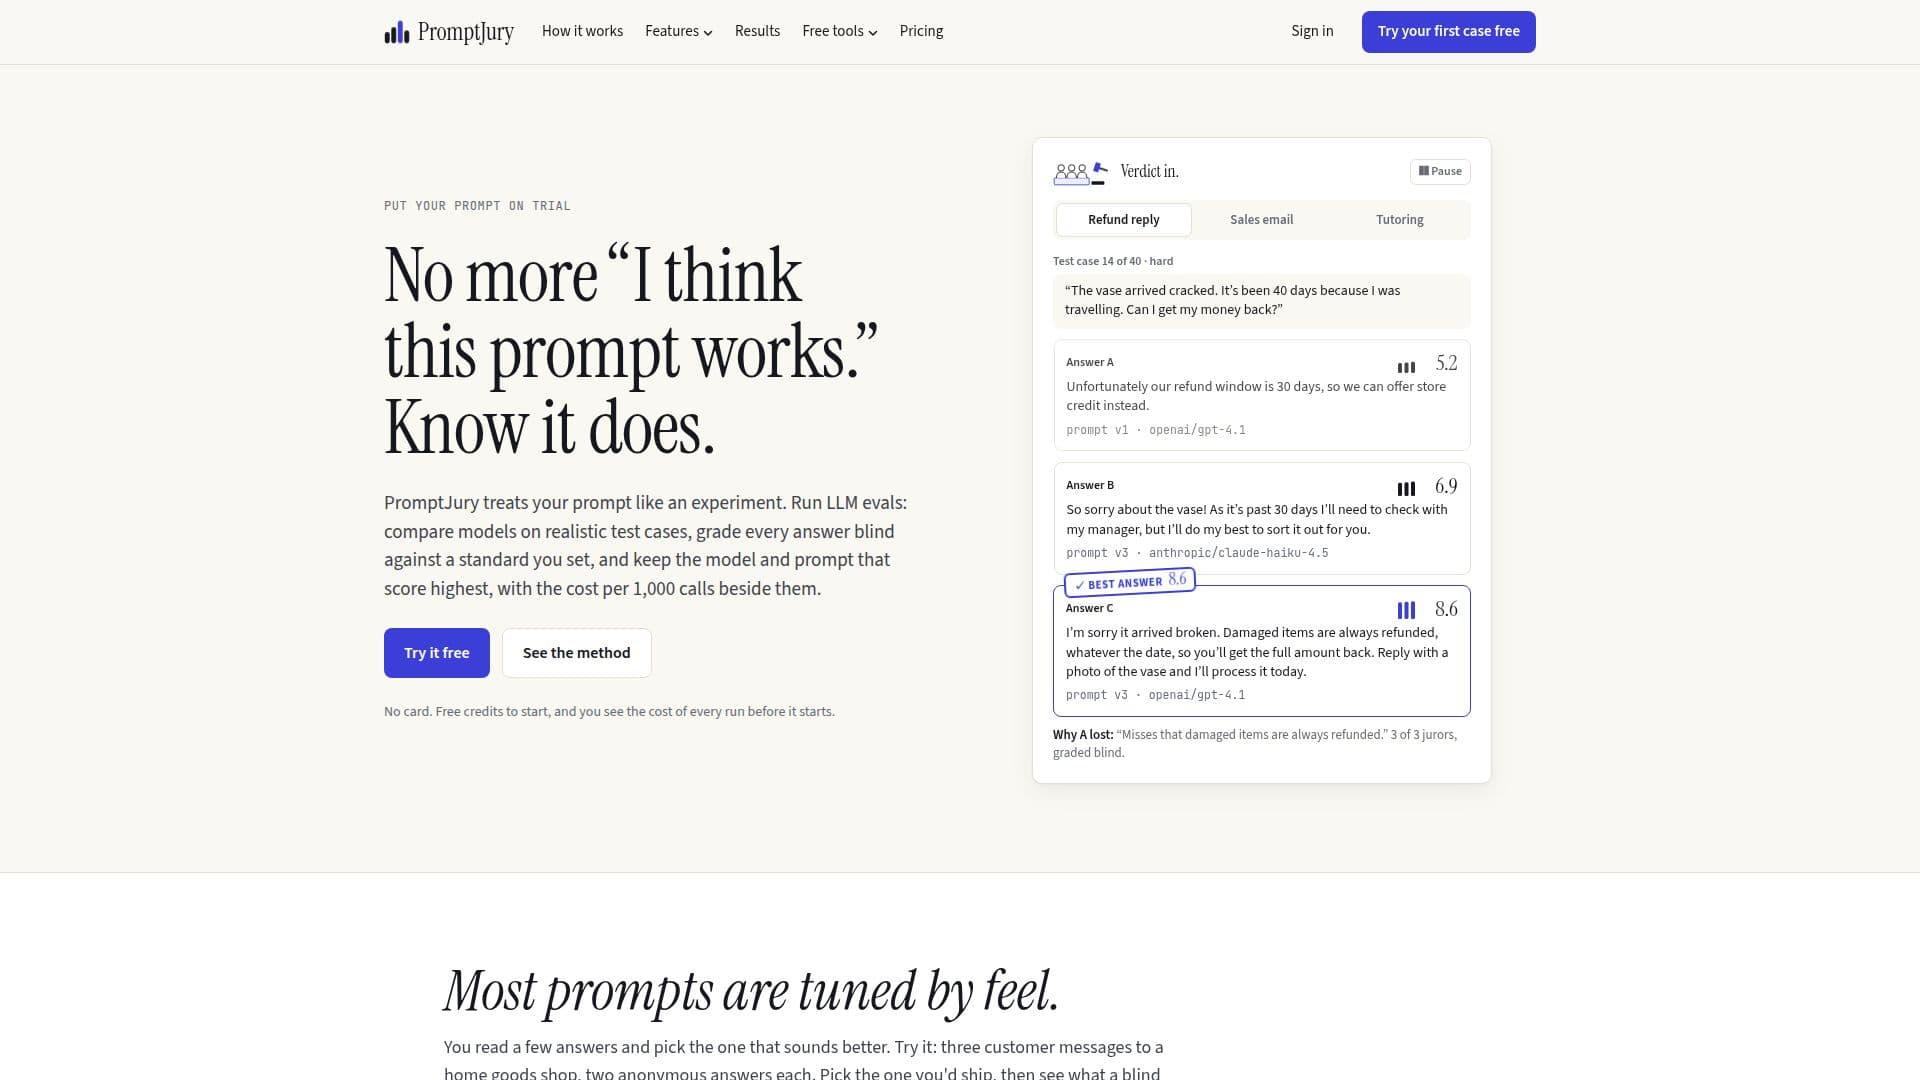
PromptJury предлагает комплексную платформу для оценки больших языковых моделей (LLM) и подсказок, предназначенную для помощи пользователям в принятии обоснованных решений на основе данных о своих AI-приложениях. Сервис позволяет отдельным пользователям и командам проводить оценки LLM на своих пользовательских подсказках, сравнивая такие модели, как GPT, Claude и Gemini, на тестовых случаях с слепой оценкой. Этот процесс показывает, какие комбинации моделей и подсказок достигают наивысших оценок и какова стоимость каждой опции, предоставляя научный подход к инженерии подсказок.
Читать далее
В отличие от платформ оценки, ориентированных на разработчиков, которые требуют SDK, пользовательских конфигураций и тестовых наборов, предоставленных пользователями, PromptJury упрощает весь процесс оценки. Он автоматически генерирует руководства по оценке и тестовые случаи, разрабатывает соперничающие подсказки и проводит слепую оценку с использованием разнообразного жюри моделей от различных производителей. Платформа затем предоставляет четкую рекомендацию, включая выигравшую подсказку, модель и ее стоимость, все это без необходимости в знаниях программирования.
PromptJury обеспечивает научную строгость своих оценок, устанавливая четкое определение «хорошего ответа» до начала оценки. Каждая подсказка и модель подвергаются одному и тому же набору тестовых случаев, а оценка проводится слепым образом. Каждая оценка представлена с диапазоном, позволяя пользователям точно оценить влияние любых изменений, внесенных в их подсказки или модели. Система решает проблемы, связанные с оценкой AI AI, обеспечивая, чтобы стандарт оценки был одобрен пользователем, несколько моделей от разных производителей оценивали ответы, не зная источника, и ни одна модель не оценивает свои собственные результаты. Медианная оценка от трех или более оценщиков предотвращает предвзятость со стороны одного строгого или щедрого члена жюри.
Пользователи могут сравнивать любую модель чата, доступную в живом списке OpenRouter, включая предложения от OpenAI, Anthropic, Google, xAI, DeepSeek и Mistral. Платформа также помогает выявить более дешевые модели, которые показывают сопоставимые результаты с ведущими конкурентами, предоставляя «выбор по стоимости» наряду с победителем. Это включает данные о стоимости за 1 000 вызовов и потенциальные ежемесячные сбережения на основе объемов вызовов, определяемых пользователем. Новые аккаунты получают 200 бесплатных кредитов для проведения первоначальной оценки без необходимости в кредитной карте, а платные планы начинаются с 25 долларов в месяц. Сервис не требует API-ключей, SDK или аккаунта OpenRouter, так как все вызовы моделей управляются через собственный аккаунт OpenRouter PromptJury и оплачиваются кредитами пользователя. Платформа поддерживает субъективные результаты, позволяя пользователям определять параметры качества с письменными примерами для оценки. Пользователи также могут загружать свои собственные тестовые случаи через файлы CSV или JSONL или редактировать сгенерированные системой. PromptJury явно заявляет, что не обучается на пользовательских подсказках или данных, обеспечивая конфиденциальность и контроль над контентом пользователя.
- КатегорияИнструменты для промпт-инжиниринга
- Модель ценообразованияFreemium
- РазвёртываниеОблако
- ПлатформыВеб
Основные функции PromptJury
Платформа оценки LLM
Сравнение моделей GPT, Claude, Gemini и других
Тестовые случаи с слепой оценкой
Автоматическая генерация тестовых случаев
Автоматическое создание руководств по оценке
Разработка соперничающих подсказок
Процесс оценки без программирования
Стоимость за 1 000 вызовов отображается
Определяет выбор по стоимости (самая дешевая хорошая модель)
Поддерживает оценку субъективных результатов
Загрузка пользовательских тестовых случаев (CSV, JSONL)
Не требуется API-ключ или SDK
Не обучается на пользовательских данных
Запланированные регрессионные тесты (повторные испытания)
Частные отчеты о вердиктах
Как использовать PromptJury?
Опишите задачу: Определите цель вашего AI и его аудиторию в двух предложениях.
Создайте руководство по оценке: Утвердите, как выглядит отличный ответ, по каждому параметру, с шкалой для каждого.
Сгенерируйте соперничающие подсказки: Позвольте моделям разрабатывать соперничающие подсказки и критиковать друг друга по вашему руководству по оценке.
Соберите тестовые случаи: Используйте сгенерированные системой реалистичные входные данные или загрузите свой собственный файл CSV/JSONL.
Запустите слепое испытание: Каждая подсказка и модель отвечают на каждый тестовый случай, с отдельной панелью, оценивающей ответы слепым образом.
Просмотрите вердикт и улучшите: Получите лучшую подсказку и модель, с доказательствами и предложениями для дальнейшего улучшения.
Варианты использования PromptJury
- Оптимизация подсказок
- Сравнение моделей
- Контроль качества
- Экономическая эффективность
- Оценка субъективных результатов
- Регрессионное тестирование
- Отчетность для клиентов
- Разработка функций AI