Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

evalship

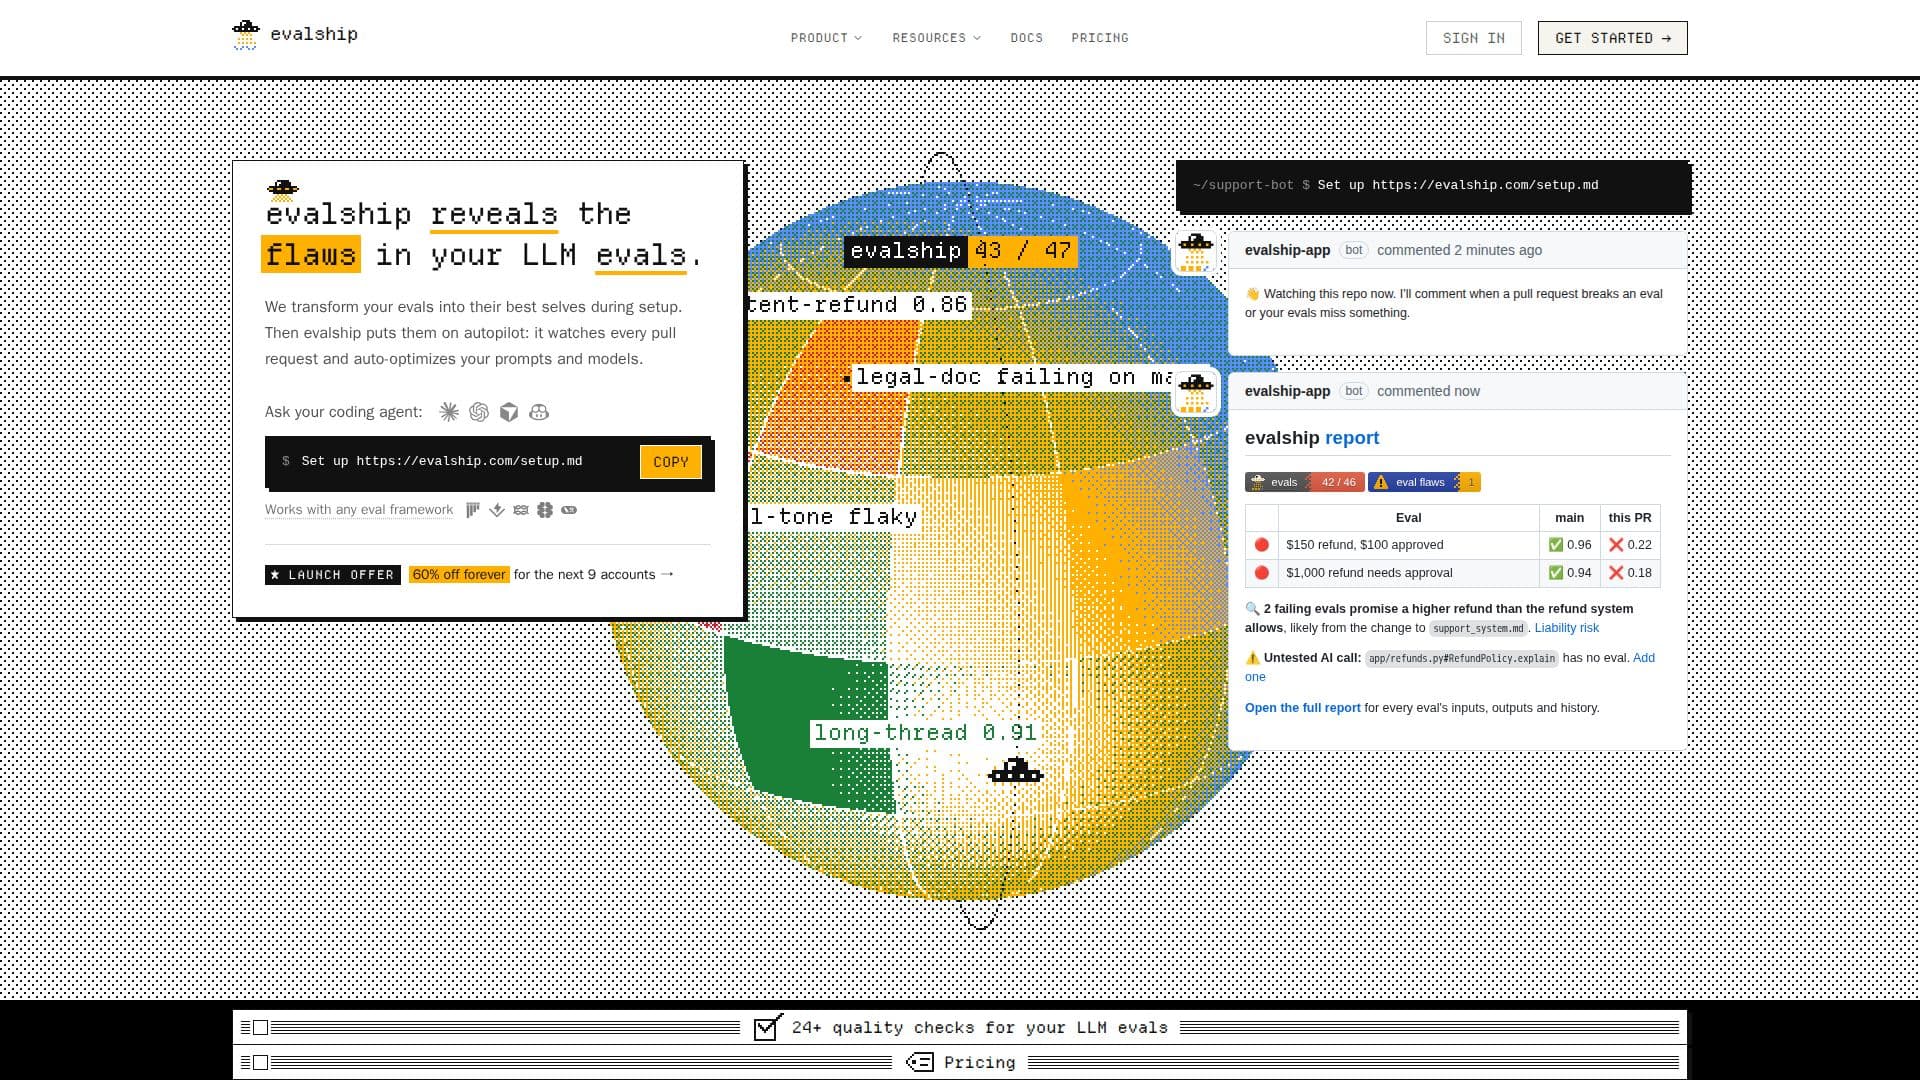
evalship обеспечивает контроль качества для оценок LLM, выявляя недостатки и оптимизируя подсказки и модели. Он интегрируется с существующими фреймворками оценки, комментирует запросы на изменение с подробным разбором того, что сломалось и почему, и помогает гарантировать, что вызовы ИИ тщательно тестируются. Платформа нацелена на автоматизацию ваших оценок LLM, улучшая надежность и производительность.

Посетить URL
Поделиться
Скриншот evalship
Скриншот evalship

evalship предлагает комплексное решение для контроля качества, специально разработанное для оценок больших языковых моделей (LLM). Он интегрируется непосредственно в ваш рабочий процесс GitHub, выступая в роли бдительного защитника вашего процесса разработки LLM. Основная цель evalship заключается в выявлении и устранении недостатков в ваших настройках оценки, обеспечивая, чтобы ваши LLM работали так, как ожидалось, и не вводили регрессии.

Читать далее

После настройки evalship тщательно проверяет ваши существующие оценщики, судей и подсказки, чтобы выявить слабые места, такие как оценки, которые неправильно проходят, или правила, которые не имеют надлежащего покрытия тестами. Затем он отслеживает каждый запрос на изменение, предоставляя немедленную обратную связь о том, что сломалось, почему это произошло и вероятной причине. Это включает в себя выявление непроверенных вызовов ИИ и отделение подлинных регрессий от ненадежных результатов оценок, анализируя историческую производительность на вашей основной ветке.

Платформа бесшовно работает с различными фреймворками оценки, включая те, которые производят JUnit XML, promptfoo JSON или evalship JSON, такие как pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust и LangSmith. Она не запускает ваши оценки напрямую; вместо этого ваш рабочий процесс GitHub Actions или кодирующий агент выполняет их с использованием ваших API-ключей, а evalship обрабатывает результаты.

Помимо выявления проблем, evalship помогает оптимизировать ваши подсказки и модели. Через вашего кодирующего агента он тестирует различные изменения на вашем компьютере, такие как более дешевые модели или более четкие правила, и сообщает, какие изменения приводят к статистически значимым улучшениям. Это позволяет командам принимать решения на основе данных для повышения производительности модели и экономической эффективности. evalship также предоставляет еженедельные отчеты, подводящие итоги производительности оценок и подчеркивающие критические проблемы, выявленные до их выхода в продукцию.

Цены включают бесплатный уровень для публичных репозиториев и одного частного репозитория с одним пользователем, предлагая 100 анализов PR и 30 дней истории оценок. Платные планы (Team, Pro, Business) предлагают больше пользователей, частные репозитории, анализы PR и более длительную историю оценок, с вариантами ежемесячной или годовой оплаты. Предложение на запуск предоставляет значительные скидки для ранних пользователей. evalship обеспечивает безопасность, не храня ваш исходный код или API-ключи, а только обрабатывая различия и результаты оценок.

  • КатегорияAI-ревью кода и тестирование
  • Модель ценообразованияFreemium
  • РазвёртываниеОблако
  • ПлатформыВеб

  • Выявляет недостатки в оценках LLM во время настройки

  • Комментирует каждый запрос на изменение с подробным разбором сбоев оценок

  • Автоматически оптимизирует подсказки и модели на основе данных о производительности

  • Работает с любым существующим фреймворком оценки (JUnit XML, promptfoo, evalship JSON)

  • Предоставляет более 24 проверок качества для оценок LLM

  • Отделяет регрессии от ненадежных оценок с использованием исторических данных

  • Обнаруживает непроверенные вызовы ИИ в запросах на изменение

  • Блокирует слияния, которые нарушают правила оценки (настраиваемо)

  • Разблокирует запросы на изменение после устранения проблем

  • Отправляет еженедельные отчеты об оценках, подводя итоги производительности и проблем

  • Поддерживает монорепозитории и несколько рабочих процессов оценки

  • Интегрируется с Langfuse, Braintrust и LangSmith без необходимости переключения

  • Предлагает бесплатный обзор оценок при настройке

  • Позволяет кодирующим агентам проверять изменения перед открытием запросов на изменение

  • Обеспечивает безопасность, не храня исходный код или API-ключи

  1. Настройка: Подключите ваш репозиторий GitHub и попросите вашего кодирующего агента настроить evalship, который проверяет ваши оценки и создает запрос на изменение для настройки.

  2. Мониторинг запросов на изменение: evalship автоматически отслеживает каждый запрос на изменение, комментируя изменения, которые нарушают оценки или вводят непроверенные вызовы ИИ.

  3. Просмотр отчетов: Получите доступ к подробным отчетам о входных данных, выходных данных и истории каждой оценки, чтобы понять, что сломалось и почему.

  4. Оптимизация: Используйте функцию оптимизации evalship для тестирования изменений подсказок и моделей с вашим кодирующим агентом, выявляя улучшения, выходящие за рамки случайности.

  5. Получение отчетов: Получайте еженедельные отчеты по электронной почте, подводящие итоги производительности оценок и подчеркивающие критические проблемы, выявленные до слияния.

  • Контроль качества оценок LLM
  • Автоматизированный обзор запросов на изменение
  • Оптимизация подсказок и моделей
  • Предотвращение регрессий
  • Обнаружение непроверенных вызовов ИИ
  • Управление ненадежными оценками
  • Снижение рисков соблюдения и ответственности
  • Улучшение рабочего процесса разработчиков
Отзывы о evalship

Загрузка...

Популярные ИИ-инструменты, похожие на evalship

LangWatch

AI-приложения

LangWatch — это платформа для тестирования AI-агентов, оценки LLM и обеспечения наблюдаемости. Она позволяет разработчикам моделировать реальные сценарии, предотвращать регрессии…

MLOps и развёртывание моделей

№13 в Инструменты для промпт-инжиниринга

Открыть инструмент

AI-приложения

Платформа для тестирования AI-агентов, оценки LLM и обеспечения наблюдаемости. Она позволяет разработчикам моделировать реальные сценарии, предотвращать регрессии…LangWatch — это платформа для тестирования AI-агентов, оценки LLM и обеспечения наблюдаемости. Она позволяет разработчикам моделировать реальные сценарии, предотвращать регрессии…

РекомендованоMLOps и развёртывание моделей
№13 в Инструменты для промпт-инжиниринга

EvalCore

AI-приложения

EvalCore предоставляет тестирование снимков для поведения ИИ, позволяя вам записывать, как ваше приложение LLM ведет себя, и воспроизводить это в CI при каждом изменении. Это…

AI-ревью кода и тестирование
Открыть инструмент

AI-приложения

Предоставляет тестирование снимков для поведения ИИ, позволяя вам записывать, как ваше приложение LLM ведет себя, и воспроизводить это в CI при каждом изменении. Это…EvalCore предоставляет тестирование снимков для поведения ИИ, позволяя вам записывать, как ваше приложение LLM ведет себя, и воспроизводить это в CI при каждом изменении. Это…

AI-ревью кода и тестирование
Топ-250: AI-приложения

Confident AI

AI-приложения

Confident AI предоставляет комплексную платформу для оценки LLM, которая оценивает AI-системы, сравнивает подсказки и модели, а также выявляет регрессии с использованием метрик,…

Платформы машинного обучения

№47 — Мониторинг AI-моделей

Открыть инструмент

AI-приложения

Предоставляет комплексную платформу для оценки LLM, которая оценивает AI-системы, сравнивает подсказки и модели, а также выявляет регрессии с использованием метрик,…Confident AI предоставляет комплексную платформу для оценки LLM, которая оценивает AI-системы, сравнивает подсказки и модели, а также выявляет регрессии с использованием метрик,…

Платформы машинного обучения
№47 — Мониторинг AI-моделей

Evidently AI предоставляет инструменты с открытым исходным кодом для оценки и мониторинга приложений ИИ. Это помогает обеспечить готовность ИИ-систем к производству, тестируя LLM…

MLOps и развёртывание моделей

№21 в MLOps и развёртывание моделей

Открыть инструмент

Предоставляет инструменты с открытым исходным кодом для оценки и мониторинга приложений ИИ. Это помогает обеспечить готовность ИИ-систем к производству, тестируя LLM…Evidently AI предоставляет инструменты с открытым исходным кодом для оценки и мониторинга приложений ИИ. Это помогает обеспечить готовность ИИ-систем к производству, тестируя LLM…

MLOps и развёртывание моделей
№21 в MLOps и развёртывание моделей

mabl

AI-приложения

mabl — это автоматизированная платформа для тестирования программного обеспечения, которая позволяет командам ускорять релизы и обеспечивать качество программного обеспечения. Она…

AI-ревью кода и тестирование

№32 в AI-ревью кода и тестирование

Открыть инструмент

AI-приложения

Автоматизированная платформа для тестирования программного обеспечения, которая позволяет командам ускорять релизы и обеспечивать качество программного обеспечения. Она…mabl — это автоматизированная платформа для тестирования программного обеспечения, которая позволяет командам ускорять релизы и обеспечивать качество программного обеспечения. Она…

AI-ревью кода и тестирование
№32 в AI-ревью кода и тестирование

Giskard OSS

AI-репозитории на GitHub

Giskard OSS — это библиотека с открытым исходным кодом для оценки и тестирования агентов LLM. Она предоставляет инструменты для оценки и улучшения производительности языковых…

AI-ревью кода и тестирование

№109 в AI-репозитории на GitHub

Открыть инструмент

AI-репозитории на GitHub

Библиотека с открытым исходным кодом для оценки и тестирования агентов LLM. Она предоставляет инструменты для оценки и улучшения производительности языковых…Giskard OSS — это библиотека с открытым исходным кодом для оценки и тестирования агентов LLM. Она предоставляет инструменты для оценки и улучшения производительности языковых…

AI-ревью кода и тестирование
№109 в AI-репозитории на GitHub

Future AGI

AI-приложения

Future AGI — это платформа с открытым исходным кодом для создания, тестирования и мониторинга ИИ-агентов. Она помогает выявлять и устранять галлюцинации ИИ в режиме реального…

MLOps и развёртывание моделей

№38 в MLOps и развёртывание моделей

Открыть инструмент

AI-приложения

Платформа с открытым исходным кодом для создания, тестирования и мониторинга ИИ-агентов. Она помогает выявлять и устранять галлюцинации ИИ в режиме реального…Future AGI — это платформа с открытым исходным кодом для создания, тестирования и мониторинга ИИ-агентов. Она помогает выявлять и устранять галлюцинации ИИ в режиме реального…

РекомендованоMLOps и развёртывание моделей
№38 в MLOps и развёртывание моделей

DeepEval

AI-репозитории на GitHub

DeepEval — это фреймворк с открытым исходным кодом, предназначенный для оценки больших языковых моделей (LLM). Он позволяет разработчикам вносить свой вклад и улучшать процесс…

MLOps и развёртывание моделей

№89 в AI-репозитории на GitHub

Открыть инструмент

AI-репозитории на GitHub

Фреймворк с открытым исходным кодом, предназначенный для оценки больших языковых моделей (LLM). Он позволяет разработчикам вносить свой вклад и улучшать процесс…DeepEval — это фреймворк с открытым исходным кодом, предназначенный для оценки больших языковых моделей (LLM). Он позволяет разработчикам вносить свой вклад и улучшать процесс…

MLOps и развёртывание моделей
№89 в AI-репозитории на GitHub
1 из 8