Descrição
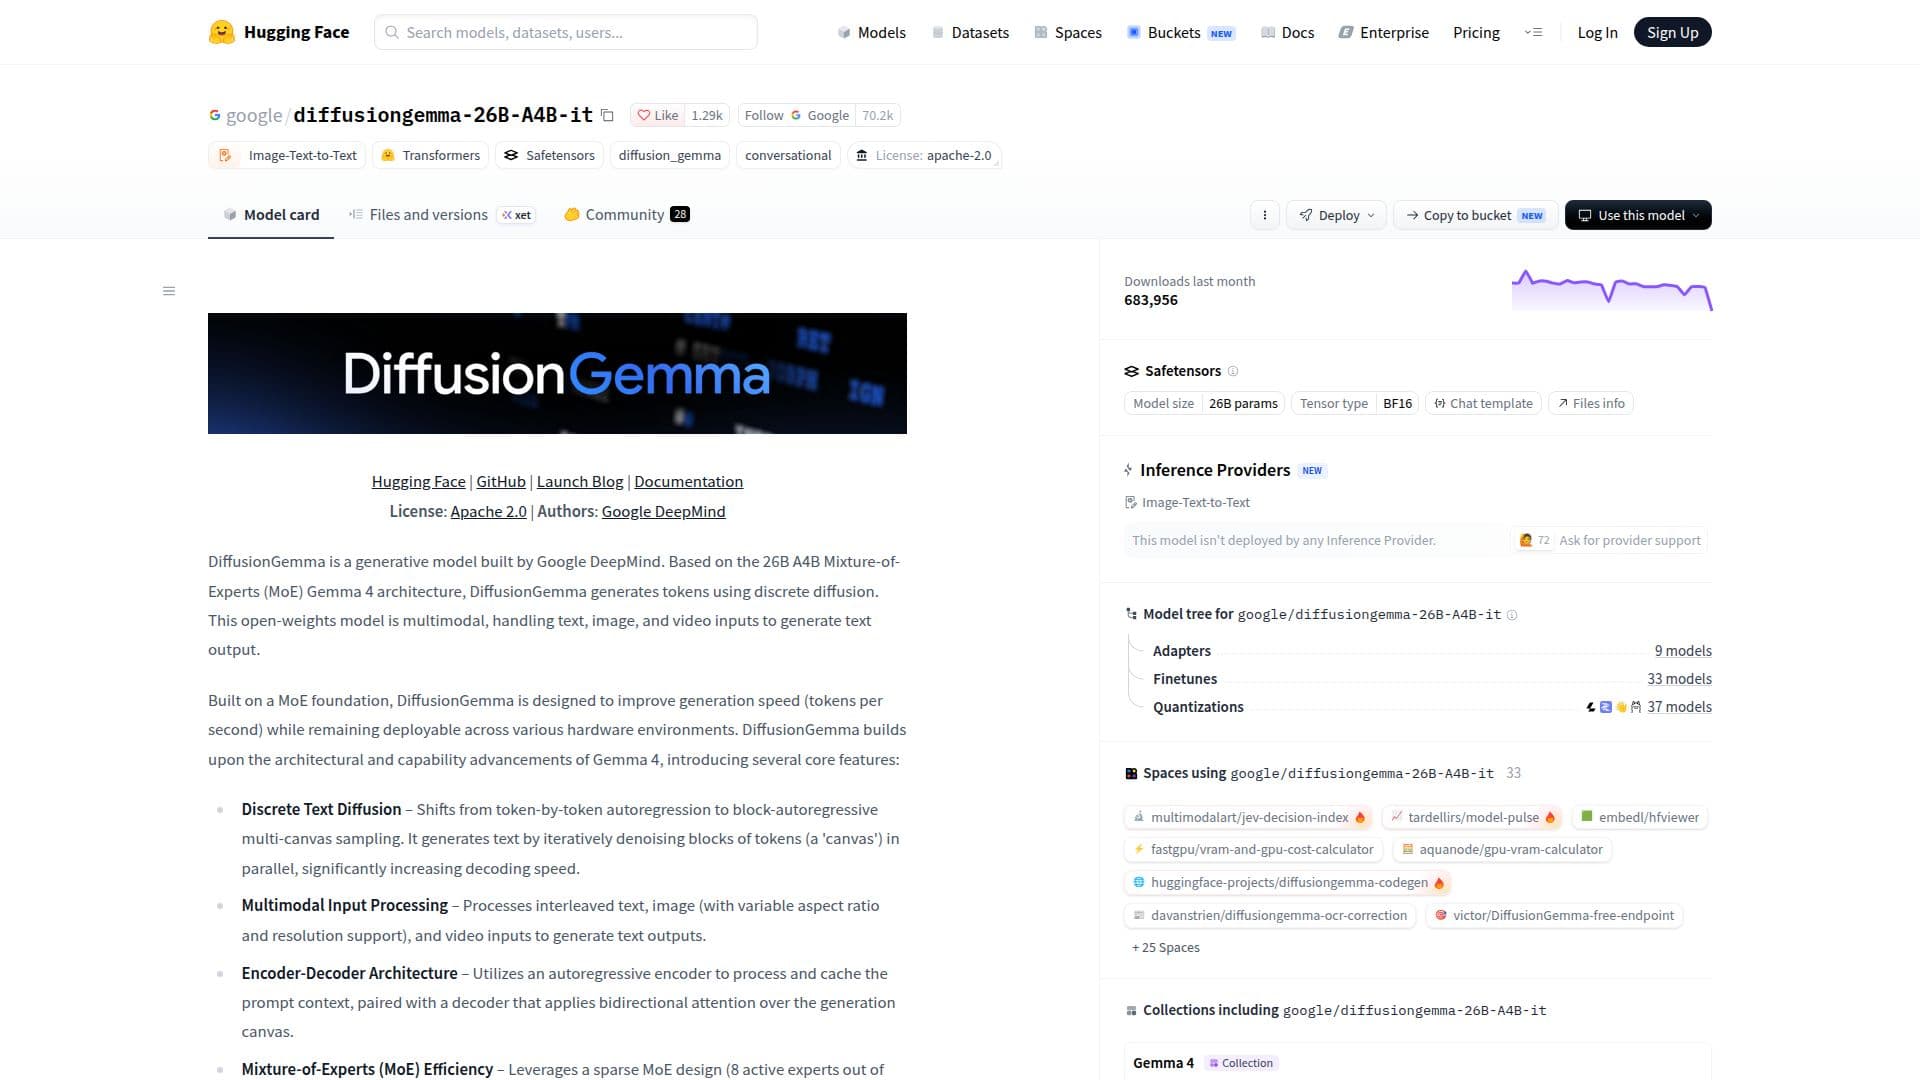
DiffusionGemma, desenvolvido pela Google DeepMind, é um modelo generativo que utiliza a arquitetura Mixture-of-Experts (MoE) Gemma 4 de 26B A4B. Ele é projetado para gerar saídas de texto a partir de entradas multimodais, incluindo texto, imagens e vídeos. O modelo emprega difusão discreta para aumentar a velocidade de geração de tokens, tornando-o adequado para implantação em diversos ambientes de hardware.
Ler mais
A arquitetura do modelo apresenta um método de amostragem multi-canvas autoregressivo em bloco, que aumenta significativamente a velocidade de decodificação ao denoiser blocos de tokens em paralelo. Essa abordagem permite que o DiffusionGemma gere texto a uma velocidade superior em comparação com modelos autoregressivos tradicionais. A arquitetura encoder-decoder utiliza um encoder autoregressivo para processar e armazenar em cache o contexto do prompt, enquanto o decoder aplica atenção bidirecional sobre o canvas de geração.
O design esparso do MoE do DiffusionGemma, com 8 especialistas ativos de 128, proporciona fortes capacidades de raciocínio enquanto mantém uma baixa ocupação de memória. Essa eficiência torna-o adequado para execução local e otimizado para inferência com tamanhos de lote pequenos, alcançando geração em alta velocidade em um único acelerador capaz.
O modelo suporta atualizações nativas de prompts do sistema, permitindo conversas estruturadas e controláveis. Ele também inclui um modo de pensamento configurável para capacidades de raciocínio aprimoradas. Com uma janela de contexto de até 256K tokens, o DiffusionGemma pode lidar efetivamente com tarefas de longo contexto.
O DiffusionGemma foi avaliado em vários benchmarks, mostrando desempenho competitivo em tarefas de geração de texto e raciocínio. Ele suporta capacidades multilíngues, pré-treinado em mais de 140 idiomas, e oferece robustas funcionalidades de compreensão de imagem e vídeo, incluindo detecção de objetos, análise de documentos e análise de conteúdo de vídeo.
No geral, o DiffusionGemma é um modelo versátil projetado para geração de texto multimodal em alta velocidade, adequado para uma ampla gama de aplicações em criação de conteúdo, pesquisa e educação.
- CategoriaModelos de IA e LLMs
- Modelo de preçosOpen Weights
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de DiffusionGemma
Difusão Discreta de Texto
Processamento de Entrada Multimodal
Arquitetura Encoder-Decoder
Eficiência Mixture-of-Experts
Modo de Pensamento
Otimizado para Inferência com Tamanho de Lote Pequeno
Suporte Nativo a Prompts do Sistema
Manipulação de Longo Contexto
Primeiros passos com DiffusionGemma
Acesse a página do modelo: Visite a página do modelo no Hugging Face
Autentique-se: Faça login ou crie uma conta
Configure: Defina os parâmetros do modelo
Envie prompts: Insira prompts de texto, imagem ou vídeo
Ajuste: Ajuste as configurações para tarefas específicas
Casos de uso de DiffusionGemma
- Geração de Texto
- Extração de Dados de Imagem
- Compreensão de Vídeo
- Suporte Multilíngue
- Pesquisa e Educação