

Os processos de direitos autorais contra IA ainda estão, na maior parte, sem solução em 2026, mas o mapa está mais claro do que um ano atrás. A Anthropic pagou US$ 1,5 bilhão para fechar acordo com autores, gravadoras estão assinando acordos de licenciamento com Suno e Udio, e o maior caso da indústria de notícias, The New York Times contra OpenAI e Microsoft, está na fase de julgamento sumário. Nenhum tribunal dos EUA decidiu que treinar um modelo de IA com obras protegidas é sempre legal, e nenhum decidiu que é sempre ilegal.
Um rastreador independente contabiliza 148 processos de direitos autorais nos EUA contra empresas de IA (ChatGPT Is Eating the World). Você não precisa conhecer todos. Este guia cobre os casos que movem a lei, em que pé cada um está agora e o que isso significa se você usa ChatGPT, Claude ou Midjourney em trabalho de verdade. Tudo o que aparece abaixo como alegação é apenas isso: alegação. Os tribunais ainda não decidiram a maioria dos casos.
Este texto é um relatório de situação, não aconselhamento jurídico. Ele foi montado a partir da cobertura dos tribunais, de rastreadores e dos termos dos próprios fornecedores, e parte dele vai ficar desatualizada rápido. Se há dinheiro de verdade em jogo numa decisão, consulte um advogado.
Em resumo: quem está ganhando os casos de direitos autorais contra IA
Ninguém está ganhando de forma clara. Veja como as peças se encaixam.
Acordos e licenças estão se acumulando mais rápido do que sentenças, o que sugere que os dois lados preferem comprar certeza a arriscar uma decisão. A única corte de apelação a se pronunciar até agora, no caso Ross, decidiu contra a empresa de IA, mas numa ferramenta não generativa. Os tribunais alemães estão lendo a mesma questão de forma mais rigorosa do que os dos EUA leriam. E, sobre o que mais interessa à maioria dos usuários, a propriedade do que a IA produz, a resposta nos EUA é estável: um humano precisa contribuir com a expressão.
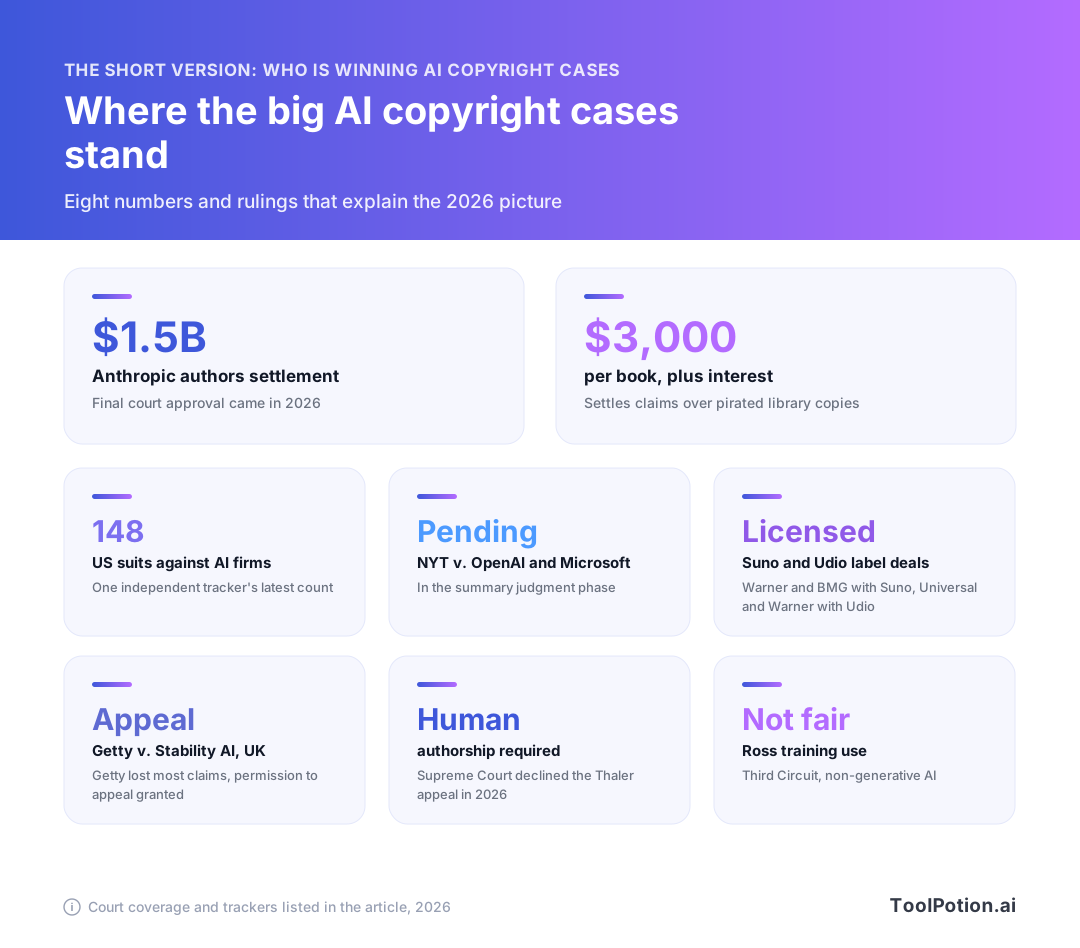
O gráfico acima resume o artigo inteiro em oito blocos. O restante explica o que está por trás de cada um.
Como chegamos até aqui, em quatro anos
A primeira onda veio em 2023. Artistas processaram Stability AI, Midjourney e DeviantArt, a Getty processou a Stability AI no Reino Unido, e o The New York Times processou OpenAI e Microsoft no fim do ano. As gravadoras vieram em 2024, com ações contra Suno e Udio. Em 2025 chegaram as primeiras decisões de verdade, e os estúdios entraram na briga: Disney e Universal processaram a Midjourney, e depois a Warner Bros. Discovery fez o mesmo.
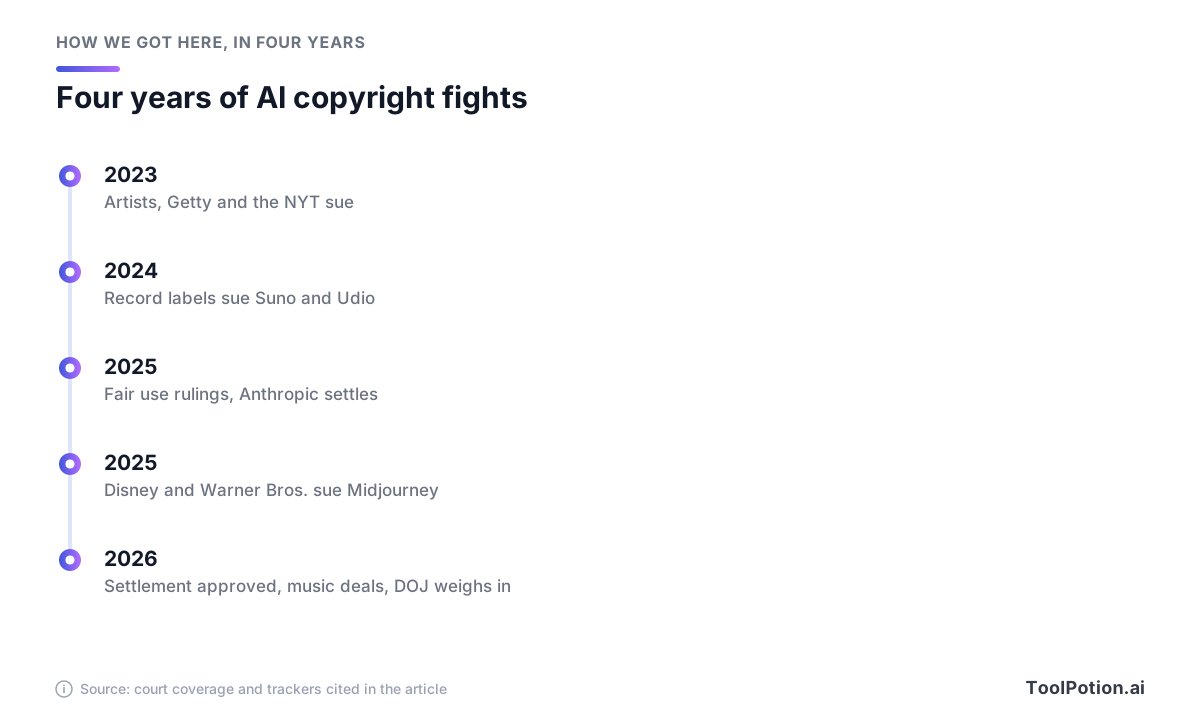
O que mudou em 2026 é que os casos pendentes começaram a amadurecer. Um grande acordo recebeu aprovação final, cortes de apelação começaram a se pronunciar e o governo dos EUA tomou partido de um dos lados. As próximas seções os apresentam por ordem de importância.
The New York Times v. OpenAI e Microsoft
Este é o caso a que a maioria das pessoas se refere quando fala em "o processo de direitos autorais contra a IA". O Times processou no fim de 2023, alegando que a OpenAI treinou com seus artigos sem permissão e que o ChatGPT e o Copilot da Microsoft conseguem reproduzi-los. A OpenAI diz que o treinamento é fair use. Os casos de outros veículos de notícias e de autores foram reunidos num único processo em Nova York, e o rastreador o descreve como "já na fase de julgamento sumário" (ChatGPT Is Eating the World).
A grande novidade recente veio de Washington. O governo Trump apresentou um memorial no tribunal federal de Manhattan em apoio à OpenAI, afirmando que o treinamento de IA em geral é fair use de material protegido. A Reuters informou que parece ser a primeira vez que o governo dos EUA se manifesta sobre a onda de casos de treinamento de IA, e observou que esse tipo de memorial tem peso consultivo, não jurídico. A resposta do Times foi que o governo estava ficando do lado das empresas de IA em prejuízo dos criadores cujo trabalho elas usaram (Reuters).
Não tire daí um veredito. Um memorial do governo é um argumento, não uma decisão, e decisões de julgamento sumário podem ser objeto de apelação. O USA Today, desde então, abriu o próprio processo contra a OpenAI, que acompanha as alegações do Times, segundo o rastreador. Ou seja, a pilha continua crescendo mesmo com o caso principal caminhando para uma decisão.
Autores v. Anthropic: o acordo de US$ 1,5 bilhão
O caso da Anthropic é o maior pagamento até agora. Autores acusaram a Anthropic de baixar livros piratas dos sites Library Genesis e Pirate Library Mirror enquanto construía seus modelos Claude. A Anthropic fechou acordo por US$ 1,5 bilhão, cerca de US$ 3.000 por obra mais juros, e a juíza Araceli Martinez-Olguin concedeu a aprovação final em 2026, segundo a Authors Guild (Authors Guild). A Anthropic não admitiu responsabilidade.
A quitação é restrita. Os autores abrem mão de reclamações sobre a aquisição e a cópia passadas de seus livros pela Anthropic. Reclamações sobre os resultados gerados pela IA e sobre condutas futuras não estão incluídas, nem as sobre obras que não constam da lista de obras do acordo (mesma fonte). Editoras musicais também processaram a Anthropic por causa de letras de músicas. Isso continua sendo alegação.
A lição para o resto do setor: a origem dos dados de treinamento importa. O dinheiro aqui foi pago por cópias piratas de bibliotecas, não pelo ato de treinar em si.
Thomson Reuters v. Ross e as decisões sobre fair use
Os dois primeiros juízes dos EUA a decidir sobre treinamento de IA e fair use, em 2025, chegaram a decisões divergentes, observou a Reuters. O marco mais recente vem de uma corte de apelação. A Ross Intelligence, uma startup que já encerrou as atividades, treinou uma ferramenta de pesquisa jurídica com os headnotes (resumos editoriais) da Westlaw. Em 2026, o Terceiro Circuito confirmou que os headnotes são protegidos por direitos autorais e que o uso da Ross não foi fair use (Courthouse News).
O painel classificou o uso da Ross como "minimamente transformativo, na melhor das hipóteses" e destacou que a Ross queria competir diretamente com a Westlaw. É uma ressalva grande para todos os demais. A Ross não era um modelo generativo, então réus como a OpenAI vão argumentar que a decisão não os alcança. Ainda assim, é a primeira palavra de uma corte de apelação sobre treinamento e fair use, e foi contra a empresa de IA.
Música, imagens e vídeo: licenças antes de sentenças
Suno e Udio
A música é onde os acordos andaram mais rápido. A Udio diz ter acordos de licenciamento com a Universal Music Group e a Warner Music Group para treinar novos modelos com os catálogos delas, e que o acordo com a Warner também encerra o litígio de direitos autorais entre as partes (Udio). A Suno anunciou parcerias com a Warner Music Group e a BMG, e diz que seus modelos v6 foram desenvolvidos com parceiros do setor, incluindo Warner, BMG e Believe. Os anúncios da Suno descrevem parcerias, não acordos judiciais, então não os tratamos como tal aqui. Não conseguimos confirmar em fontes primárias quais gravadoras, se alguma, ainda processam a Suno, então confira antes de contar com o licenciamento de um determinado catálogo.
Udio e Suno agora parecem menos réus puros e mais licenciadas de algumas gravadoras. Para você, isso significa que a resposta para "essa faixa é segura para o meu anúncio?" depende de qual catálogo uma determinada saída usou, algo que você não consegue ver. Voltamos a isso na seção prática.
GEMA, na Alemanha
Fora dos EUA, um tribunal de Munique tem sido menos amigável com as empresas de IA. A sociedade alemã de gestão coletiva GEMA venceu a OpenAI por causa de letras de músicas em 2025. Em 2026, o Tribunal Regional de Munique decidiu a favor da GEMA contra a Suno. A Teosto, sociedade de gestão coletiva da Finlândia, resume a sentença assim: o tribunal entendeu que o modelo memoriza as obras protegidas e retém cópias, de modo que tanto o treinamento com elas quanto a reprodução nos resultados configuram violação. A Suno pode recorrer (Teosto).
Fair use é uma doutrina dos EUA, então os tribunais alemães raciocinam de outra forma, mas quem vende para a Europa deve prestar atenção na direção.
Midjourney, Getty e Stability AI
Disney e Universal processaram a Midjourney em 2025, e a Warner Bros. Discovery veio em seguida. A Midjourney concordou, por estipulação, em entregar aos autores seus conjuntos de dados de treinamento de vídeo (ChatGPT Is Eating the World). Isso é fase de produção de provas, não uma decisão, mas significa que os estúdios vão poder olhar dentro dos dados de treinamento.
O caso da Getty contra a Stability AI no Reino Unido foi no sentido oposto. O juiz rejeitou as alegações de violação de direitos autorais da Getty e depois lhe deu permissão para apelar, o que, segundo a Chambers, é raro para um juiz de primeira instância (Chambers). A Getty também tem um processo separado nos EUA contra a Stability AI, que este guia não cobre. Se você usa o Stable Diffusion Web UI, de pesos abertos, a apelação no Reino Unido é a que vale acompanhar.
Veja o panorama dos principais casos.
| Caso | O que se alega | Situação atual |
|---|---|---|
| NYT e autores v. OpenAI e Microsoft | Treinamento com artigos e livros sem permissão | Fase de julgamento sumário em Nova York. Memorial do governo dos EUA apoia a OpenAI |
| Autores v. Anthropic | Treinamento com livros piratas | Acordo de US$ 1,5 bi, aprovação final em 2026 |
| Thomson Reuters v. Ross | Treinamento com headnotes da Westlaw | Terceiro Circuito confirmou: não é fair use |
| Gravadoras v. Suno | Treinamento com gravações sonoras | Parcerias anunciadas com Warner e BMG; situação das demais gravadoras não confirmada |
| Gravadoras v. Udio | Treinamento com gravações sonoras | Acordos de licenciamento com Universal e Warner (segundo a Udio) |
| Disney, Universal, Warner Bros. v. Midjourney | Treinamento com personagens e reprodução deles | Em fase de produção de provas, com dados de vídeo de treinamento a serem compartilhados |
| Getty v. Stability AI (Reino Unido) | Treinamento com fotos, uso de marca d'água | Alegações de direitos autorais rejeitadas, permissão para apelar concedida |
Onde está o risco jurídico quando você usa ferramentas de IA
A maioria dos casos acima são disputas entre detentores de direitos e empresas de IA. Eles tratam de como os modelos foram construídos. Como usuário, você está na outra ponta do pipeline, e sua exposição vem principalmente do que você publica.
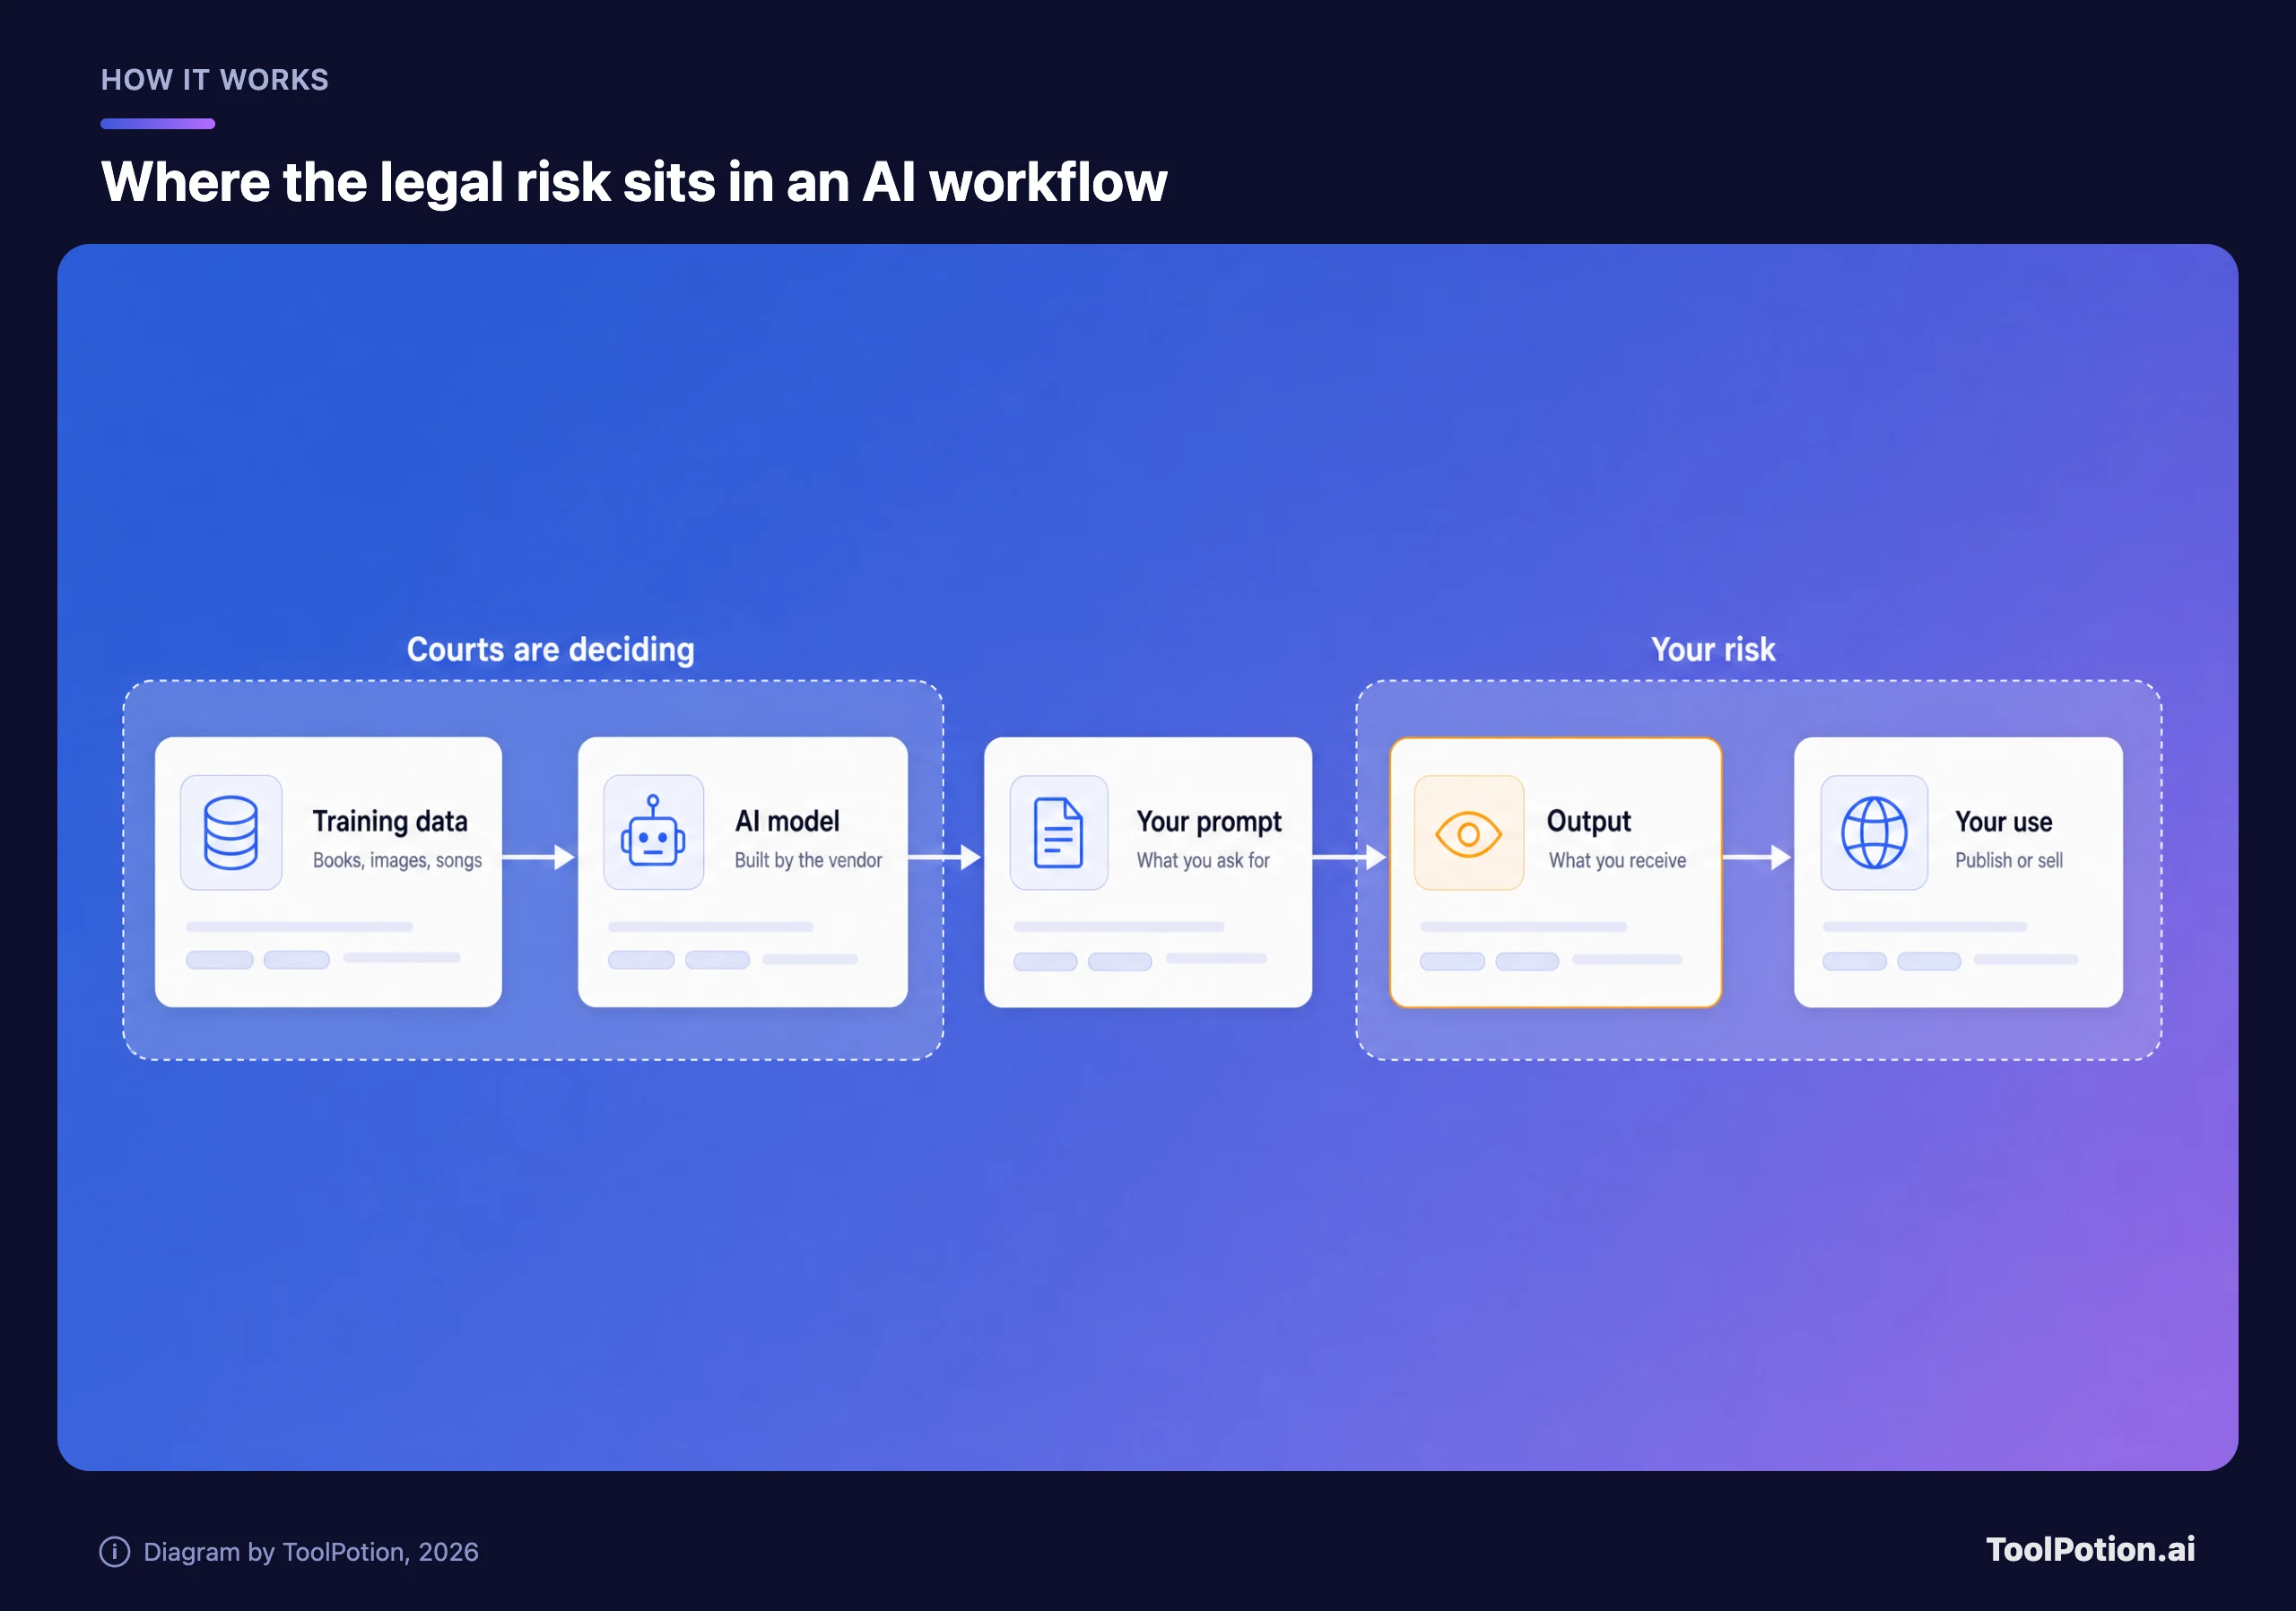
A zona da esquerda é problema dos fornecedores, pelo menos até um tribunal dizer o contrário. A da direita é sua. Processos que citam usuários finais são raros, e os movidos contra empresas de IA se apoiam, em geral, em resultados que reproduzem um personagem, uma música ou um texto específico, justamente a parte que você controla com seus prompts e sua revisão. Uma imagem genérica de paisagem ou o primeiro rascunho de um post de blog é um risco bem diferente de uma faixa que soa como a de um artista contratado.
O que as indenizações dos fornecedores cobrem, e o que não cobrem
Vários fornecedores prometem defender clientes empresariais se alguém processar por causa dos resultados. Essas promessas são cláusulas contratuais reais, e todas vêm com condições. Veja o que dizem os documentos de cada um.
| Fornecedor | O que diz | A pegadinha |
|---|---|---|
| Anthropic | Defende clientes contra reclamações de propriedade intelectual de terceiros sobre o uso pago de seus serviços ou de seus resultados (termos) | Exclui resultados modificados, combinações com outros conteúdos, seus inputs, uso indevido consciente e uso do resultado como marca no comércio |
| Microsoft | Customer Copyright Commitment: defende clientes contra certas reclamações de propriedade intelectual sobre os resultados (Microsoft) | Clientes do Azure OpenAI precisam manter as mitigações exigidas, como metaprompt, testes e filtros de material protegido |
| Google Cloud | Anunciada em 2023 como indenizações separadas para dados de treinamento e para resultados gerados. O Google agora publica uma lista de serviços cobertos (Google) | Cobre apenas os serviços de IA generativa listados (a página do Google foi modificada pela última vez em 2026), e os termos têm condições. Confira os termos atuais |
| OpenAI | Termos empresariais: defende clientes contra alegações de que os serviços violam direitos (termos) | Exclui combinações, modificações e conteúdo do cliente; também faz referência a uma indenização específica de serviço, separada |
O padrão é que a cobertura costuma valer para o uso pago, em nível empresarial, de Claude, Microsoft Copilot, Google Gemini, dos planos empresariais do ChatGPT e do GitHub Copilot. A página da Microsoft diz que as ofertas do GitHub não têm mitigações adicionais exigidas desde o início deste ano, enquanto o Copilot Studio não cobre resultados de modelos externos, a menos que rodem no Azure OpenAI com as configurações exigidas. Uma conta gratuita de consumidor normalmente não é coberta por nada disso.
As ferramentas de imagem vendem segurança de outro jeito. O Adobe Firefly apresenta seus próprios modelos como "comercialmente seguros", e o Generative AI by Getty Images é um produto do próprio detentor de direitos. Afirmações de marketing como essas dizem respeito aos dados de treinamento. Se o contrato também protege você é outra pergunta, então peça o texto da indenização, não o material de marketing.
Quem é dono do que a IA produz
O US Copyright Office resolveu a questão de política em 2025. O relatório sobre registrabilidade diz que os resultados de IA só podem ser protegidos quando um humano determina os elementos expressivos. Usar IA como ferramenta não desqualifica uma obra, mas prompts sozinhos não bastam (US Copyright Office).
Os tribunais concordam. O Circuito de D.C. entendeu que o Copyright Office agiu corretamente ao recusar o registro de uma imagem que o sistema de IA de Stephen Thaler criou sozinho, e a Suprema Corte se recusou a ouvir o recurso dele em 2026 (Supreme Court docket, Chambers). Negar o recurso não é uma decisão sobre o mérito, mas mantém de pé a decisão da instância inferior.
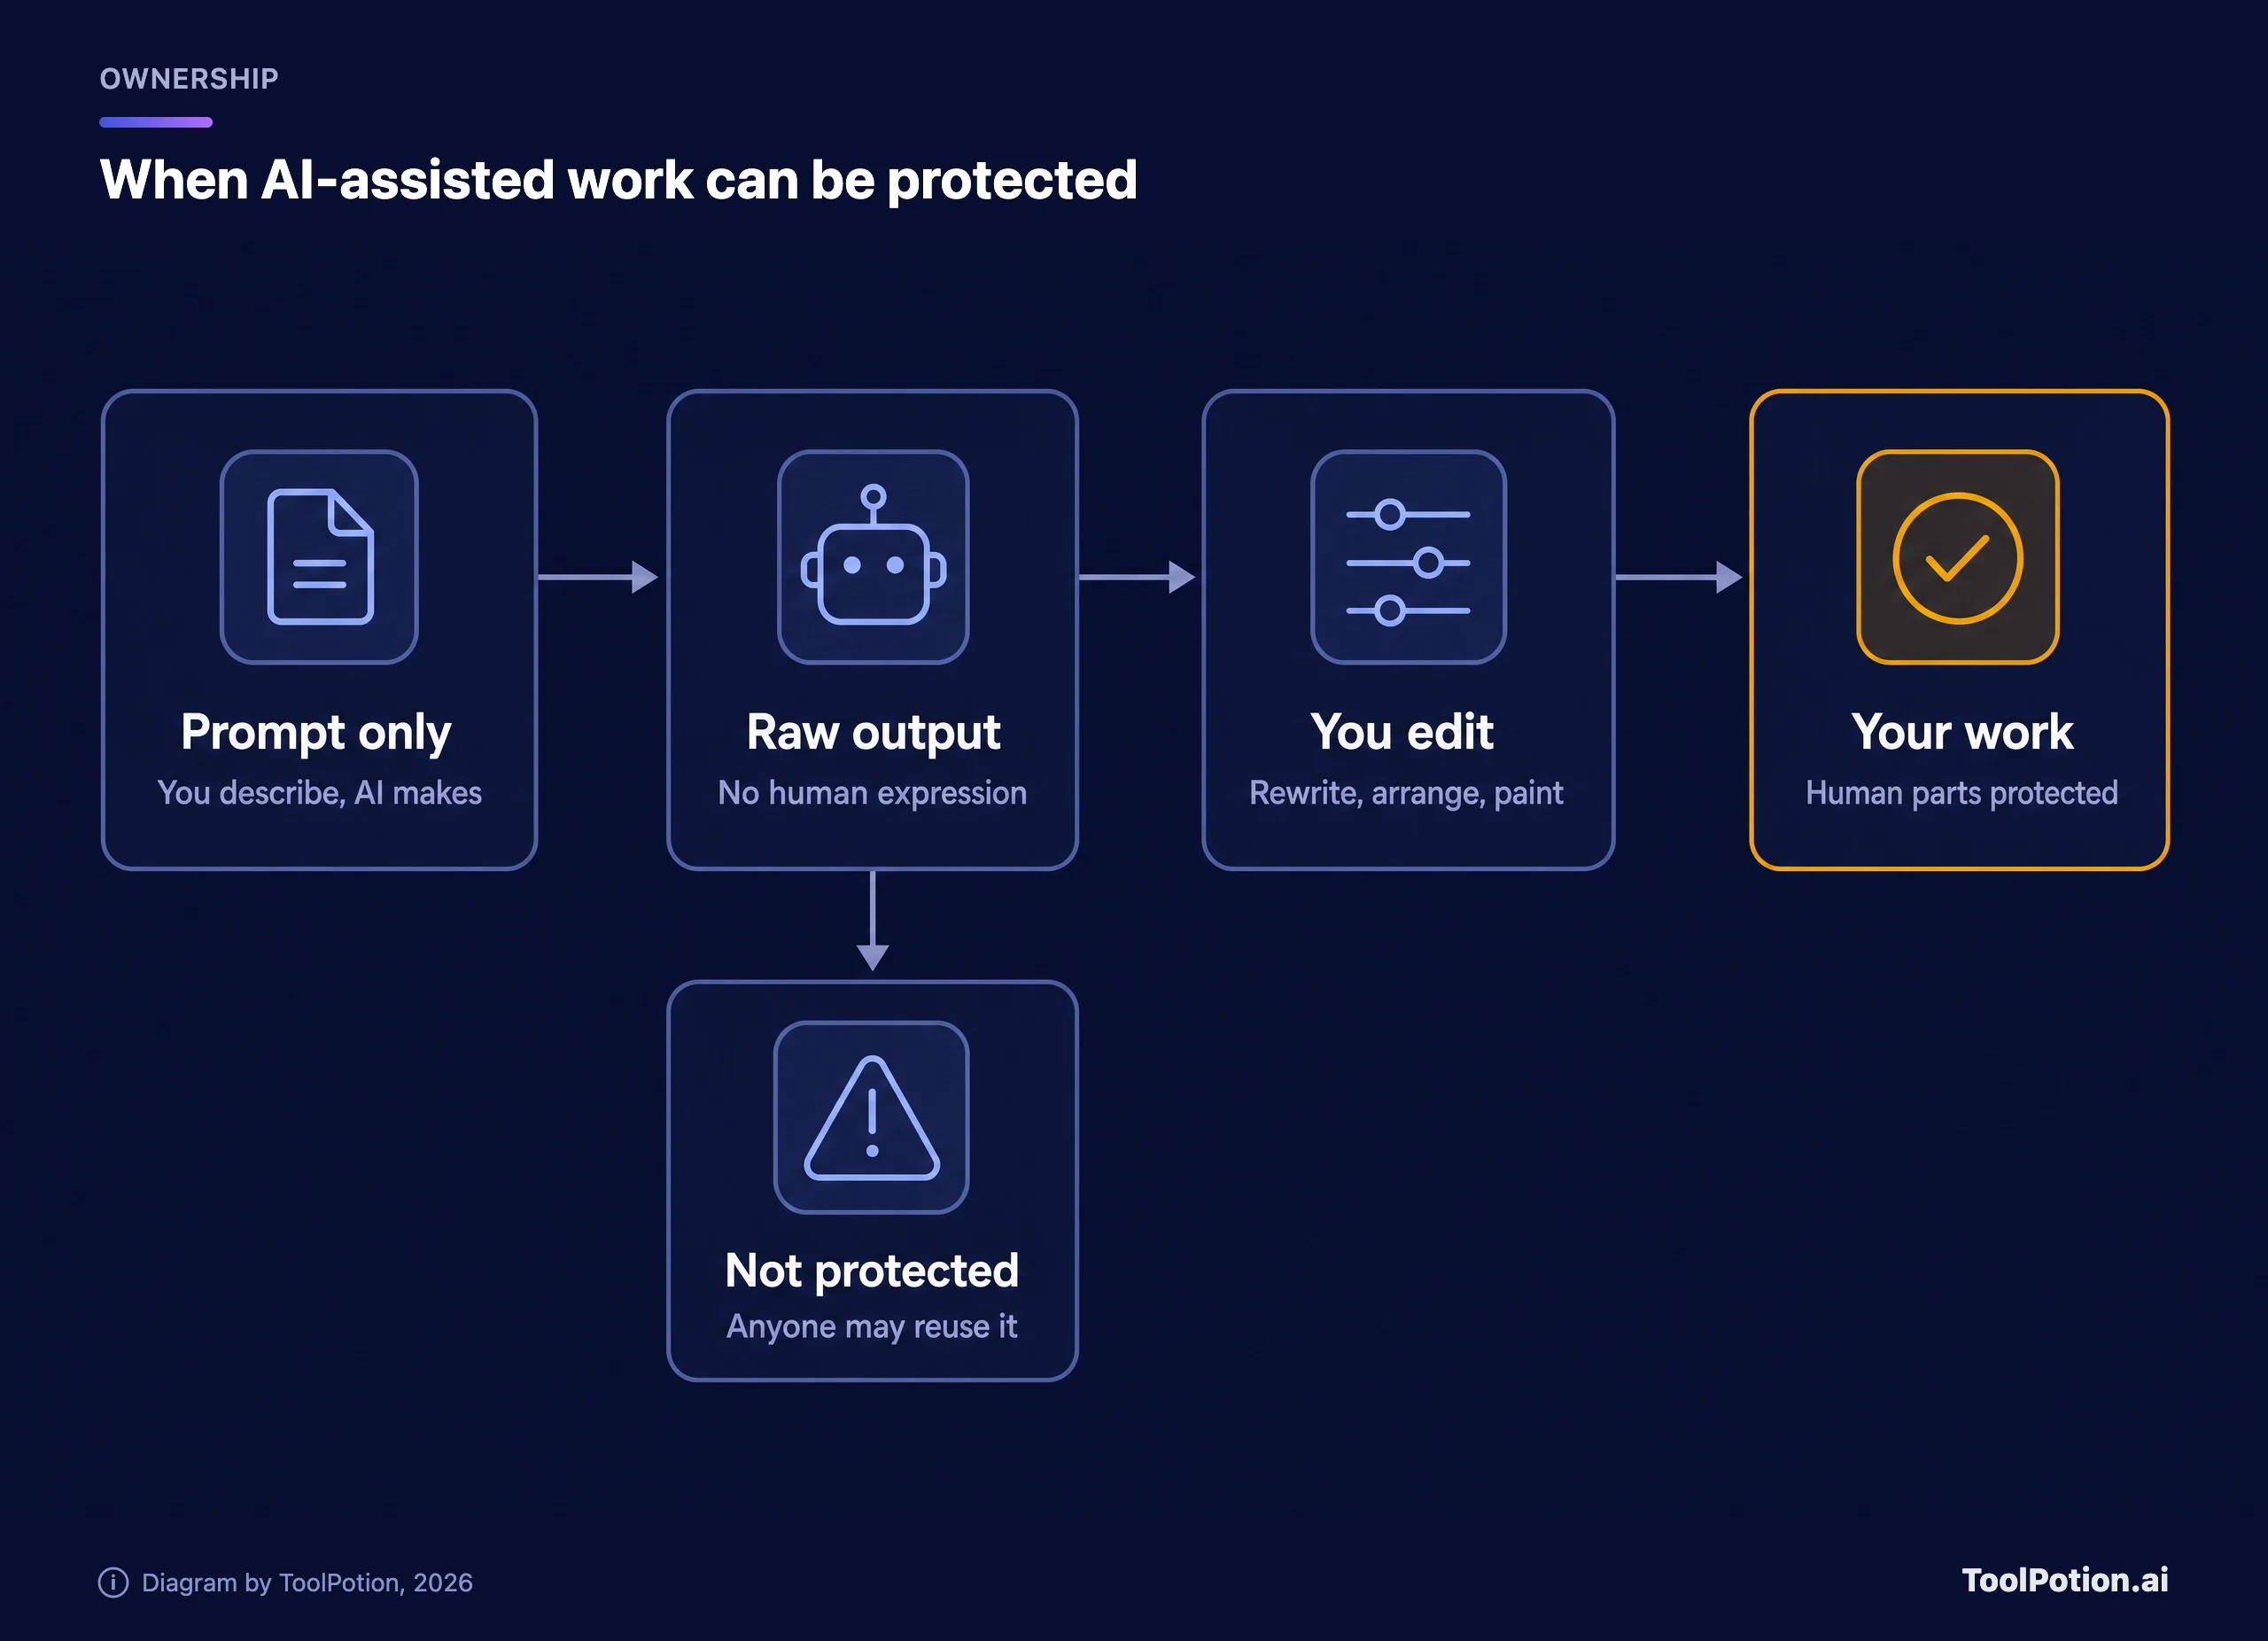
Na prática, o resultado bruto de um único prompt dá a você algo que qualquer pessoa pode copiar. Se você reescreve o texto, pinta sobre a imagem ou seleciona e organiza vários resultados em algo novo, pode reivindicar a sua contribuição humana, não a da máquina. Guarde os rascunhos e o histórico de edição, porque essa é a sua prova se alguém perguntar.
O que fazer hoje se você usa ferramentas de IA no trabalho
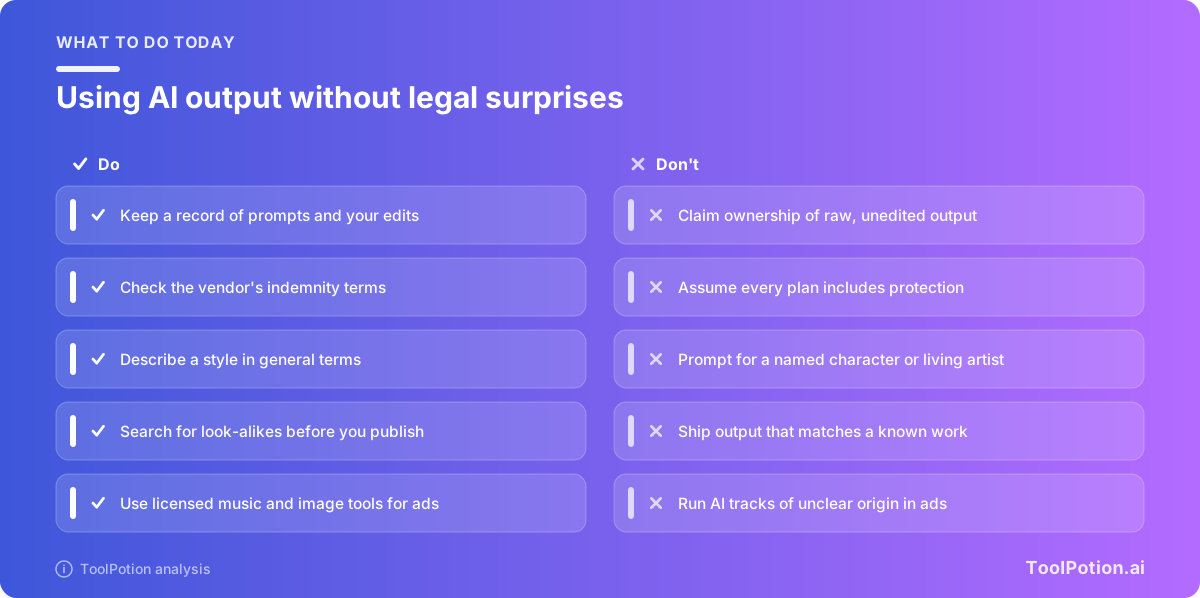
Nada disso exige um time jurídico. A maior parte da redução de risco é questão de hábito.
- Leia os termos de indenização do seu fornecedor e anote as exclusões, principalmente para resultados editados e para ferramentas que você mesmo conectou.
- Nunca use no prompt um personagem, marca ou artista vivo nominalmente identificado para algo público. É aí que os processos dos estúdios se concentram.
- Edite o que importa. Mudanças humanas reforçam sua reivindicação de ser dono do resultado e diminuem a chance de publicar algo que copia.
- Antes de um lançamento amplo, faça uma checagem de semelhança: busca reversa de imagem para figuras, uma busca rápida de trechos marcantes para texto e uma escuta atenta para música.
- Em campanhas pagas, prefira ferramentas com dados de treinamento licenciados ou termos comerciais claros, e guarde a página de termos em que você se baseou.
- Guarde prompts e rascunhos de trabalhos importantes.
Use a árvore abaixo para situar um resultado específico na escala de risco.
Depois, avalie os hábitos da sua equipe. A lista não dá garantia jurídica, mas mostra qual lacuna corrigir primeiro.
O que ainda está indefinido
Muita coisa. Nenhuma corte de apelação decidiu se treinar um modelo generativo com livros ou notícias protegidos é fair use. O caso do Times pode produzir a primeira grande decisão, seguida de uma apelação que leva anos. O relatório do Copyright Office sobre treinamento saiu numa versão pré-publicação, e a versão final ainda está por vir. Tribunais do Reino Unido, da Alemanha e dos EUA raciocinam de formas diferentes, então uma ferramenta pode estar tranquila num mercado e exposta em outro.
Os acordos também escondem informação. O acordo da Anthropic deu dinheiro aos autores, mas não gerou nenhuma decisão sobre a legalidade do treinamento em si. E os acordos musicais significam que alguns catálogos são licenciados e outros não, sem nenhum rótulo no resultado que diga qual é qual.
Se você cria produtos em cima de modelos de IA, ou vende conteúdo feito com eles, a postura sensata é assumir que as regras vão continuar mudando. Para comparar ferramentas por qualidade, e não por postura jurídica, os rankings do ToolPotion de áudio, voz e música e de editores de áudio com IA são um bom começo, e o guia de alternativas ao ChatGPT cobre o lado dos assistentes.
Perguntas frequentes
É legal as empresas de IA treinarem com obras protegidas por direitos autorais?
Ainda não está definido. O Terceiro Circuito decidiu que o treinamento da Ross com headnotes da Westlaw não foi fair use, mas a Ross não era um modelo generativo. A Anthropic pagou US$ 1,5 bilhão por livros piratas, sem decisão sobre o treinamento em si. Tribunais fora dos EUA, como o de Munique no caso Suno, aplicam regras diferentes.
Posso ser processado por usar imagens ou textos gerados por IA?
É possível, mas processos contra usuários comuns são raros. O risco aumenta se o resultado copia uma obra, personagem ou voz reconhecível, ou se você o usa em publicidade. Clientes empresariais de alguns fornecedores têm indenização, então confira em qual plano você está.
Quem é dono do conteúdo gerado por IA nos EUA?
Você pode ser dono das partes criadas por um humano, como suas edições, sua seleção e sua organização. Material gerado puramente por máquina não é protegido, e a Suprema Corte se recusou a rever o tema em 2026. Os termos dos fornecedores costumam ceder a você os direitos que existirem, mas não podem criar direitos que a lei não concede.
A Suno é segura para música comercial?
Leia os termos atuais e os detalhes dos planos da Suno antes de usar um resultado em trabalho pago. A Suno diz ter parcerias com a Warner Music Group e a BMG, e um tribunal de Munique decidiu contra a Suno no caso GEMA em 2026 (a Suno pode recorrer). O resultado vindo de um catálogo licenciado não vem identificado como tal.
Quando o caso do New York Times será decidido?
Ninguém sabe dizer ainda. O caso está em julgamento sumário, e quem perder pode apelar, o que costuma levar muito tempo. Trate qualquer decisão como uma etapa, e não como o fim.