Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

evalship

evalship fornece controle de qualidade para avaliações de LLM, identificando falhas e otimizando prompts e modelos. Ele se integra a estruturas de avaliação existentes, comenta em pull requests com análises detalhadas do que quebrou e por quê, e ajuda a garantir que chamadas de IA sejam testadas de forma abrangente. A plataforma visa colocar suas avaliações de LLM em piloto automático, melhorando a confiabilidade e o desempenho.

Visitar URL
Compartilhar
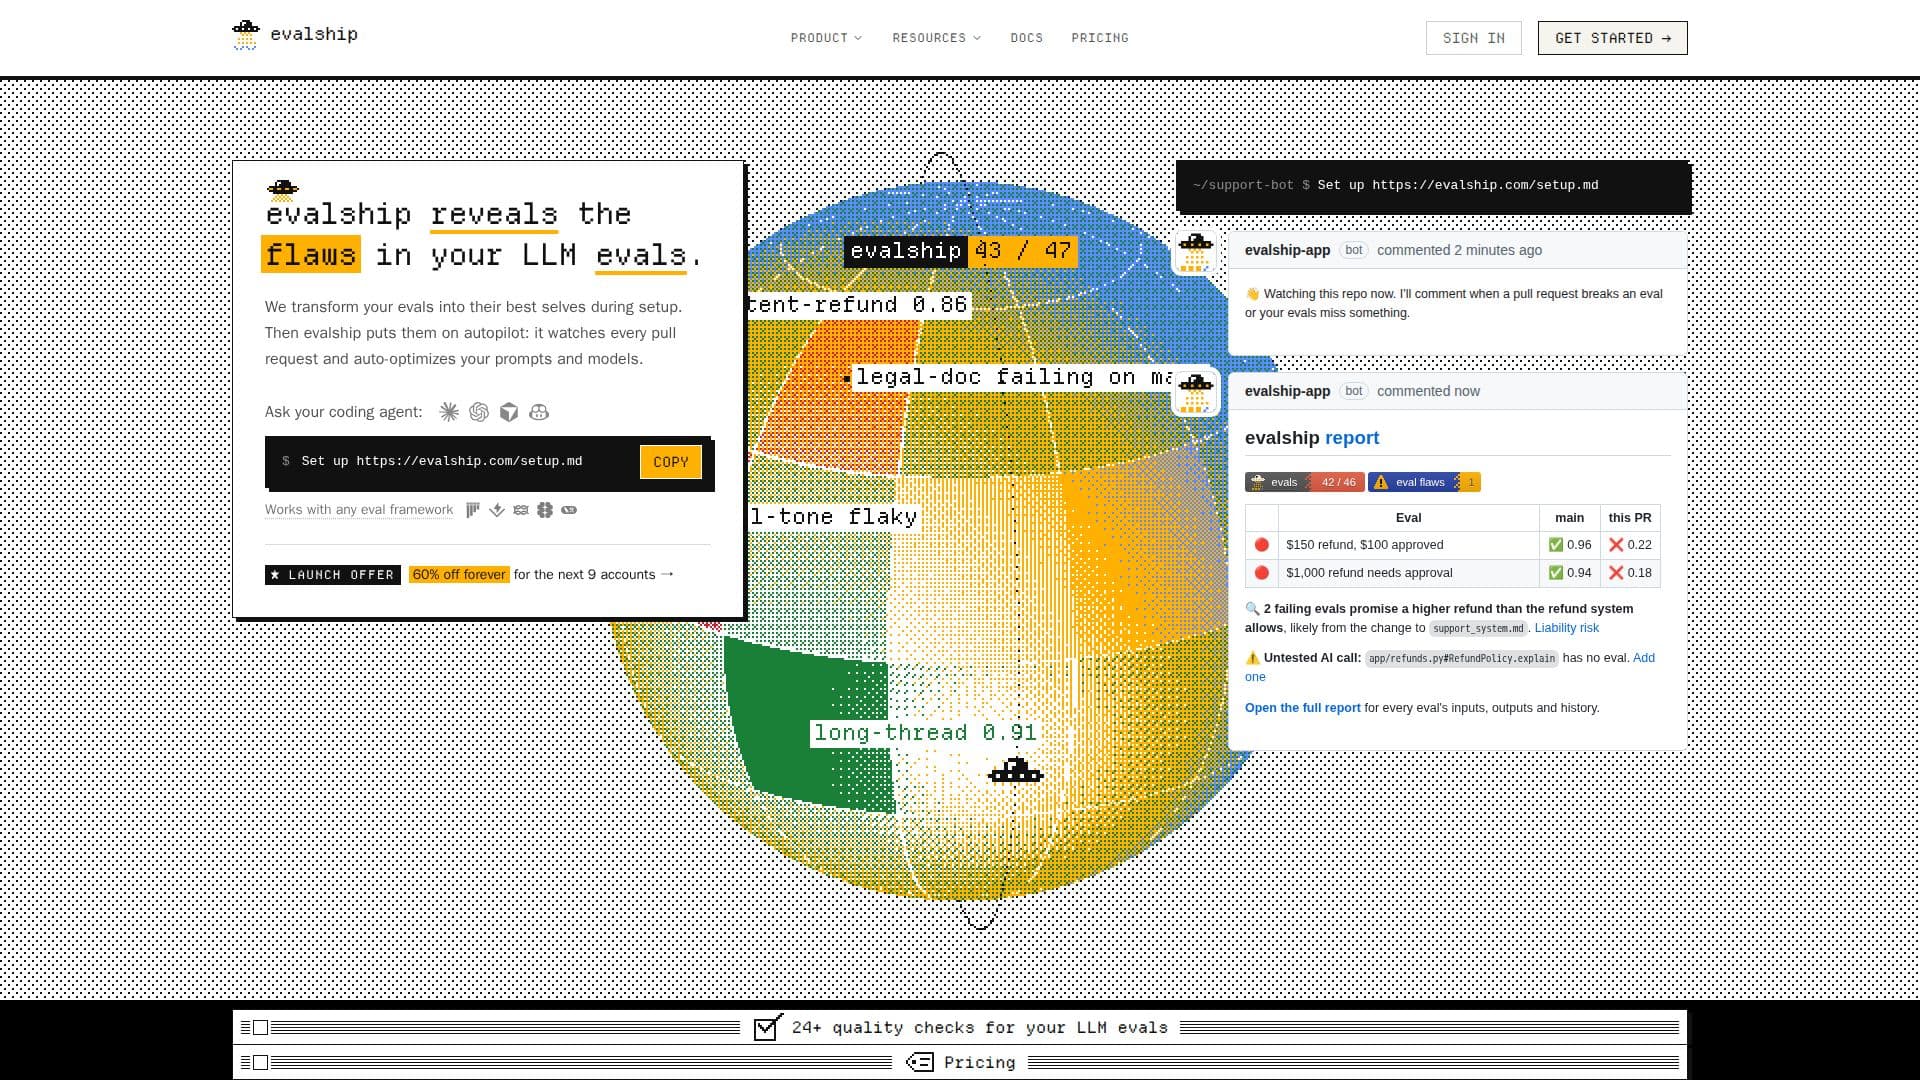
Captura de tela do evalship

evalship oferece uma solução abrangente de controle de qualidade especificamente projetada para avaliações de Modelos de Linguagem de Grande Escala (LLM). Ele se integra diretamente ao seu fluxo de trabalho do GitHub, atuando como um guardião vigilante do seu processo de desenvolvimento de LLM. O objetivo central do evalship é identificar e corrigir falhas em suas configurações de avaliação, garantindo que seus LLMs funcionem como esperado e não introduzam regressões.

Ler mais

Após a configuração, o evalship revisa minuciosamente seus avaliadores, juízes e prompts existentes para identificar fraquezas, como avaliações que passam incorretamente ou regras que carecem de cobertura de teste adequada. Ele então monitora cada pull request, fornecendo feedback imediato sobre o que quebrou, por que quebrou e a provável causa. Isso inclui sinalizar chamadas de IA não testadas e separar regressões genuínas de resultados de avaliações instáveis, analisando o desempenho histórico em seu branch padrão.

A plataforma funciona perfeitamente com várias estruturas de avaliação, incluindo aquelas que produzem JUnit XML, promptfoo JSON ou evalship JSON, como pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust e LangSmith. Ele não executa suas avaliações diretamente; em vez disso, seu fluxo de trabalho do GitHub Actions ou agente de codificação as executa usando suas chaves de API, e o evalship processa os resultados.

Além de identificar problemas, o evalship ajuda a otimizar seus prompts e modelos. Através do seu agente de codificação, ele testa diferentes alterações em sua máquina, como modelos mais baratos ou regras mais claras, e relata quais alterações geram melhorias estatisticamente significativas. Isso permite que as equipes tomem decisões baseadas em dados para melhorar o desempenho do modelo e a eficiência de custos. O evalship também fornece relatórios semanais resumindo o desempenho das avaliações e destacando questões críticas detectadas antes de chegarem à produção.

Os preços incluem um nível gratuito para repositórios públicos e um repositório privado com um usuário, oferecendo 100 análises de PR e 30 dias de histórico de avaliações. Planos pagos (Equipe, Pro, Negócios) oferecem mais usuários, repositórios privados, análises de PR e histórico de avaliações mais longo, com opções de faturamento mensal ou anual. Uma oferta de lançamento oferece descontos significativos para os primeiros adotantes. O evalship garante segurança ao não armazenar seu código-fonte ou chaves de API, processando apenas diffs e resultados de avaliações.

  • CategoriaRevisão de código e testes com IA
  • Modelo de preçosFreemium
  • ImplantaçãoNuvem
  • PlataformasWeb

  • Identifica falhas em avaliações de LLM durante a configuração

  • Comenta em cada pull request com uma análise detalhada das falhas de avaliação

  • Otimizador automático de prompts e modelos com base em dados de desempenho

  • Funciona com qualquer estrutura de avaliação existente (JUnit XML, promptfoo, evalship JSON)

  • Fornece mais de 24 verificações de qualidade para avaliações de LLM

  • Separa regressões de avaliações instáveis usando dados históricos

  • Detecta chamadas de IA não testadas em pull requests

  • Bloqueia merges que quebram regras de avaliação (configurável)

  • Desbloqueia pull requests uma vez que os problemas são corrigidos

  • Envia relatórios semanais de avaliação resumindo desempenho e problemas

  • Suporta monorepos e múltiplos fluxos de trabalho de avaliação

  • Integra-se com Langfuse, Braintrust e LangSmith sem exigir uma troca

  • Oferece uma revisão gratuita de avaliações na configuração

  • Permite que agentes de codificação verifiquem alterações antes de abrir pull requests

  • Garante segurança ao não armazenar código-fonte ou chaves de API

  1. Configuração: Conecte seu repositório do GitHub e peça ao seu agente de codificação para configurar o evalship, que revisa suas avaliações e cria um pull request de configuração.

  2. Monitore pull requests: evalship observa automaticamente cada pull request, comentando sobre alterações que quebram avaliações ou introduzem chamadas de IA não testadas.

  3. Revise relatórios: Acesse relatórios detalhados para cada entrada, saída e histórico de avaliações para entender o que quebrou e por quê.

  4. Otimize: Use o recurso de otimização do evalship para testar alterações de prompts e modelos com seu agente de codificação, identificando melhorias além da chance.

  5. Receba relatórios: Receba relatórios semanais por e-mail resumindo o desempenho das avaliações e destacando questões críticas detectadas antes da fusão.

  • Controle de Qualidade de Avaliação de LLM
  • Revisão Automatizada de Pull Requests
  • Otimização de Prompt e Modelo
  • Prevenção de Regressões
  • Detecção de Chamadas de IA Não Testadas
  • Gerenciamento de Avaliações Instáveis
  • Mitigação de Risco de Conformidade e Responsabilidade
  • Aprimoramento do Fluxo de Trabalho do Desenvolvedor
Avaliações de evalship

Carregando...

Ferramentas de IA populares como evalship

LangWatch

Apps de IA

LangWatch é uma plataforma de teste de agentes de IA, avaliação de LLM e observabilidade. Permite que desenvolvedores simulem cenários do mundo real, previnam regressões e depurem…

MLOps e implantação de modelos

Nº 14 em Ferramentas de engenharia de prompts

Ver ferramenta

Apps de IA

Plataforma de teste de agentes de IA, avaliação de LLM e observabilidade. Permite que desenvolvedores simulem cenários do mundo real, previnam regressões e depurem…LangWatch é uma plataforma de teste de agentes de IA, avaliação de LLM e observabilidade. Permite que desenvolvedores simulem cenários do mundo real, previnam regressões e depurem…

DestaqueMLOps e implantação de modelos
Nº 14 em Ferramentas de engenharia de prompts

EvalCore

Apps de IA

EvalCore fornece testes de instantâneas para o comportamento da IA, permitindo que você registre como seu aplicativo LLM se comporta e o reproduza em CI a cada alteração. Isso…

Revisão de código e testes com IA
Ver ferramenta

Apps de IA

Fornece testes de instantâneas para o comportamento da IA, permitindo que você registre como seu aplicativo LLM se comporta e o reproduza em CI a cada alteração. Isso…EvalCore fornece testes de instantâneas para o comportamento da IA, permitindo que você registre como seu aplicativo LLM se comporta e o reproduza em CI a cada alteração. Isso…

Revisão de código e testes com IA
Ver o Top 250 de Apps de IA

Confident AI

Apps de IA

Confident AI fornece uma plataforma abrangente de avaliação de LLM que avalia sistemas de IA, compara prompts e modelos, e identifica regressões usando métricas baseadas em…

Plataformas de machine learning

Nº 48 para Monitoramento de modelos de IA

Ver ferramenta

Apps de IA

Fornece uma plataforma abrangente de avaliação de LLM que avalia sistemas de IA, compara prompts e modelos, e identifica regressões usando métricas baseadas em…Confident AI fornece uma plataforma abrangente de avaliação de LLM que avalia sistemas de IA, compara prompts e modelos, e identifica regressões usando métricas baseadas em…

Plataformas de machine learning
Nº 48 para Monitoramento de modelos de IA

Evidently AI fornece ferramentas de código aberto para avaliar e monitorar aplicações de IA. Ajuda a garantir que os sistemas de IA estejam prontos para produção, testando LLMs e…

MLOps e implantação de modelos

Nº 21 em MLOps e implantação de modelos

Ver ferramenta

Fornece ferramentas de código aberto para avaliar e monitorar aplicações de IA. Ajuda a garantir que os sistemas de IA estejam prontos para produção, testando LLMs e…Evidently AI fornece ferramentas de código aberto para avaliar e monitorar aplicações de IA. Ajuda a garantir que os sistemas de IA estejam prontos para produção, testando LLMs e…

MLOps e implantação de modelos
Nº 21 em MLOps e implantação de modelos

mabl

Apps de IA

mabl é uma plataforma de testes de software automatizados que capacita equipes a acelerar lançamentos e garantir a qualidade do software. Utiliza aprendizado de máquina e testes…

Revisão de código e testes com IA

Nº 32 em Revisão de código e testes com IA

Ver ferramenta

Apps de IA

Plataforma de testes de software automatizados que capacita equipes a acelerar lançamentos e garantir a qualidade do software. Utiliza aprendizado de máquina e testes…mabl é uma plataforma de testes de software automatizados que capacita equipes a acelerar lançamentos e garantir a qualidade do software. Utiliza aprendizado de máquina e testes…

Revisão de código e testes com IA
Nº 32 em Revisão de código e testes com IA

Giskard OSS

Repositórios de IA no GitHub

Giskard OSS é uma biblioteca de avaliação e teste de código aberto projetada para agentes LLM. Ela fornece ferramentas para avaliar e melhorar o desempenho de modelos de…

Revisão de código e testes com IA

Nº 109 em Repositórios de IA no GitHub

Ver ferramenta

Repositórios de IA no GitHub

Biblioteca de avaliação e teste de código aberto projetada para agentes LLM. Ela fornece ferramentas para avaliar e melhorar o desempenho de modelos de…Giskard OSS é uma biblioteca de avaliação e teste de código aberto projetada para agentes LLM. Ela fornece ferramentas para avaliar e melhorar o desempenho de modelos de…

Revisão de código e testes com IA
Nº 109 em Repositórios de IA no GitHub

Future AGI

Apps de IA

Future AGI é uma plataforma de código aberto para construir, testar e monitorar agentes de IA. Ela ajuda a capturar e corrigir alucinações de IA em tempo real com guardrails,…

MLOps e implantação de modelos

Nº 38 em MLOps e implantação de modelos

Ver ferramenta

Apps de IA

Plataforma de código aberto para construir, testar e monitorar agentes de IA. Ela ajuda a capturar e corrigir alucinações de IA em tempo real com guardrails,…Future AGI é uma plataforma de código aberto para construir, testar e monitorar agentes de IA. Ela ajuda a capturar e corrigir alucinações de IA em tempo real com guardrails,…

DestaqueMLOps e implantação de modelos
Nº 38 em MLOps e implantação de modelos

DeepEval

Repositórios de IA no GitHub

DeepEval é uma estrutura de código aberto projetada para avaliar grandes modelos de linguagem (LLMs). Permite que desenvolvedores contribuam e melhorem o processo de avaliação,…

MLOps e implantação de modelos

Nº 90 em Repositórios de IA no GitHub

Ver ferramenta

Repositórios de IA no GitHub

Estrutura de código aberto projetada para avaliar grandes modelos de linguagem (LLMs). Permite que desenvolvedores contribuam e melhorem o processo de avaliação,…DeepEval é uma estrutura de código aberto projetada para avaliar grandes modelos de linguagem (LLMs). Permite que desenvolvedores contribuam e melhorem o processo de avaliação,…

MLOps e implantação de modelos
Nº 90 em Repositórios de IA no GitHub
1 de 8