설명
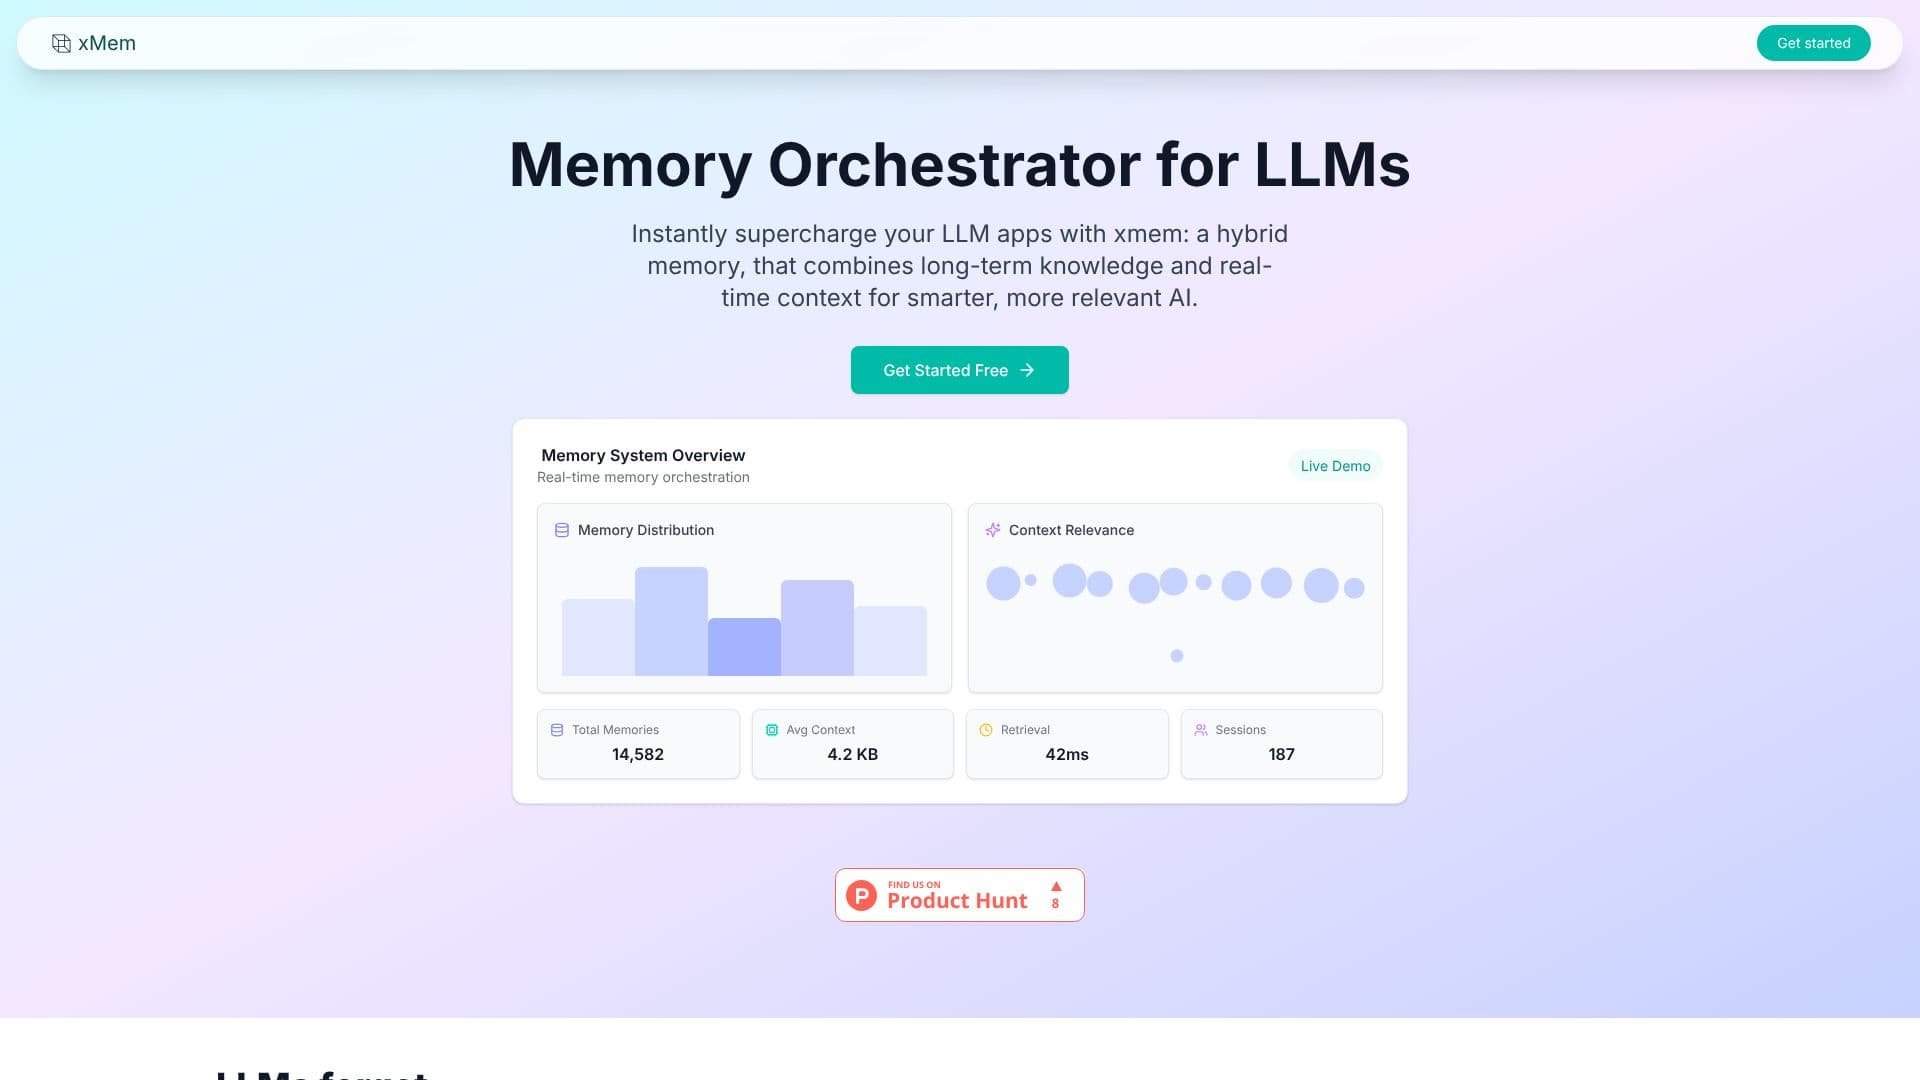
LLM은 종종 메모리 문제로 인해 컨텍스트를 잃고 사용자 경험이 반복되는 경향이 있습니다. xMem은 모든 LLM 상호 작용에 대해 장기 기억과 실시간 세션 컨텍스트를 모두 오케스트레이션하는 하이브리드 메모리 시스템을 제공하여 이러한 문제를 해결합니다. 이를 통해 AI 애플리케이션은 여러 세션에 걸쳐 관련성, 정확성 및 최신 상태를 유지할 수 있습니다.
더 읽기
xMem의 시스템은 LLM 메모리 손실의 일반적인 함정을 방지하도록 설계되었습니다. 벡터 검색을 통해 액세스할 수 있는 장기 기억, 문서 및 메모를 위한 영구 메모리 저장소와 즉각적인 검색을 위한 최근 대화, 지침 및 컨텍스트를 추적하는 세션 메모리 구성 요소를 결합합니다. 이 이중 접근 방식을 통해 LLM은 과거 상호 작용 및 저장된 정보에 대한 포괄적인 이해에 액세스할 수 있습니다.
xMem 기능의 핵심은 RAG(검색 증강 생성) 오케스트레이션에 있습니다. 각 LLM 호출에 대해 가장 관련성 높은 컨텍스트를 자동으로 조립하여 수동 조정의 필요성을 제거합니다. 데이터 흐름은 사용자 프롬프트가 세션 저장소 및 벡터 데이터베이스(Qdrant, ChromaDB, Pinecone 등)를 통해 처리된 후 최적으로 조립된 컨텍스트와 함께 LLM 제공업체(Llama.cpp, Ollama, OpenAI 등)에 전달되는 과정을 포함합니다.
또한 xMem은 개념, 사실 및 사용자 컨텍스트를 실시간으로 연결하는 동적이고 진화하는 지식 그래프를 특징으로 합니다. 이 그래프를 통해 LLM은 인간의 뇌와 유사하게 정보를 추론, 기억 및 연결할 수 있어 더 스마트하고 관련성 높은 답변을 제공합니다. 이 기능은 RAG, 에이전트 및 코파일럿과 같은 애플리케이션에 특히 유용합니다.
xMem은 오픈 소스 철학으로 구축되어 광범위한 오픈 소스 LLM 및 벡터 데이터베이스와의 호환성을 보장합니다. 사용하기 쉬운 API와 모니터링 대시보드를 통해 쉽게 통합할 수 있습니다. 이 시스템은 지능형 메모리 관리, 벡터 데이터베이스 통합을 통한 의미론적 검색 및 검색, 낮은 지연 시간으로 최대 8.2KB의 컨텍스트 크기를 처리하기 위한 실시간 컨텍스트 조립 기능을 제공합니다.
- 카테고리벡터 데이터베이스 및 검색
- 요금제무료 티어
- 배포셀프 호스팅 / 클라우드
- 플랫폼웹
xMem의 핵심 기능
장기 및 세션 컨텍스트를 결합한 하이브리드 메모리 시스템
사용자 지식 및 컨텍스트를 위한 영구 메모리
최근 상호 작용 추적을 위한 세션 메모리
자동 컨텍스트 조립을 위한 RAG 오케스트레이션
개념 연결을 위한 실시간 지식 그래프
지식 검색을 위한 벡터 검색
오픈 소스 LLM 지원(Llama, Mistral 등)
다양한 벡터 데이터베이스와의 통합(Qdrant, ChromaDB, Pinecone)
원활한 통합을 위한 쉬운 API
감독을 위한 모니터링 대시보드
지능형 메모리 관리
의미론적 검색 및 검색 기능
동적이고 진화하는 지식 구조
xMem 사용 방법은?
구성: 벡터 저장소, 세션 저장소 및 LLM 제공업체를 설정합니다.
통합: xMem API를 사용하여 LLM 애플리케이션을 연결합니다.
쿼리: 컨텍스트 관련 응답을 위해 오케스트레이터에 프롬프트를 보냅니다.
모니터링: 대시보드를 사용하여 메모리 사용량 및 성능을 추적합니다.
최적화: AI 정확도 향상을 위해 컨텍스트 조립 및 지식 그래프를 개선합니다.
xMem의 사용 사례
- 컨텍스트 기반 챗봇
- 개인화된 어시스턴트
- RAG 시스템
- AI 에이전트
- 코파일럿
- 지식 관리
- 고객 지원 AI