설명
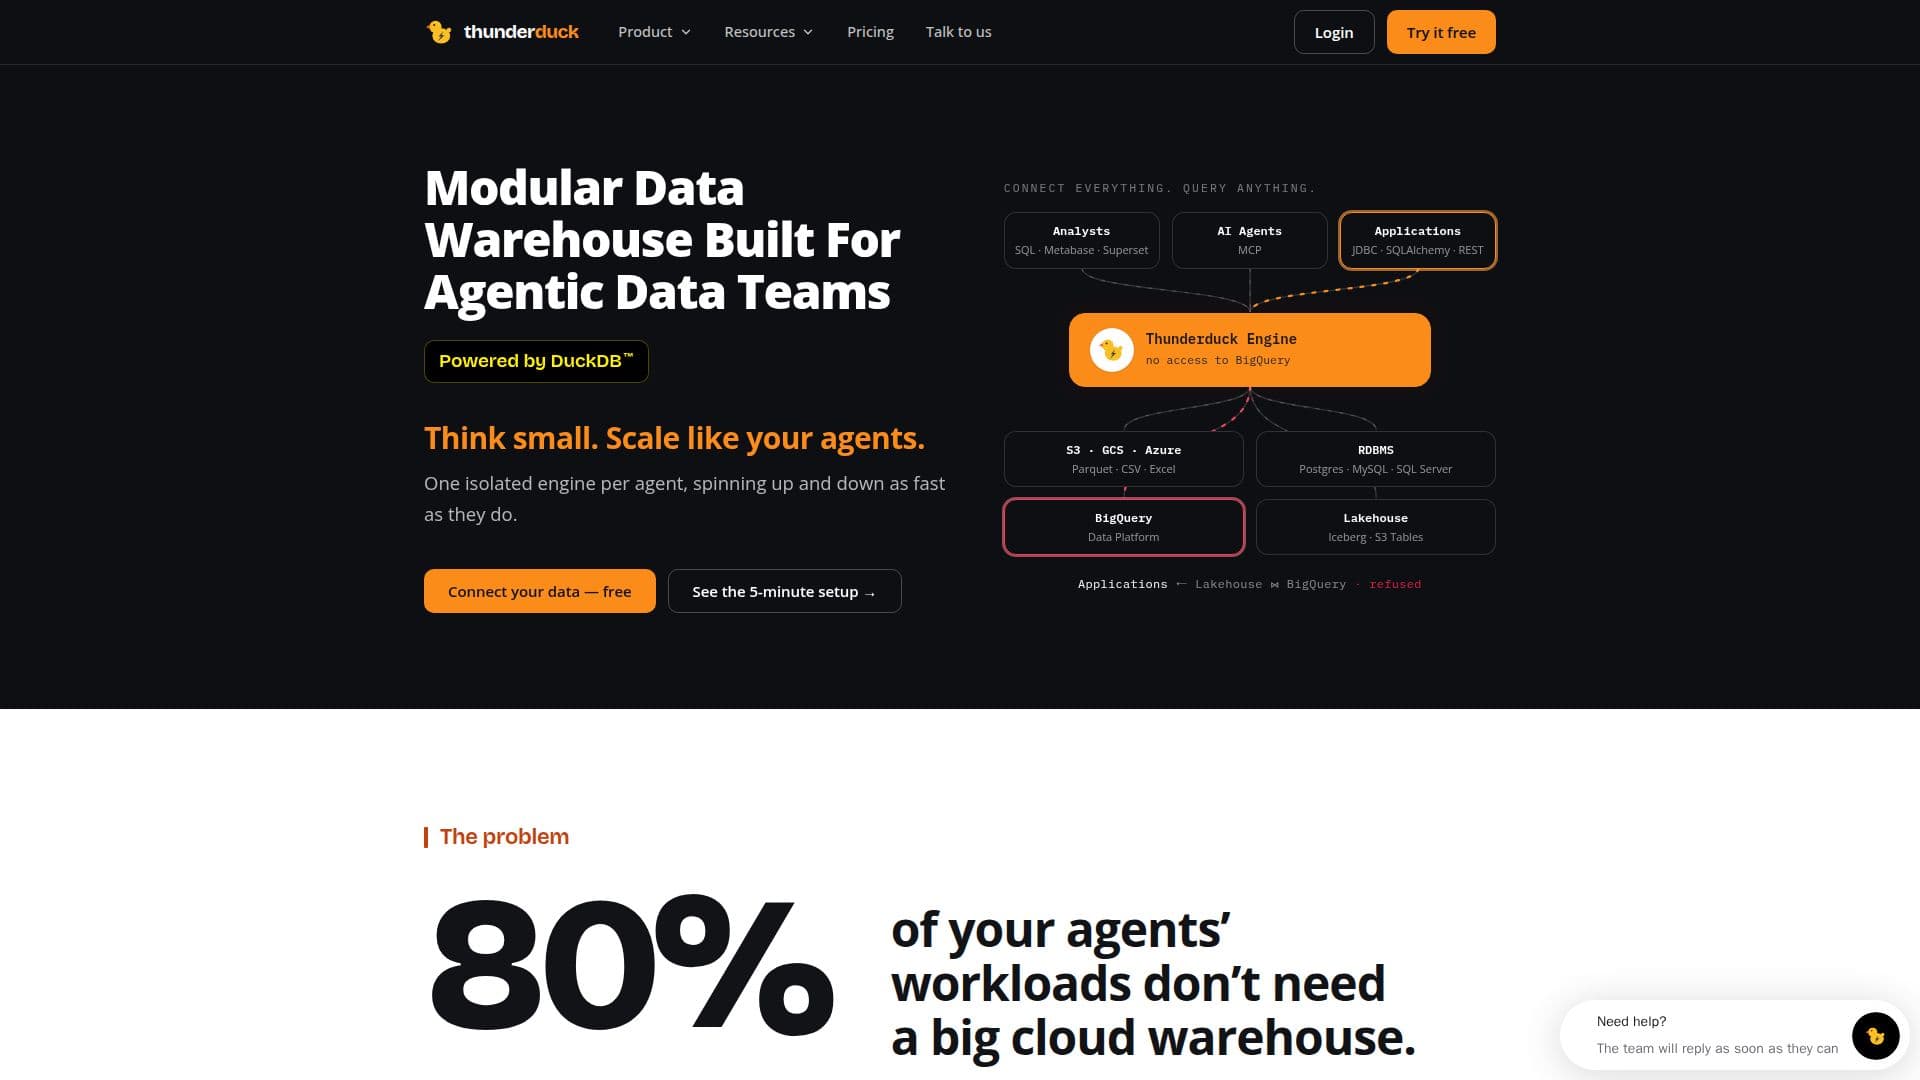
Thunderduck는 DuckDB의 힘을 활용하여 에이전트 데이터 팀을 위해 특별히 설계된 모듈형 데이터 웨어하우스 솔루션을 제공합니다. 이는 80%의 에이전트 작업 부하가 대규모 클라우드 웨어하우스를 필요로 하지 않음에도 불구하고 팀이 상당한 분산 시스템 비용과 관리 서비스 프리미엄을 부담하는 일반적인 문제를 해결합니다.
더 읽기
Thunderduck는 각 에이전트마다 하나의 격리된 엔진을 제공하여 엔진이 신속하게 시작되고 중지될 수 있도록 하여 에이전트 작업 부하의 동적 특성에 맞춥니다. 이 플랫폼은 실행 중인 에이전트 수에 관계없이 테라바이트의 데이터에 대해 서브초 쿼리를 제공하도록 설계되었습니다. 데이터 파이프라인 구축을 간소화하고 DevOps 작업을 자동화하며, 기업 수준의 거버넌스를 유지합니다. 사용자는 Thunderduck를 온프레미스에서 클라우드와 같은 유연성으로 또는 기존 클라우드 인프라 내에서 배포할 수 있는 유연성을 가집니다.
Thunderduck의 핵심은 벡터화된 엔진을 갖춘 오픈 소스 인프로세스 분석 데이터베이스인 DuckDB를 활용하는 것입니다. 이 아키텍처는 코드가 실행되는 곳에서 실행되므로 서버 관리가 필요하지 않습니다. 다중 테넌시를 지원하며, 데이터 주권을 보장하여 사용자의 클라우드 또는 데이터 센터 내에서 데이터가 사용자의 접근 규칙에 따라 유지되도록 합니다.
Thunderduck는 MCP를 통해 Claude, ChatGPT 또는 Cursor와 같은 AI 에이전트와의 원활한 통합을 지원합니다. 에이전트는 테이블과 열의 의미를 이름뿐만 아니라 해석하여 적절한 테이블을 찾고, 파티션과 인덱스를 읽고, 효율적인 쿼리를 작성할 수 있습니다. 이러한 쿼리는 미리 정의된 역할과 비용 한도 내에서 실행됩니다. 이 플랫폼은 또한 메달리온 레이어를 따르는 dbt 모델 빌드를 자동화하고, 브랜치에서 테스트하며, 깔끔하고 관리 가능한 데이터 마트를 유지하기 위해 풀 리퀘스트를 엽니다.
Thunderduck는 제로 ETL로 쿼리 연합을 지원하여 사용자가 Postgres, BigQuery, Iceberg 테이블 및 파일과 같은 다양한 소스의 데이터를 단일 쿼리에서 조인할 수 있도록 하며, 필터는 각 소스에 푸시됩니다. 이는 데이터 복사, 로드 작업 또는 소규모 및 임시 데이터에 대한 동기화 관리의 필요성을 없앱니다. 데이터 세트가 증가하거나 모델링이 필요할 때 사용자는 Iceberg에 dbt 파이프라인을 구축하고 일관되게 쿼리할 수 있습니다. Thunderduck는 또한 쿼리가 실행되기 전에 각 쿼리에 대한 비용 추정을 제공하여 예산 관리를 가능하게 하고 예상치 못한 비용을 방지합니다.
- 카테고리AI SQL 및 데이터베이스 도구
- 요금제프리미엄
- 배포클라우드, 온프레미스
- 플랫폼웹
Thunderduck의 핵심 기능
모듈형 데이터 웨어하우스 아키텍처
각 에이전트마다 하나의 격리된 DuckDB 엔진
테라바이트의 데이터에 대한 서브초 쿼리
온프레미스 또는 클라우드 배포 옵션
자동화된 DevOps 작업
기업 수준의 거버넌스
다중 테넌트 지원
분산 오버헤드 없는 낮은 대기 시간
데이터 주권 및 접근 규칙
MCP를 통한 AI 에이전트(Claude, ChatGPT, Cursor)와의 통합
AI 지원 쿼리 생성 및 dbt 모델 빌드
다양한 소스(PostgreSQL, BigQuery, Iceberg, S3) 간의 쿼리 연합
자동 스키마, 테이블, 열 및 유형 발견
실행 전에 각 쿼리에 대한 비용 및 실행 시간 추정
AI 기반 실패한 쿼리 진단 및 제안된 수정 사항
카탈로그에 대한 역할 기반 접근 제어
즉각적이고 무료로 반복 쿼리를 위한 쿼리 캐싱
Thunderduck 사용 방법은?
카탈로그 연결: 데이터베이스, 웨어하우스, 레이크하우스 또는 객체 저장소와 같은 데이터 소스에 대한 자격 증명을 제공합니다.
데이터 발견: Thunderduck는 자동으로 스키마, 테이블, 열을 읽고 열의 의미를 추론하여 최신 상태로 유지합니다.
쿼리 및 조인: 모든 테이블을 catalog.schema.table로 지정하고 단일 SQL 문에서 여러 소스 간에 조인합니다.
AI 에이전트 통합: Claude, ChatGPT 또는 기타 MCP 클라이언트를 연결하여 AI 에이전트가 카탈로그를 탐색하고 SQL을 실행할 수 있도록 합니다.
워크플로 자동화: SQL 문을 크론 일정에 따라 예약하거나 dbt 리포지토리를 연결하여 빌드, 테스트 및 스냅샷을 실행합니다.
모니터링 및 거버넌스: 사전 쿼리 비용 추정, 감사 로그 및 역할 기반 접근 제어를 활용하여 사용 및 보안을 관리합니다.
Thunderduck의 사용 사례
- 에이전트 데이터 작업 부하
- 데이터 팀을 위한 비용 최적화
- 실시간 데이터 분석
- 데이터 파이프라인 자동화
- 데이터 주권 및 보안
- AI 지원 쿼리
- 소스 간 데이터 조인
- 적극적인 비용 관리
- 데이터 거버넌스 및 감사
- 레이크하우스 구축