설명
MVSEP는 오디오 트랙을 뚜렷한 보컬 및 악기 구성 요소로 분리하는 데 도움을 주기 위해 설계된 혁신적인 도구입니다. 고급 인공지능 알고리즘을 활용하여 MVSEP는 사용자가 모든 오디오 파일에서 보컬을 악기와 분리할 수 있는 기능을 제공합니다. 이 기능은 리믹스, 마스터링 또는 교육 목적으로 오디오 요소에 대한 정밀한 제어가 필요한 음악가, 오디오 엔지니어 및 프로듀서에게 특히 유용합니다.
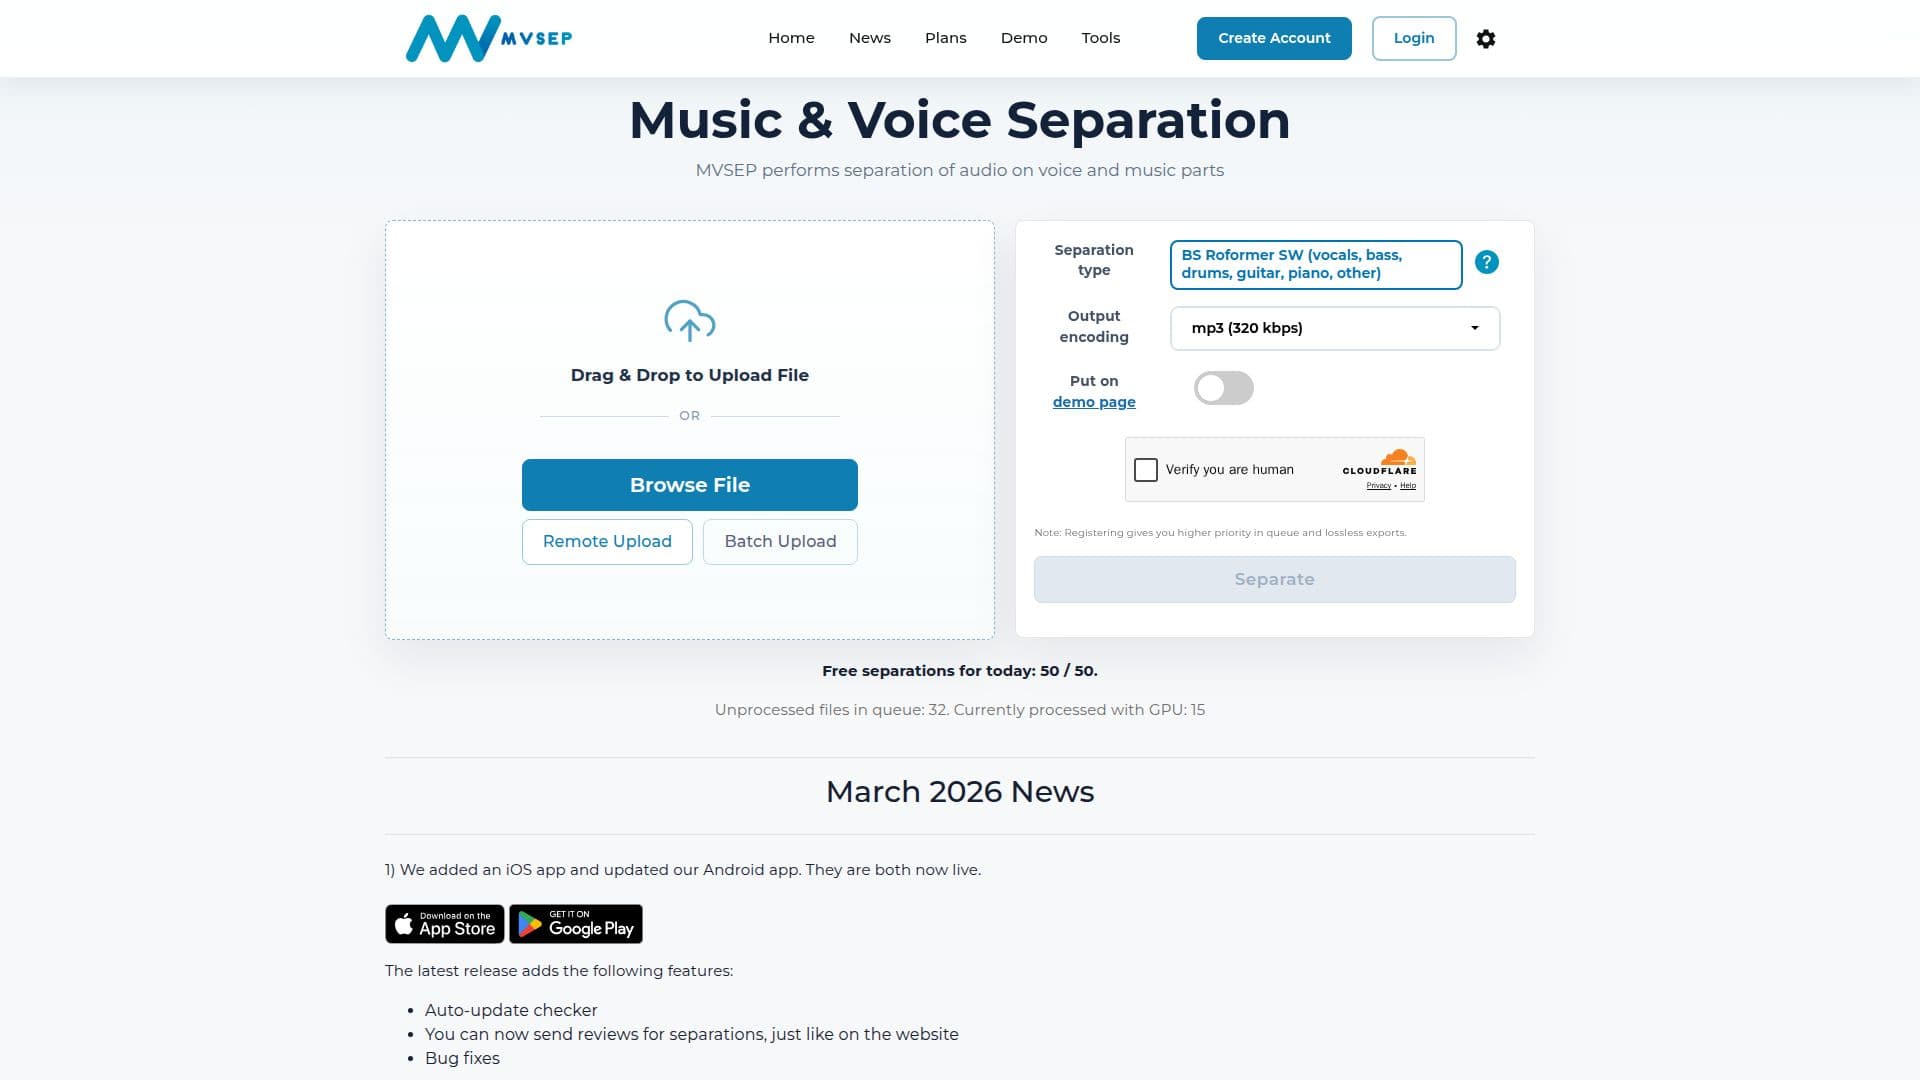
이 도구는 온라인에서 접근 가능하며 오디오 분리 프로세스를 간소화하는 사용자 친화적인 인터페이스를 제공합니다. 사용자는 오디오 파일을 업로드하고 몇 분 내에 분리된 트랙을 받을 수 있습니다. MVSEP의 AI 기술은 보컬 및 악기 트랙의 무결성을 유지하면서 고품질의 분리를 보장합니다.
오디오 분리 외에도 MVSEP는 오디오에서 텍스트 추출 기능도 제공하여 사용자가 음성 콘텐츠를 텍스트로 변환할 수 있도록 합니다. 이 기능은 인터뷰, 팟캐스트 또는 텍스트 문서화가 필요한 모든 오디오 콘텐츠의 전사에 유용합니다.
MVSEP는 무료로 제공되어 개인과 전문가 모두에게 접근 가능한 옵션입니다. 이 플랫폼은 또한 개발자가 MVSEP의 기능을 자신의 애플리케이션이나 워크플로우에 통합할 수 있도록 포괄적인 API 문서를 제공합니다.
전반적으로 MVSEP는 오디오 처리 산업에서 다재다능한 도구로 두드러지며, 오디오 분리 및 텍스트 추출을 위한 신뢰할 수 있고 효율적인 솔루션을 제공합니다. 무료로 제공되고 사용이 간편하여 오디오 콘텐츠 작업을 하는 모든 사람에게 귀중한 자원입니다.
MVSEP의 핵심 기능
보컬과 악기 부분으로 오디오 분리
오디오에서 텍스트 추출
무료 사용
AI 기반 알고리즘
고품질 분리
사용자 친화적인 인터페이스
완전한 API 문서
온라인 접근성
MVSEP 사용 방법은?
업로드: 오디오 파일을 선택하고 업로드합니다.
처리: AI가 오디오를 분리하도록 허용합니다.
다운로드: 분리된 트랙을 가져옵니다.
통합: 사용자 정의 애플리케이션을 위해 API를 사용합니다.
MVSEP의 사용 사례
- 음악 제작
- 팟캐스트 전사
- 오디오 엔지니어링
- 교육 목적
- 콘텐츠 제작