설명
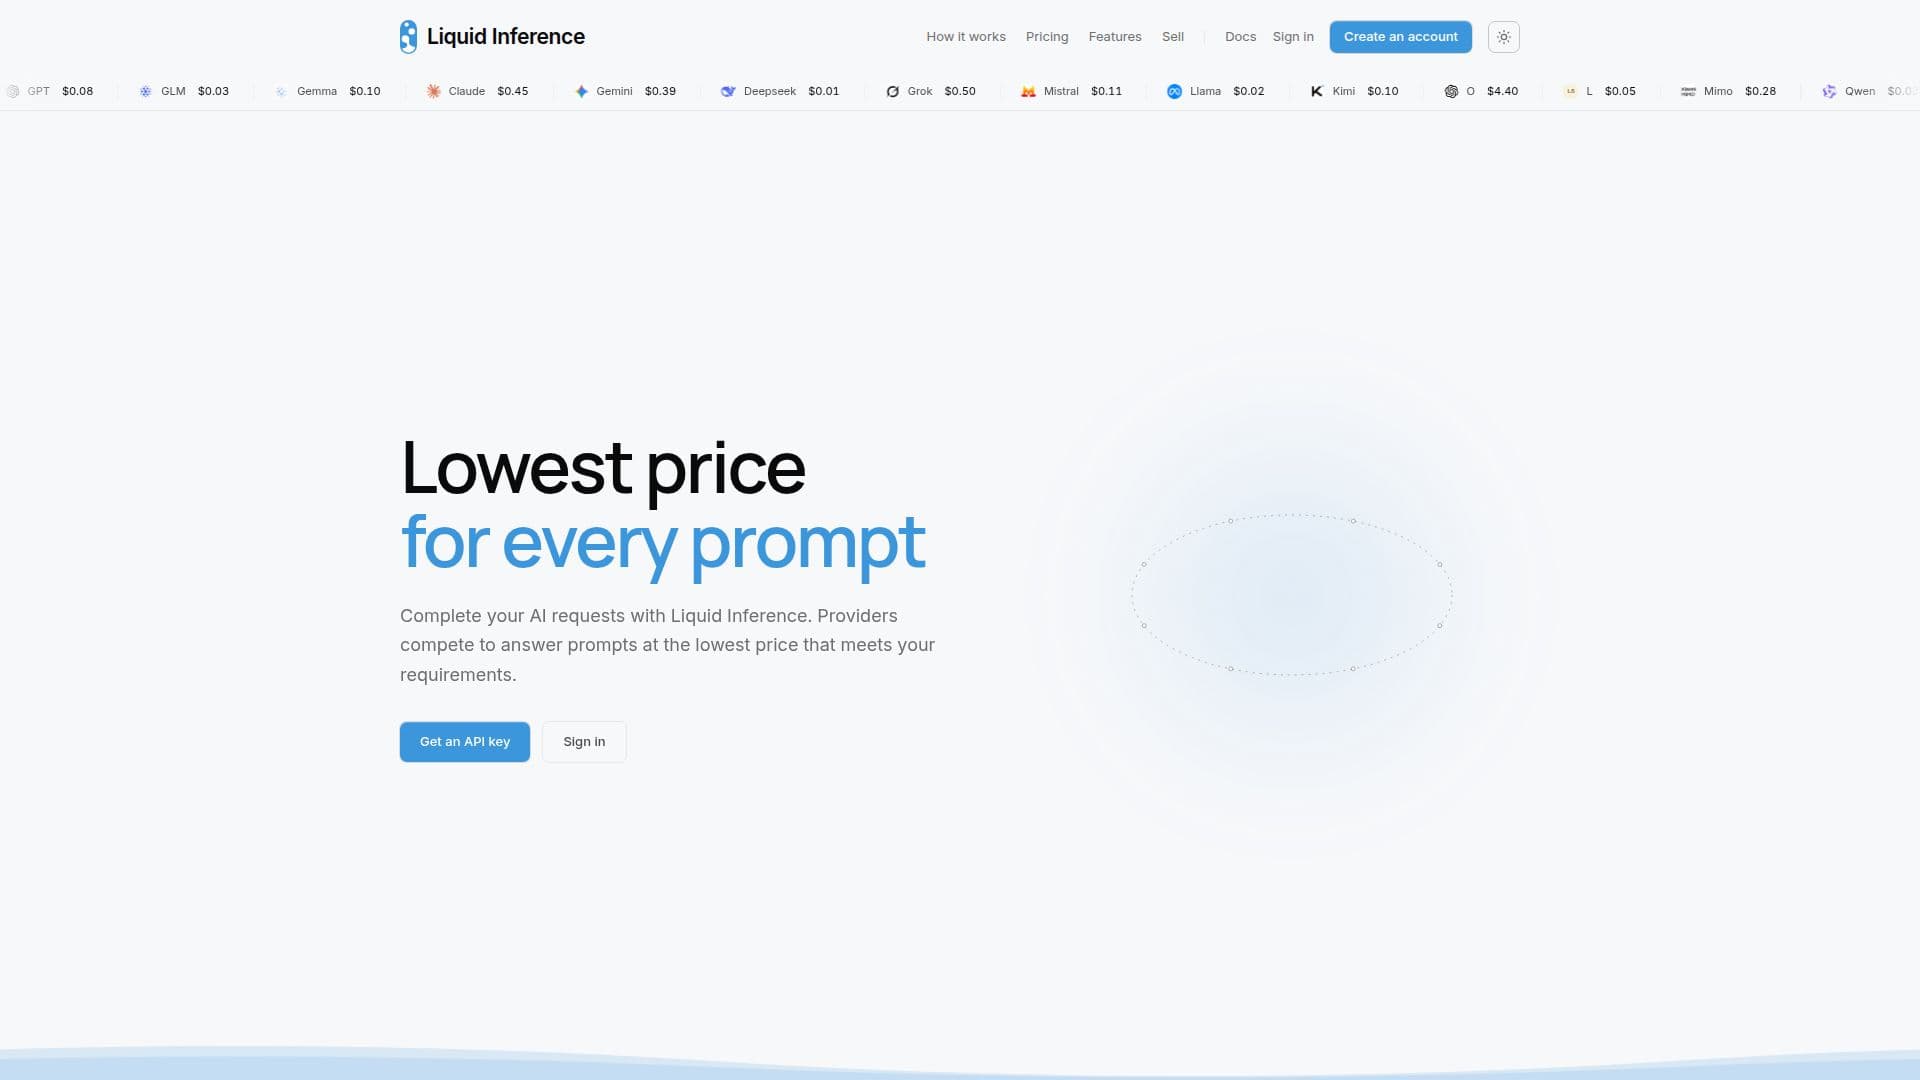
Liquid Inference는 공급자가 각 프롬프트에 대해 가격 경쟁을 통해 AI 요청의 비용을 최적화하도록 설계된 플랫폼입니다. 사용자는 모델, 지역, 속도 및 최소 품질에 대한 특정 규칙을 설정할 수 있으며, 플랫폼은 이러한 기준을 충족하는 가장 저렴한 공급자가 요청에 응답하도록 보장합니다. 이 접근 방식은 사용자가 요청이 시작되기 전에 최대 비용을 알 수 있게 하며, 생성된 토큰에 대해서만 청구됩니다.
더 읽기
이 플랫폼은 공급자가 각 모델에 대해 토큰당 가격을 설정하고 수요와 공급에 따라 조정할 수 있는 즉각적인 경매 시스템을 특징으로 합니다. 이 동적 가격 모델은 사용자가 항상 가장 비용 효율적인 솔루션을 받을 수 있도록 보장합니다. Liquid Inference는 정기적으로 공급자를 표준 벤치마크로 테스트하고 결과를 공개하여 투명성과 신뢰를 보장합니다.
Liquid Inference는 OpenAI 및 Anthropic API와 같은 주요 모델을 지원하여 사용자가 기존 AI 코딩 도구와 원활하게 통합할 수 있도록 합니다. 공급자는 자신의 배포를 등록하고, 가격을 설정하며, 용량에 따라 가격을 조정하여 부하를 관리할 수 있습니다. 이 플랫폼은 공급자가 아닌 고객에게 수수료를 부과하여 이미 운영 중인 모델에 대한 추론을 판매하려는 공급자에게 매력적인 옵션이 됩니다.
항목별 청구 및 공개 가격 이력과 같은 기능을 통해 사용자는 모든 모델에 대한 실시간 및 과거 가격을 다운로드할 수 있어 가격이 낮을 때 작업을 보낼 수 있습니다. Liquid Inference는 품질을 저하시키지 않으면서 AI 비용을 최적화하려는 기업과 개발자에게 이상적입니다.
- 카테고리머신러닝 플랫폼
- 요금제동적
- 배포클라우드
- 플랫폼웹
Liquid Inference의 핵심 기능
AI 요청을 위한 경쟁력 있는 가격
동적 경매 시스템
공급자 벤치마킹
OpenAI 및 Anthropic API와의 통합
항목별 청구
공개 가격 이력
주요 AI 모델 지원
공급자 제어 가격 책정
Liquid Inference 사용 방법은?
계정 생성: 플랫폼에 가입하세요
배포 등록: 제공할 모델을 제출하세요
운영자 검토: 배포를 목록에 올리세요
가격 제시 시작: 에이전트를 연결하고 가격을 제안하세요
Liquid Inference의 사용 사례
- 비용 최적화
- 동적 가격 책정
- 품질 보증
- 원활한 통합
- 공급자 관리