설명
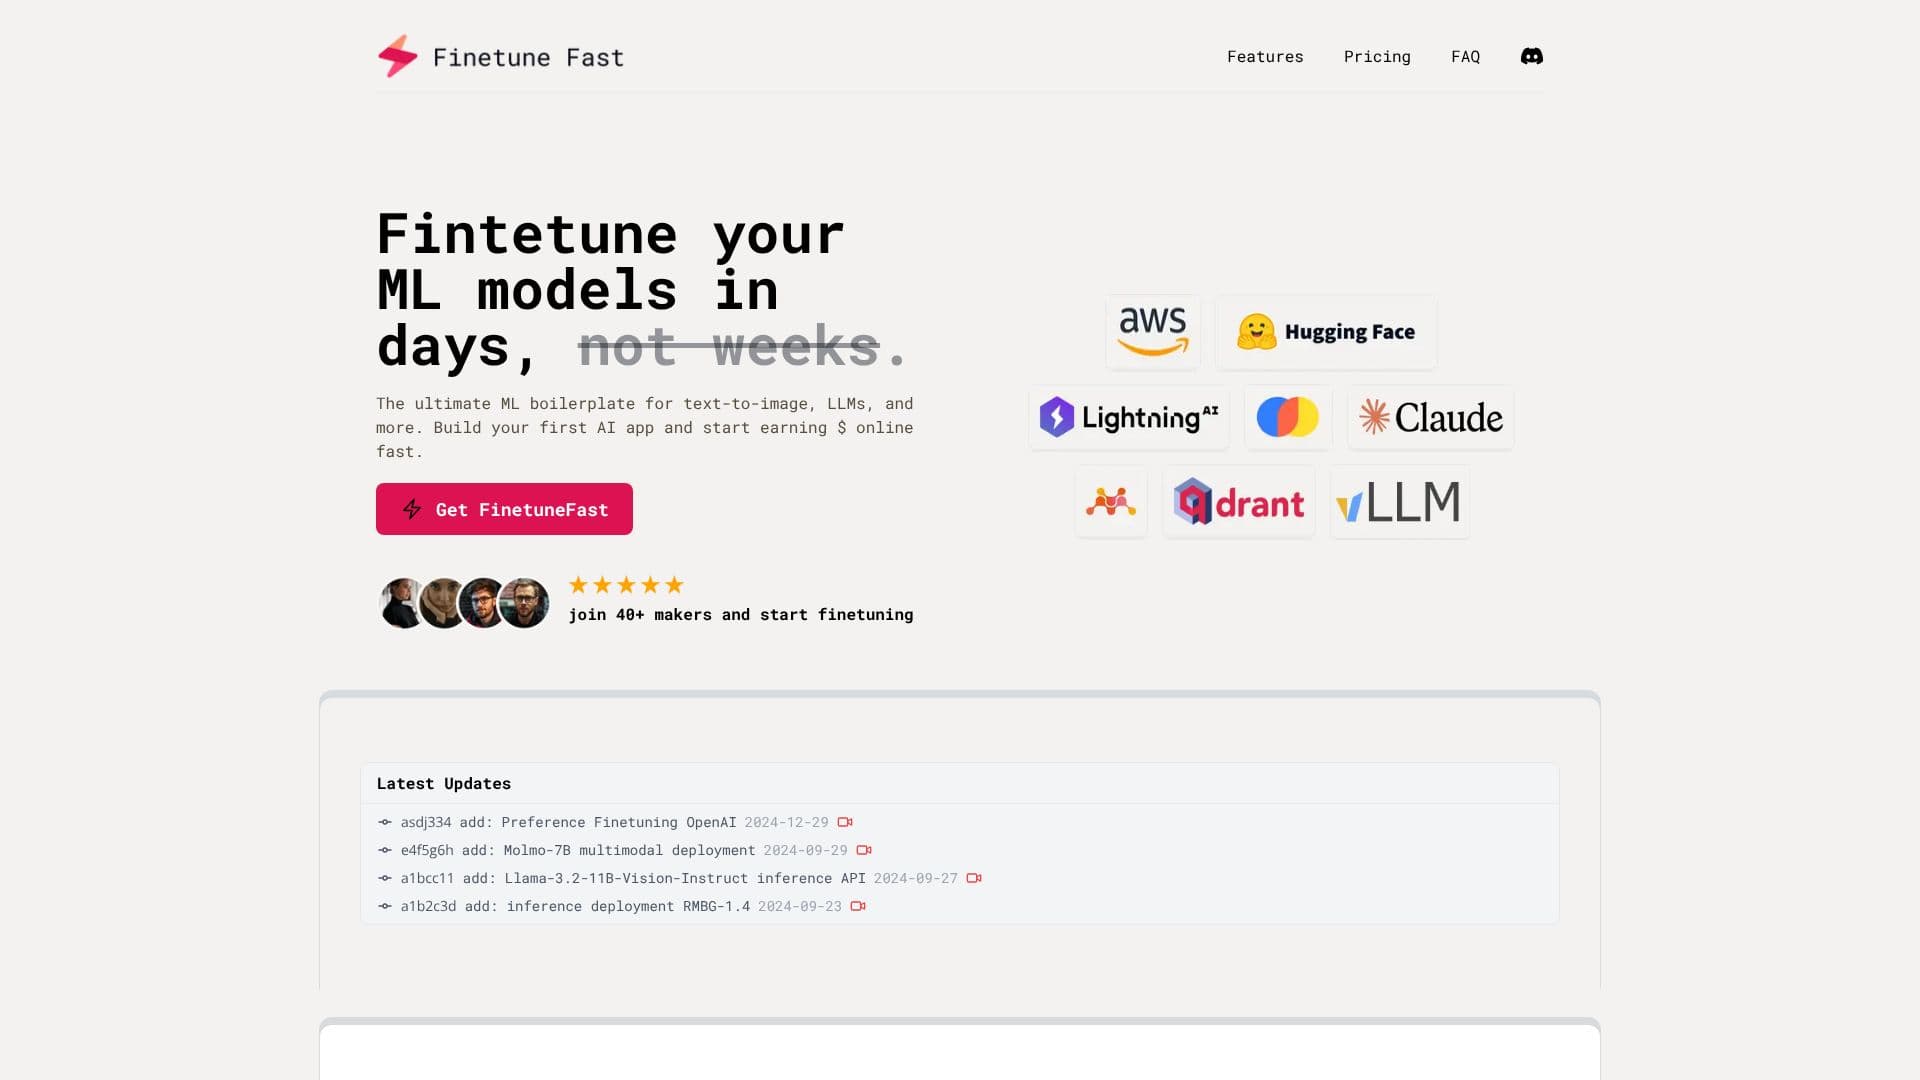
FinetuneFast는 AI 모델 출시 프로세스를 간소화하도록 설계되어 개발자와 메이커가 몇 주가 아닌 며칠 만에 머신러닝 모델을 파인튜닝할 수 있도록 지원합니다. 이 플랫폼은 환경 구성, 종속성 설치, 학습 데이터 준비, API 통합, 모델 평가 및 프로덕션 배포와 같이 ML 개발에서 흔히 발생하는 시간 소모적인 부분을 해결합니다.
더 읽기
이 플랫폼은 모델 학습을 가속화하도록 설계된 사전 구성된 학습 스크립트, 효율적인 데이터 로딩 파이프라인, 하이퍼파라미터 최적화 도구 및 멀티 GPU 지원을 제공합니다. 배포 및 확장을 위해 FinetuneFast는 원클릭 모델 배포, 자동 확장 인프라, API 엔드포인트 생성, 모니터링/로깅 설정을 제공합니다. 이러한 포괄적인 접근 방식은 사용자에게 모델 학습에 10시간 이상, 배포 및 확장에 10시간 이상을 절약하는 것을 목표로 합니다.
파인튜닝, 최적화 및 프로덕션 배포에 대한 광범위한 경험을 가진 ML 엔지니어가 만든 FinetuneFast는 개인과 기업이 인프라가 아닌 혁신에 집중할 수 있도록 돕는 것을 목표로 합니다. 이 도구는 텍스트-이미지 모델, LLM 및 RAG 애플리케이션을 포함한 다양한 AI 애플리케이션에 적합하며 FLUX.1-schnell, Mistral7B, GPT4o-mini 및 Pixtral과 같은 모델을 지원합니다.
FinetuneFast는 개인 및 소규모 팀을 위한 Starter와 비즈니스 및 고급 사용자를 위한 All In의 두 가지 가격 등급을 제공합니다. 두 플랜 모두 파인튜닝 및 추론 보일러플레이트, RAG 예제, AI-SaaS 제품을 빠르게 출시하기 위한 템플릿에 액세스할 수 있습니다. All In 플랜에는 Discord 커뮤니티 액세스, 평생 업데이트 및 고품질 파인튜닝을 위한 모범 사례도 포함됩니다.
가치 제안은 속도와 효율성에 중점을 두어 사용자가 AI 솔루션을 더 빠르고 안정적으로 구축하고 배포할 수 있도록 합니다. 명확한 문서와 커뮤니티 지원의 이점을 누릴 수 있는 ML 초보자부터 워크플로우를 최적화하려는 숙련된 ML 엔지니어에 이르기까지 다양한 사용자를 대상으로 합니다. 이 플랫폼은 무제한 프로젝트에 대한 일회성 결제 모델을 강조하여 신속한 AI 개발을 위한 비용 효율적인 솔루션을 제공합니다.
- 카테고리머신러닝 플랫폼
- 요금제일회성 결제
- 배포원클릭
- 플랫폼웹
FinetuneFast의 핵심 기능
더 빠른 모델 학습을 위한 사전 구성된 학습 스크립트
간소화된 데이터 처리를 위한 효율적인 데이터 로딩 파이프라인
향상된 모델 성능을 위한 하이퍼파라미터 최적화 도구
강력한 하드웨어에서 학습을 가속화하기 위한 멀티 GPU 지원
코드 없는 AI 모델 파인튜닝 기능
간편한 프로덕션 준비를 위한 원클릭 모델 배포
증가된 부하를 처리하기 위한 자동 확장 인프라
쉬운 통합을 위한 API 엔드포인트 생성
프로덕션 환경을 위한 모니터링 및 로깅 설정
RAG(검색 증강 생성) 예제 및 템플릿
프로덕션 준비된 추론 보일러플레이트
고품질 파인튜닝 모델을 위한 모범 사례
'All In' 플랜에 대한 평생 업데이트
지원 및 네트워킹을 위한 Discord 커뮤니티 액세스
FinetuneFast 사용 방법은?
구성: 파인튜닝 보일러플레이트 및 RAG 예제를 선택하고 조정합니다.
데이터 준비: 효율적인 데이터 로딩 파이프라인 및 모범 사례를 활용합니다.
모델 학습: 사전 구성된 스크립트, 하이퍼파라미터 최적화 및 멀티 GPU 지원을 활용합니다.
모델 평가: 제공된 평가 절차 및 메트릭을 구현합니다.
모델 배포: 원클릭 배포 및 자동 확장 인프라를 사용합니다.
통합: 생성된 엔드포인트를 사용하여 API와 연결합니다.
모니터링: 내장된 모니터링 및 로깅을 활용합니다.
FinetuneFast의 사용 사례
- 가속화된 모델 학습
- 빠른 AI 모델 배포
- AI SaaS 제품 구축
- LLM 파인튜닝
- 텍스트-이미지 생성
- RAG 애플리케이션 개발
- ML 워크플로우 최적화