설명
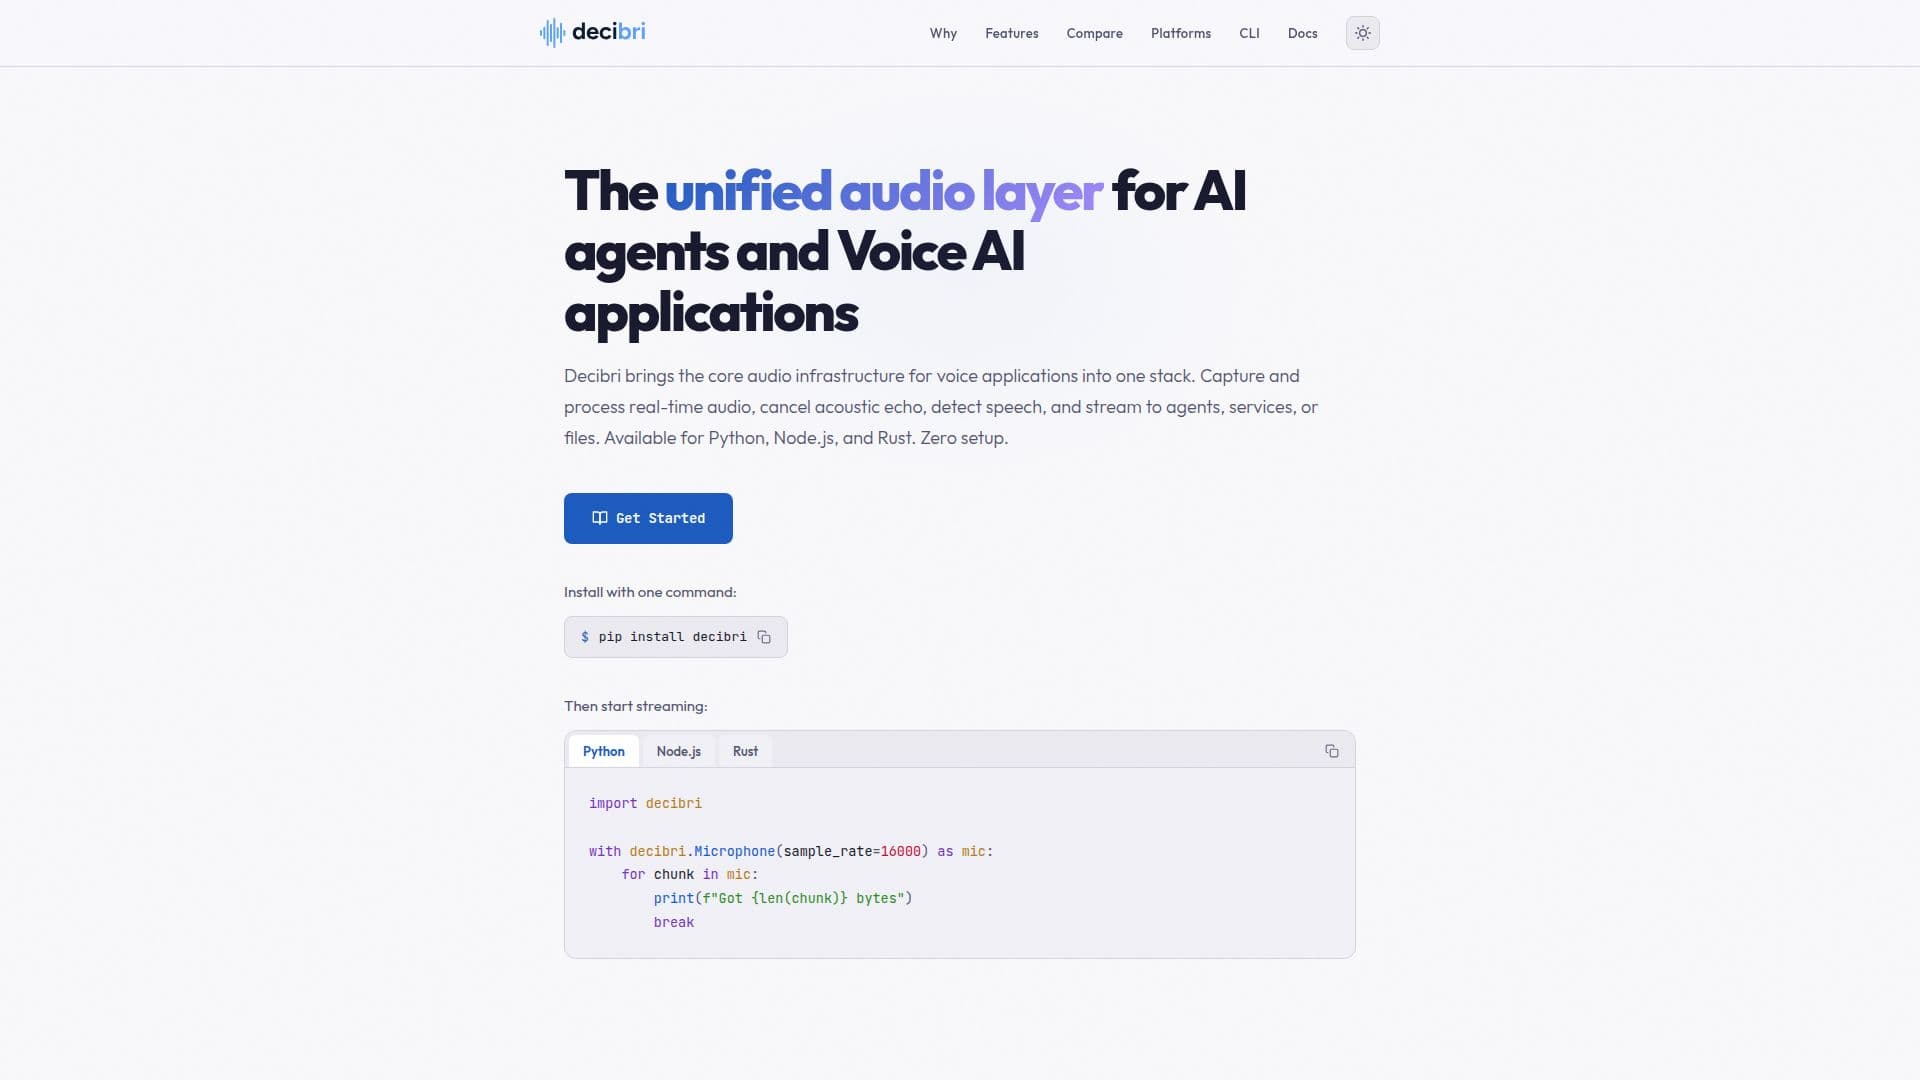
Decibri는 AI 에이전트 및 음성 AI 애플리케이션을 위해 특별히 설계된 통합 오디오 레이어로, 마이크 캡처, 스피커 출력 및 음성 활동 감지(VAD)를 포함한 필수 실시간 오디오 기능을 제공합니다. 이 플랫폼은 Python, Node.js 및 Rust와 같은 여러 프로그래밍 언어를 지원하여 다양한 개발 환경에서의 활용성을 높입니다.
더 읽기
Decibri의 주요 장점 중 하나는 설치의 용이성과 크로스 플랫폼 호환성입니다. 모든 지원 플랫폼(Windows, macOS, Linux)에서 Python 및 Node.js용 미리 빌드된 바이너리를 제공하여 컴파일이나 복잡한 빌드 도구가 필요하지 않습니다. 이 "제로 설정" 접근 방식은 개발자가 실시간 오디오 기능을 프로젝트에 신속하게 통합할 수 있도록 보장합니다. Python, Node.js 및 Rust 패키지를 지원하는 Rust 코어는 네이티브 코드로 컴파일되어 운영 체제의 오디오 레이어에서 직접 예측 가능한 저지연 오디오를 보장합니다.
Decibri는 OS 오디오 레이어에서 직접 오디오를 캡처하여 기본적으로 16비트 부호 있는 정수 PCM 형식으로 100ms 오디오 청크를 제공합니다. 이는 Vosk, sherpa-onnx 및 whisper.cpp와 같은 대부분의 음성 및 웨이크 워드 엔진에서 기대하는 표준 형식입니다. 32비트 부동 소수점 형식도 제공됩니다. 각 언어에 대한 스트림 네이티브 관용구를 지원하여 개발자가 오디오를 파일, WebSocket 또는 음성 에이전트로 효율적으로 파이프할 수 있도록 합니다. 이 플랫폼은 또한 시끄러운 환경에서 정확한 음성 감지를 위한 Silero VAD v6.2 모델을 포함하여 ONNX Runtime을 통해 로컬에서 실행되며 클라우드 API가 필요하지 않습니다.
기본 캡처 및 재생을 넘어, Decibri는 DC 제거, 노이즈 제거, 고역 필터링, 자동 이득 제어 및 리미팅을 포함한 고급 오디오 처리 기능을 Audio Capture Engine(ACE)를 통해 제공합니다. 또한 마이크 캡처에서 스피커 소리를 제거하기 위한 Acoustic Echo Cancellation(AEC) 기능도 제공합니다. 오프라인 처리를 위해 Audio File Processor(AFP)는 기록된 샘플이나 메모리 내 샘플을 조정할 수 있습니다. Decibri는 클라우드 기반(AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) 및 로컬(Sherpa-ONNX, Whisper.cpp) 음성 인식(STT) 제공업체와 통합되며, Kokoro 모델을 사용한 로컬 텍스트 음성 변환(TTS) 및 Sherpa-ONNX를 통한 키워드 스포팅(KWS)도 지원합니다.
Decibri는 실시간 시스템을 위해 구축되어 외부 오디오 도구나 플랫폼 특정 처리가 필요 없는 저지연 오디오 I/O를 보장합니다. Python에서는 `asyncio`를 사용하여 비동기 작업을 지원하며, Node.js 및 브라우저 환경에서도 단일 패키지로 작동합니다. `decibri-cli` 도구는 오디오 캡처, 재생 및 장치 열거를 위한 명령줄 기능을 제공하여 스크립팅 및 CI/CD 파이프라인에서의 유용성을 더욱 확장합니다.
- 카테고리AI 에이전트 빌더
- 요금제무료
- 배포로컬
- 플랫폼Windows, macOS, Linux, Browser
Decibri의 핵심 기능
실시간 마이크 캡처
스피커 출력 및 재생
음성 활동 감지(VAD)
크로스 플랫폼 지원(Python, Node.js, Rust)
제로 설정을 위한 미리 빌드된 바이너리
직접 OS 오디오 레이어 접근
16비트 PCM 및 32비트 부동 소수점 오디오 출력
비동기 API 지원(asyncio for Python)
브라우저 호환성(Node.js 패키지)
오디오 캡처 엔진(DC 제거, 노이즈 제거, AGC)
음향 에코 취소(AEC)
로컬 ML 음성 감지(Silero VAD)
클라우드 STT 서비스와의 통합
로컬 STT/TTS/KWS 모델과의 통합
명령줄 인터페이스(decibri-cli)
Decibri 사용 방법은?
Decibri 설치: Python의 경우 `pip install decibri` 또는 Node.js의 경우 `npm install decibri`를 사용하여 미리 빌드된 바이너리를 가져옵니다.
마이크 열기: Python에서는 `decibri.Microphone.open()`을 사용하거나 Node.js에서는 `new Microphone()`을 사용하여 오디오 캡처를 시작합니다.
오디오 스트리밍: Python 반복자, Node.js Readable 스트림 또는 Rust 채널을 사용하여 오디오 청크를 읽습니다.
오디오 처리: DC 제거, 노이즈 제거 또는 음향 에코 취소와 같은 내장 조정을 적용합니다.
음성 감지: 로컬 음성 활동 감지를 위해 번들된 Silero VAD 모델을 활성화합니다.
AI 서비스와 통합: 원시 PCM 오디오를 음성 인식 서비스, 음성 에이전트 또는 기타 AI 모델로 파이프합니다.
오디오 재생: Decibri의 스피커 API를 사용하여 시스템 스피커를 통해 오디오를 재생합니다.
파일에 녹음: 간단한 오디오 녹음을 위해 `record_to_file()`을 사용하거나 고급 사용 사례를 위한 전체 스트리밍 제어를 사용합니다.
Decibri의 사용 사례
- 실시간 음성 AI 에이전트
- 음성 인식 통합
- 음성 활동 감지
- ASR을 위한 오디오 녹음
- 크로스 플랫폼 오디오 애플리케이션
- 서버 측 음성 백엔드
- 키워드 스포팅
- 풀 듀플렉스 오디오 통신