설명
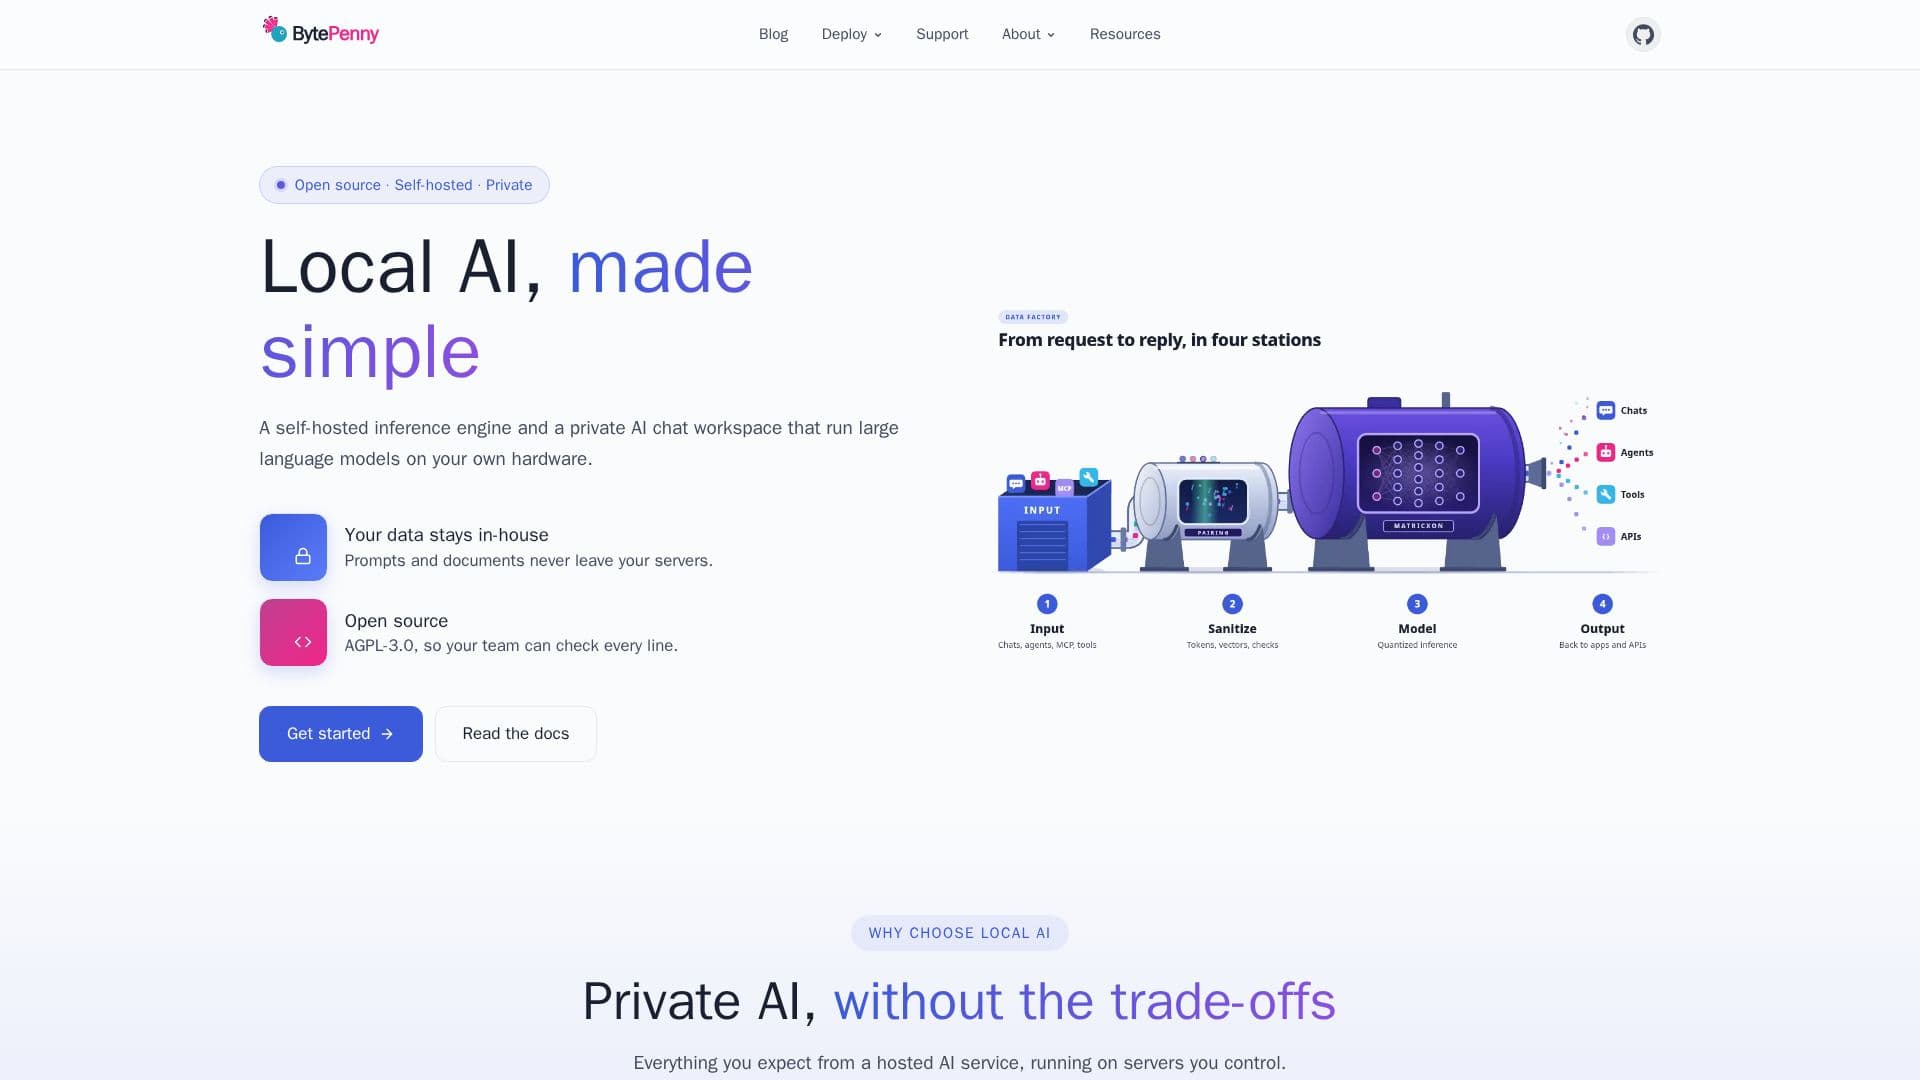
BytePenny는 프라이버시와 제어를 위해 설계된 오픈 소스, 자체 호스팅된 AI 도구의 종합적인 제품군을 제공합니다. 핵심 제품은 오픈 소스 GGUF 추론 엔진인 Matricxon과 팀을 위해 맞춤화된 개인 AI 채팅 작업 공간인 pAIring을 포함합니다. 이러한 제품은 조직이 대형 언어 모델을 직접 자신의 하드웨어에서 실행할 수 있도록 하여 프롬프트, 문서 및 채팅 데이터가 서버를 떠나지 않도록 보장합니다.
더 읽기
이 플랫폼은 데이터 프라이버시를 강조하며 모든 민감한 정보를 내부에 유지하기 위해 완전히 오프라인으로 작동합니다. Hugging Face, llama.cpp 또는 Matricxon 엔진과 같은 다양한 GGUF 모델을 지원하며 MCP 도구 서버와 통합할 수 있습니다. BytePenny는 AGPL-3.0 라이센스를 사용하여 오픈 소스 철학으로 구축되어 팀이 모든 코드 라인을 검사하고 수정할 수 있도록 하여 투명성과 신뢰를 증진합니다.
추론 엔진인 Matricxon은 Python과 PyTorch로 작성된 경량의 가독성 높은 LLM 런타임으로, 성능을 가속화하기 위한 네이티브 C 커널을 특징으로 합니다. 채팅, 텍스트 생성, 임베딩, 재순위 지정, 비전-언어 모델 및 시계열 예측과 같은 작업을 위한 GGUF 모델을 지원하며, HTTP API를 통해 이를 제공합니다. CPU에서 효율적으로 실행되며 NVIDIA GPU에 대한 BETA 지원을 제공하며, AMD 및 Apple Silicon GPU로의 확장을 계획하고 있습니다. Matricxon은 또한 pAIring UI에서 관리되는 여러 노드 간의 공유 모델 및 채팅 캐시를 위한 클러스터 모드를 지원합니다.
개인 AI 채팅 작업 공간인 pAIring은 팀 협업을 위해 설계되었으며 역할 기반 접근, 공유 채널 및 통합 지식 기반과 같은 기능을 제공합니다. 암호화된 채팅 캐시를 제공하며 프롬프트가 모델 훈련에 사용되지 않도록 보장합니다. 이 시스템은 확장 가능하여 사용자가 단일 서버로 시작하고 부하 분산 및 장애 조치 기능을 통해 노드를 추가하여 확장할 수 있습니다. 더 많은 성능이 필요한 시나리오를 위해 pAIring은 Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq 등과 같은 다양한 클라우드 공급자에 연결할 수 있어 로컬 및 클라우드 엔진을 혼합할 수 있는 유연성을 제공합니다.
BytePenny는 토큰당 청구를 없애고 조직이 기존 하드웨어를 활용하고 사용량이 증가함에 따라 고정 비용을 유지할 수 있도록 합니다. 전체 스택은 AGPL-3.0 코드에서 오픈 가중치 모델에 이르기까지 개방적으로 설계되어 개인 및 폐쇄 네트워크에 이상적입니다. 보안은 가장 중요한 문제로, bcrypt 해시 비밀번호, 암호화된 저장 비밀, AES-256-GCM으로 암호화된 채팅 캐시 및 관리 작업을 위한 서버 측 역할 검사와 같은 기능이 포함되어 있습니다. Matricxon과 pAIring 모두 OpenSSF 모범 사례 '통과' 배지를 획득하여 안전한 개발 관행에 대한 헌신을 보여줍니다.
- 카테고리MLOps 및 모델 배포
- 요금제Open Source (AGPL-3.0), No Per-Token Bills
- 배포Self-Hosted, On-Premise, Cloud (Hybrid)
- 플랫폼Windows, Linux
BytePenny의 핵심 기능
자체 호스팅된 AI 추론 엔진 (Matricxon)
팀을 위한 개인 AI 채팅 작업 공간 (pAIring)
자신의 하드웨어에서 대형 언어 모델 실행
데이터는 내부에 유지; 프롬프트와 문서는 서버를 떠나지 않음
AGPL-3.0 라이센스의 오픈 소스
완전 오프라인으로 작동
AES-256-GCM으로 암호화된 채팅 캐시
팀을 위한 역할 기반 접근
프롬프트는 모델 훈련에 사용되지 않음
Hugging Face, llama.cpp, Matricxon의 GGUF 모델 지원
CPU 및 NVIDIA GPU 지원을 위한 양자화된 커널
토큰당 청구 없음; 사용량 증가에 따른 고정 비용
확장 가능한 배포: 단일 노드, 공유 클러스터 또는 별도 서버
12개 이상의 클라우드 공급자와 연결 (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq 등)
가독성과 사용자 정의 가능성을 위해 Python으로 처음부터 작성됨
BytePenny 사용 방법은?
BytePenny 배포: 자신의 서버 또는 클라우드 인프라에 Matricxon과 pAIring을 설치합니다.
추론 엔진 구성: Matricxon을 로컬 추론 엔진으로 설정하거나 pAIring을 선호하는 클라우드 공급자에 연결합니다.
모델 추가: Hugging Face 또는 기타 출처에서 GGUF 모델을 통합하거나 커넥터를 통해 클라우드 호스팅 모델을 활용합니다.
사용자 및 팀 관리: 역할 기반 접근을 구성하고, 공유 채널을 만들고, pAIring 내에서 지식 기반을 설정합니다.
채팅 시작: 개인 AI 대화를 시작하고 팀 협업을 위해 지식 기반을 활용합니다.
모니터링 및 확장: 시스템 상태를 관찰하고 클러스터 노드를 관리하며 사용량 증가에 따라 하드웨어를 확장하되 토큰당 비용이 발생하지 않도록 합니다.
BytePenny의 사용 사례
- 개인 팀 채팅
- 로컬 LLM 추론
- 안전한 문서 분석
- 비용 통제된 AI 운영
- 오프라인 AI 워크플로우
- 맞춤형 모델 배포
- 확장 가능한 AI 인프라
- 오픈 소스 AI 개발