설명
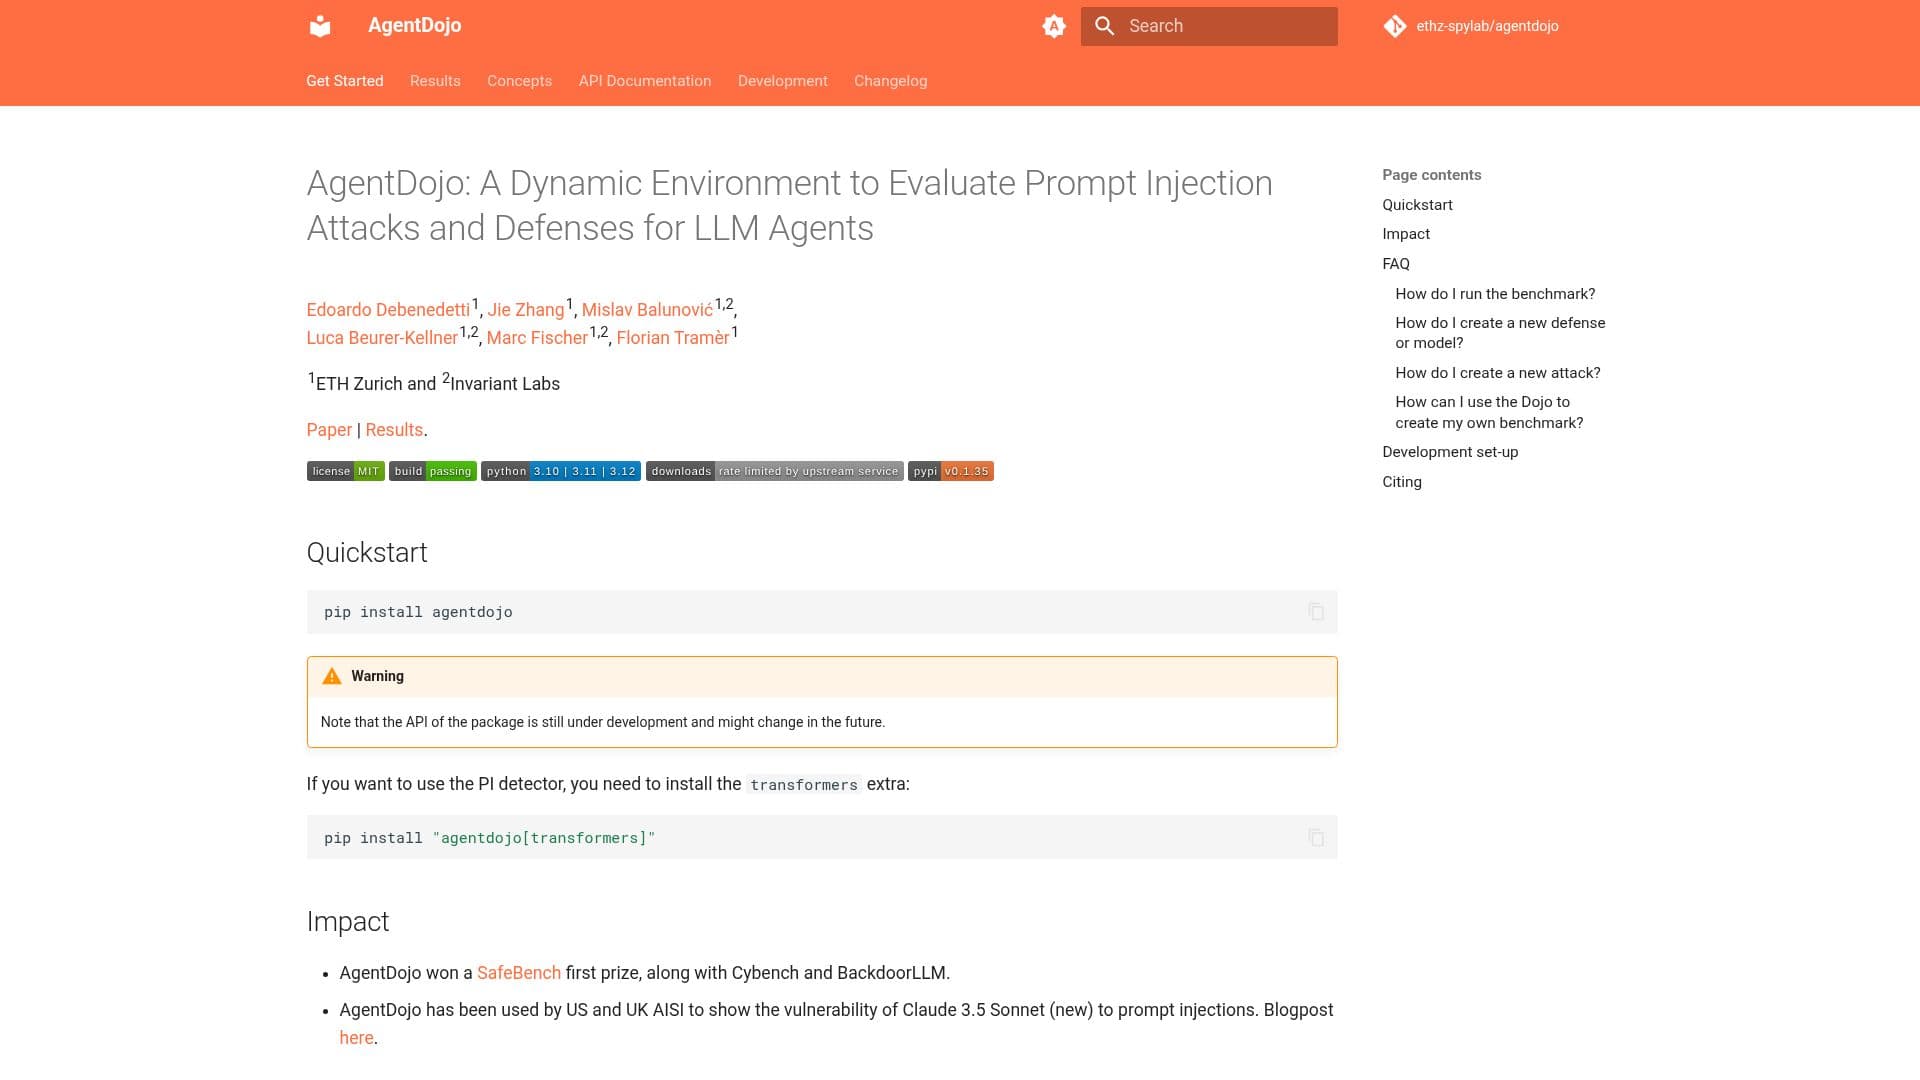
AgentDojo는 대형 언어 모델(LLM) 에이전트를 위한 프롬프트 주입 공격 및 방어를 평가하기 위해 개발된 정교한 플랫폼입니다. ETH 취리히와 Invariant Labs의 연구팀이 만든 AgentDojo는 AI 시스템의 취약성을 이해하고 완화하는 데 중요한 도구로 작용합니다. 이 플랫폼은 AI 안전에 대한 기여로 인정받아 Cybench 및 BackdoorLLM과 함께 SafeBench 1등상을 수상했습니다.
AgentDojo의 주요 기능은 사용자가 AI 모델의 프롬프트 주입 공격에 대한 회복력을 테스트하기 위해 벤치마크를 실행할 수 있는 통제된 환경을 제공하는 것입니다. 사용자는 패키지를 설치하고 스크립트를 사용하여 벤치마크를 실행할 수 있으며, 이 과정에서 안내하는 자세한 문서가 제공됩니다. 이는 AI 시스템의 보안을 강화하려는 연구자와 개발자에게 귀중한 자원이 됩니다.
AgentDojo는 또한 사용자가 새로운 방어 메커니즘과 모델을 생성할 수 있도록 하며, 사용자 정의 파이프라인을 개발하는 방법에 대한 포괄적인 문서를 제공합니다. 이러한 유연성은 사용자가 특정 요구에 맞게 방어를 조정할 수 있도록 하여 다양한 연구 및 개발 시나리오에 적응할 수 있게 합니다.
이 플랫폼의 영향력은 Claude 3.5 Sonnet과 같은 AI 모델의 프롬프트 주입에 대한 취약성을 보여주는 데 사용된 점에서 더욱 강조됩니다. 이 기능은 AI 기술을 안전하게 보호하기 위한 지속적인 노력에서 AgentDojo의 중요성을 강조합니다. 그러나 사용자는 API가 아직 개발 중이므로 향후 변경될 수 있음을 유의해야 합니다.
전반적으로 AgentDojo는 악의적인 공격에 대한 AI 시스템의 강건성을 개선하는 데 집중하는 AI 연구자, 개발자 및 보안 전문가를 대상으로 합니다. 그 포괄적인 기능과 적응성은 AI 보안 연구 분야에서 필수적인 도구로 만듭니다.
AgentDojo의 핵심 기능
프롬프트 주입 공격 평가
새로운 방어 모델 개발
스크립트를 사용한 벤치마크 실행
포괄적인 문서 제공
사용자 정의 파이프라인 생성
AI 취약성 시연
개발 중인 API
SafeBench 상 수상
AgentDojo 사용 방법은?
설치: 패키지를 다운로드하고 설정합니다.
벤치마크 실행: 모델을 테스트하기 위해 스크립트를 실행합니다.
개발: 새로운 방어 모델을 생성합니다.
문서: 설정을 위한 자세한 가이드를 참조합니다.
AgentDojo의 사용 사례
- AI 보안 연구
- 방어 모델 개발
- AI 시스템 벤치마킹
- 사용자 정의 파이프라인 생성
- AI 취약성 시연