メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Mirage

LLM#79AIモデルとLLM無料 · Hugging Face

Mirageは、高度な画像理解と構造化データ抽出のために設計されたビジョンモデルです。Hugging Faceでホストされており、ユーザーはさまざまなアプリケーションのためにモデルをダウンロード、探索、実行できます。このツールは、視覚情報を処理し、画像から意味のある整理されたデータを抽出する機能を提供し、マルチモーダルAIに取り組む開発者や研究者に適しています。

URLを訪問
共有
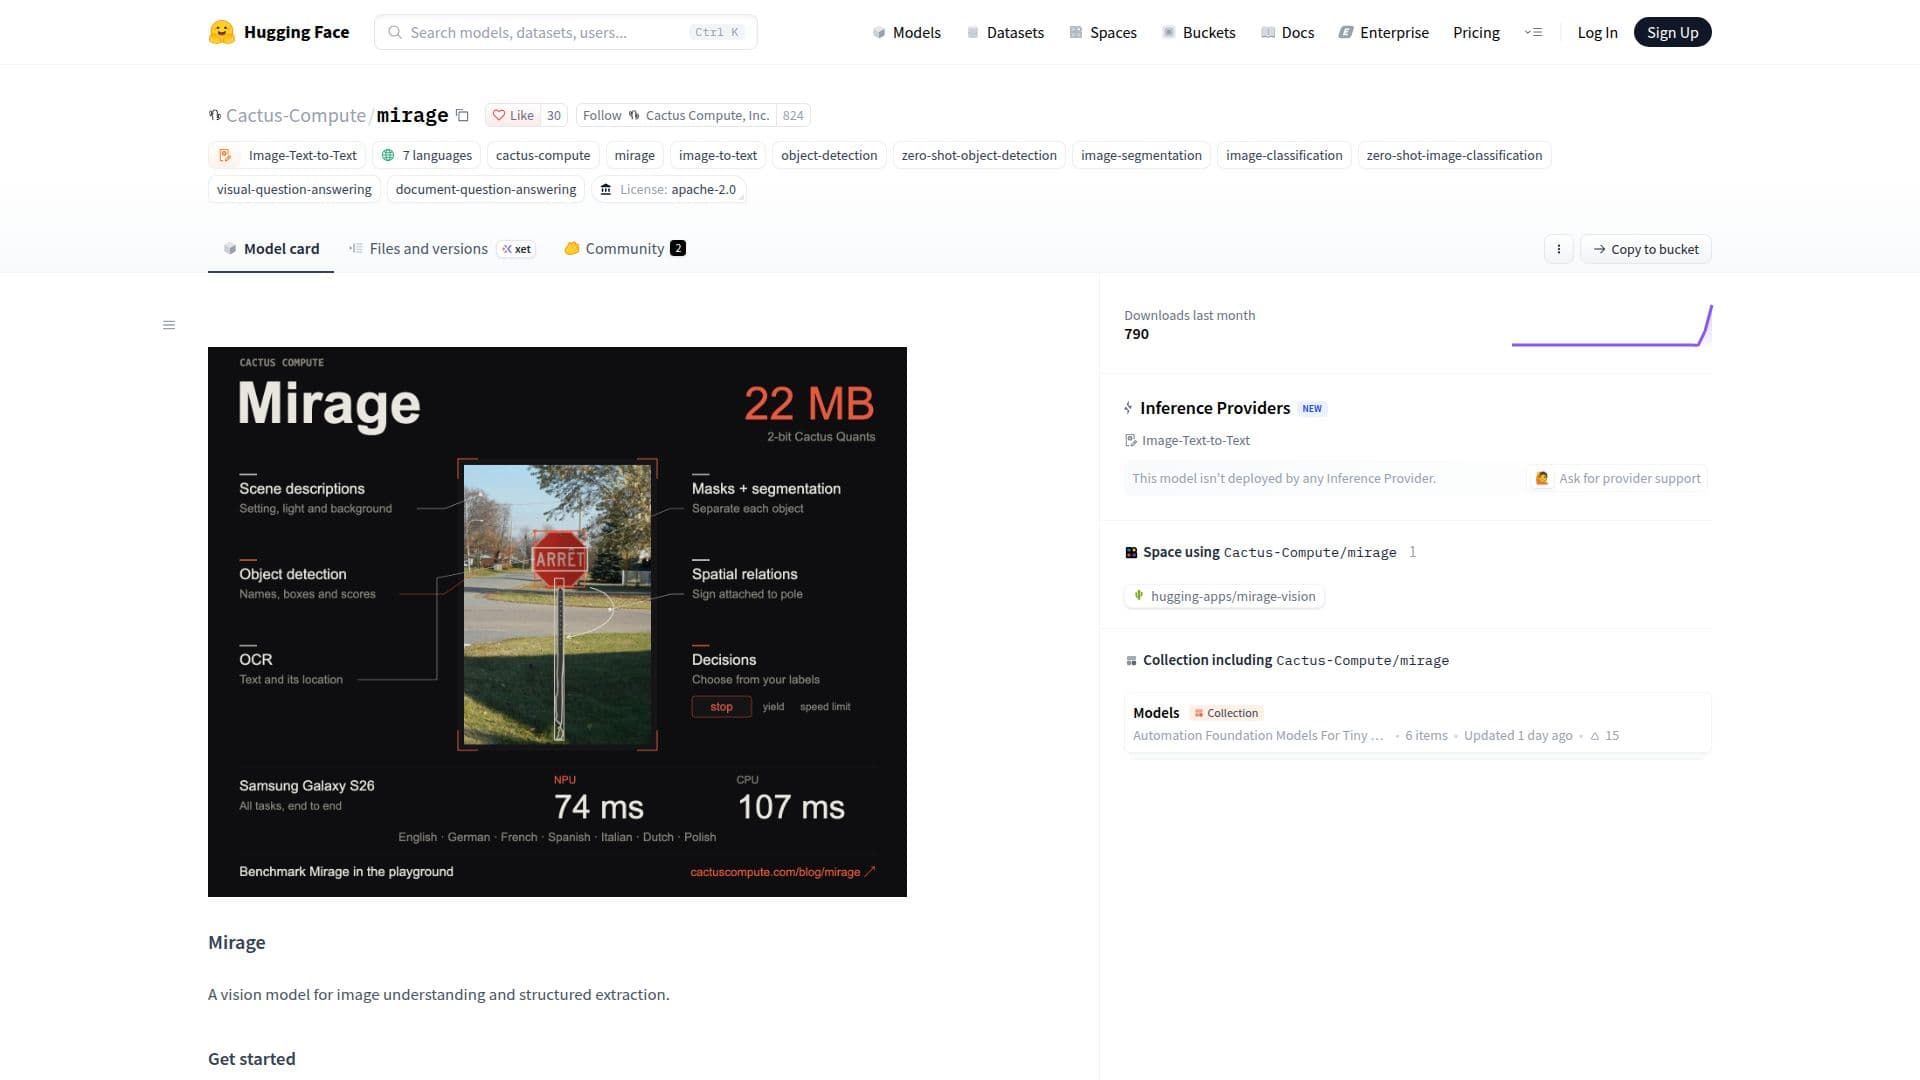
Mirage のスクリーンショット
Mirage のスクリーンショット

Mirageは、包括的な画像理解と視覚データからの構造化情報抽出のために特別に開発された高度なビジョンモデルです。Hugging Faceで簡単にアクセス、ダウンロード、デプロイできるため、ユーザーはプロジェクトに利用できます。

続きを読む

このモデルのコア機能は、画像を解釈し、視覚要素を整理された実行可能なデータに変換する能力にあります。これにより、Mirageは画像内のオブジェクト、テキスト、またはパターンを特定し、その情報をさらなる分析や他のシステムへの統合のために構造化する必要があるタスクに特に役立ちます。

初回使用時に、Mirageパッケージは必要なエンジンとウェイトを自動的にダウンロードしてキャッシュし、開発者のセットアッププロセスを簡素化します。リポジトリには、`mirage.cact`、`mirage.safetensors`、およびモデル構成を含む重要なコンポーネントが提供されており、ユーザーは開始に必要なすべてのファイルを持っています。

Mirageは、プログラムによるインタラクションのためのPython APIを提供し、開発者がその機能をアプリケーションやワークフローに統合できるようにします。さらに、ランタイムバイナリとサポートされているプラットフォームが提供されており、さまざまな環境での柔軟性を示しています。ソースコードの利用可能性は、透明性を促進し、コミュニティの貢献やカスタマイズを可能にします。

先月のダウンロード数は790件で、Mirageは開発者コミュニティからの活発な関心を示しています。Hugging Faceのさまざまなスペースやコレクションに存在することは、AIエコシステム内でのその有用性と採用を強調しています。Mirageは、視覚に基づくデータ抽出と理解のための堅牢なツールを求める研究者や開発者にとって理想的なソリューションです。

  • カテゴリーAIモデルとLLM
  • 料金モデル無料
  • デプロイクラウド
  • プラットフォームHugging Face

  • 画像理解機能

  • 画像からの構造化データ抽出

  • Hugging Faceで利用可能

  • ダウンロード可能なモデルエンジンとウェイト

  • 統合のためのPython API

  • 提供されるランタイムバイナリ

  • 複数のプラットフォームをサポート

  • ソースコードへのアクセス

  • モデル構成ファイルが含まれている

  • 活発なコミュニティの使用とダウンロード

  • 初回使用時にエンジンとウェイトをキャッシュ

  • mirage.cactファイルを提供

  • mirage.safetensorsファイルを提供

  • マルチモーダルAIアプリケーションに適している

  1. モデルページにアクセス: Hugging FaceのMirageモデルページに移動します。

  2. ファイルを探索: 提供された`mirage.cact`、`mirage.safetensors`、およびモデル構成ファイルを確認します。

  3. パッケージをダウンロード: Mirageパッケージをダウンロードし、初回使用時にエンジンとウェイトをキャッシュします。

  4. API経由で統合: Python APIを利用してMirageをアプリケーションに統合します。

  5. モデルを実行: 画像理解と構造化抽出タスクのためにモデルを実行します。

  6. ソースコードで開発: カスタマイズや深い理解のためにソースコードにアクセスします。

  • 画像コンテンツ分析
  • 構造化データ抽出
  • コンピュータビジョン研究
  • アプリケーション統合
  • モデル実験
  • 教育目的

Cactus Compute の製品

Mirage のレビュー

読み込み中...

Mirage に似た人気のAIツール

Llama-3.2-11B-Vision-Instructは、視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。

AIモデルとLLM
ツールを見る

視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。Llama-3.2-11B-Vision-Instructは、視覚認識、画像推論、キャプショニングのために設計されたマルチモーダルAIモデルです。Metaによって開発され、テキストと画像の入力を統合して高度な画像理解能力を提供します。

AIモデルとLLM
AI モデル トップ5を見る

Fuyu-8Bは、デジタルエージェント向けに設計されたオープンソースのマルチモーダルAIモデルです。そのシンプルなアーキテクチャは、任意の画像解像度をサポートし、グラフ、図、UI要素に関する質問に高速に応答することを可能にします。標準的なベンチマークで高い性能を発揮し、HuggingFaceで利用可能です。

AIモデルとLLM
ツールを見る

デジタルエージェント向けに設計されたオープンソースのマルチモーダルAIモデルです。そのシンプルなアーキテクチャは、任意の画像解像度をサポートし、グラフ、図、UI要素に関する質問に高速に応答することを可能にします。標準的なベンチマークで高い性能を発揮し、HuggingFaceで利用可能です。Fuyu-8Bは、デジタルエージェント向けに設計されたオープンソースのマルチモーダルAIモデルです。そのシンプルなアーキテクチャは、任意の画像解像度をサポートし、グラフ、図、UI要素に関する質問に高速に応答することを可能にします。標準的なベンチマークで高い性能を発揮し、HuggingFaceで利用可能です。

AIモデルとLLM
AI モデル トップ5を見る

LLaVA

AI GitHub リポジトリ

LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

Visionati

AI アプリ

Visionatiは、OpenAI、Claude、Geminiなどの複数のAIモデルを同時に使用して画像を説明するための統合APIを提供します。さまざまなモデルからの説明、タグ、検出結果を比較して、包括的な視覚的洞察を抽出します。高度な画像分析機能を求める開発者や企業に最適です。

コンピュータービジョンツール
ツールを見る

AI アプリ

OpenAI、Claude、Geminiなどの複数のAIモデルを同時に使用して画像を説明するための統合APIを提供します。さまざまなモデルからの説明、タグ、検出結果を比較して、包括的な視覚的洞察を抽出します。高度な画像分析機能を求める開発者や企業に最適です。Visionatiは、OpenAI、Claude、Geminiなどの複数のAIモデルを同時に使用して画像を説明するための統合APIを提供します。さまざまなモデルからの説明、タグ、検出結果を比較して、包括的な視覚的洞察を抽出します。高度な画像分析機能を求める開発者や企業に最適です。

コンピュータービジョンツール
AI アプリ トップ250を見る

LayoutLM

AI GitHub リポジトリ

LayoutLMは、視覚的にリッチなドキュメントの理解と情報抽出のためのマルチモーダル事前学習モデルです。テキスト、レイアウト、画像情報を組み合わせて、フォームやレシートの理解などのタスクで最先端の結果を達成します。このモデルは、多言語サポートを含む、さまざまなサイズとバージョンで利用可能です。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

視覚的にリッチなドキュメントの理解と情報抽出のためのマルチモーダル事前学習モデルです。テキスト、レイアウト、画像情報を組み合わせて、フォームやレシートの理解などのタスクで最先端の結果を達成します。このモデルは、多言語サポートを含む、さまざまなサイズとバージョンで利用可能です。LayoutLMは、視覚的にリッチなドキュメントの理解と情報抽出のためのマルチモーダル事前学習モデルです。テキスト、レイアウト、画像情報を組み合わせて、フォームやレシートの理解などのタスクで最先端の結果を達成します。このモデルは、多言語サポートを含む、さまざまなサイズとバージョンで利用可能です。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

Qwen3-VL

AI GitHub リポジトリ

Qwen3-VLは、Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…Qwen3-VLは、Alibaba CloudのQwenチームによるビジョン・ランゲージモデルシリーズで、DenseおよびMixture-of-Expertsサイズで、指示版と推論版("Thinking")がリリースされています。画像、動画、テキストを同時に読み取り、ネイティブの256Kコンテキストウィンドウを持ち、1Mまで拡張可能で、GUI自動化、OCR、…

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

Llama-4 Maverick 17B-128E Instructは、Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。

AIモデルとLLM
ツールを見る

Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。Llama-4 Maverick 17B-128E Instructは、Metaによって開発されたマルチモーダルAIモデルで、高度なテキストおよび画像理解のために設計されています。さまざまなアプリケーションで高いパフォーマンスを発揮するために、エキスパートの混合アーキテクチャを活用しています。

AIモデルとLLM
AI モデル トップ5を見る

Roboflowは、コンピュータビジョンモデルの構築とデプロイのためのエンドツーエンドプラットフォームを提供します。自動アノテーション、モデルトレーニング、スケーラブルな推論のためのツールを提供し、開発者や企業がリアルタイムストリーム、画像、ビデオのアプリケーションにビジュアルインテリジェンスを統合できるようにします。

コンピュータービジョンツール

AI アプリで第193位

ツールを見る

コンピュータビジョンモデルの構築とデプロイのためのエンドツーエンドプラットフォームを提供します。自動アノテーション、モデルトレーニング、スケーラブルな推論のためのツールを提供し、開発者や企業がリアルタイムストリーム、画像、ビデオのアプリケーションにビジュアルインテリジェンスを統合できるようにします。Roboflowは、コンピュータビジョンモデルの構築とデプロイのためのエンドツーエンドプラットフォームを提供します。自動アノテーション、モデルトレーニング、スケーラブルな推論のためのツールを提供し、開発者や企業がリアルタイムストリーム、画像、ビデオのアプリケーションにビジュアルインテリジェンスを統合できるようにします。

注目コンピュータービジョンツール
AI アプリで第193位
1 / 8