説明
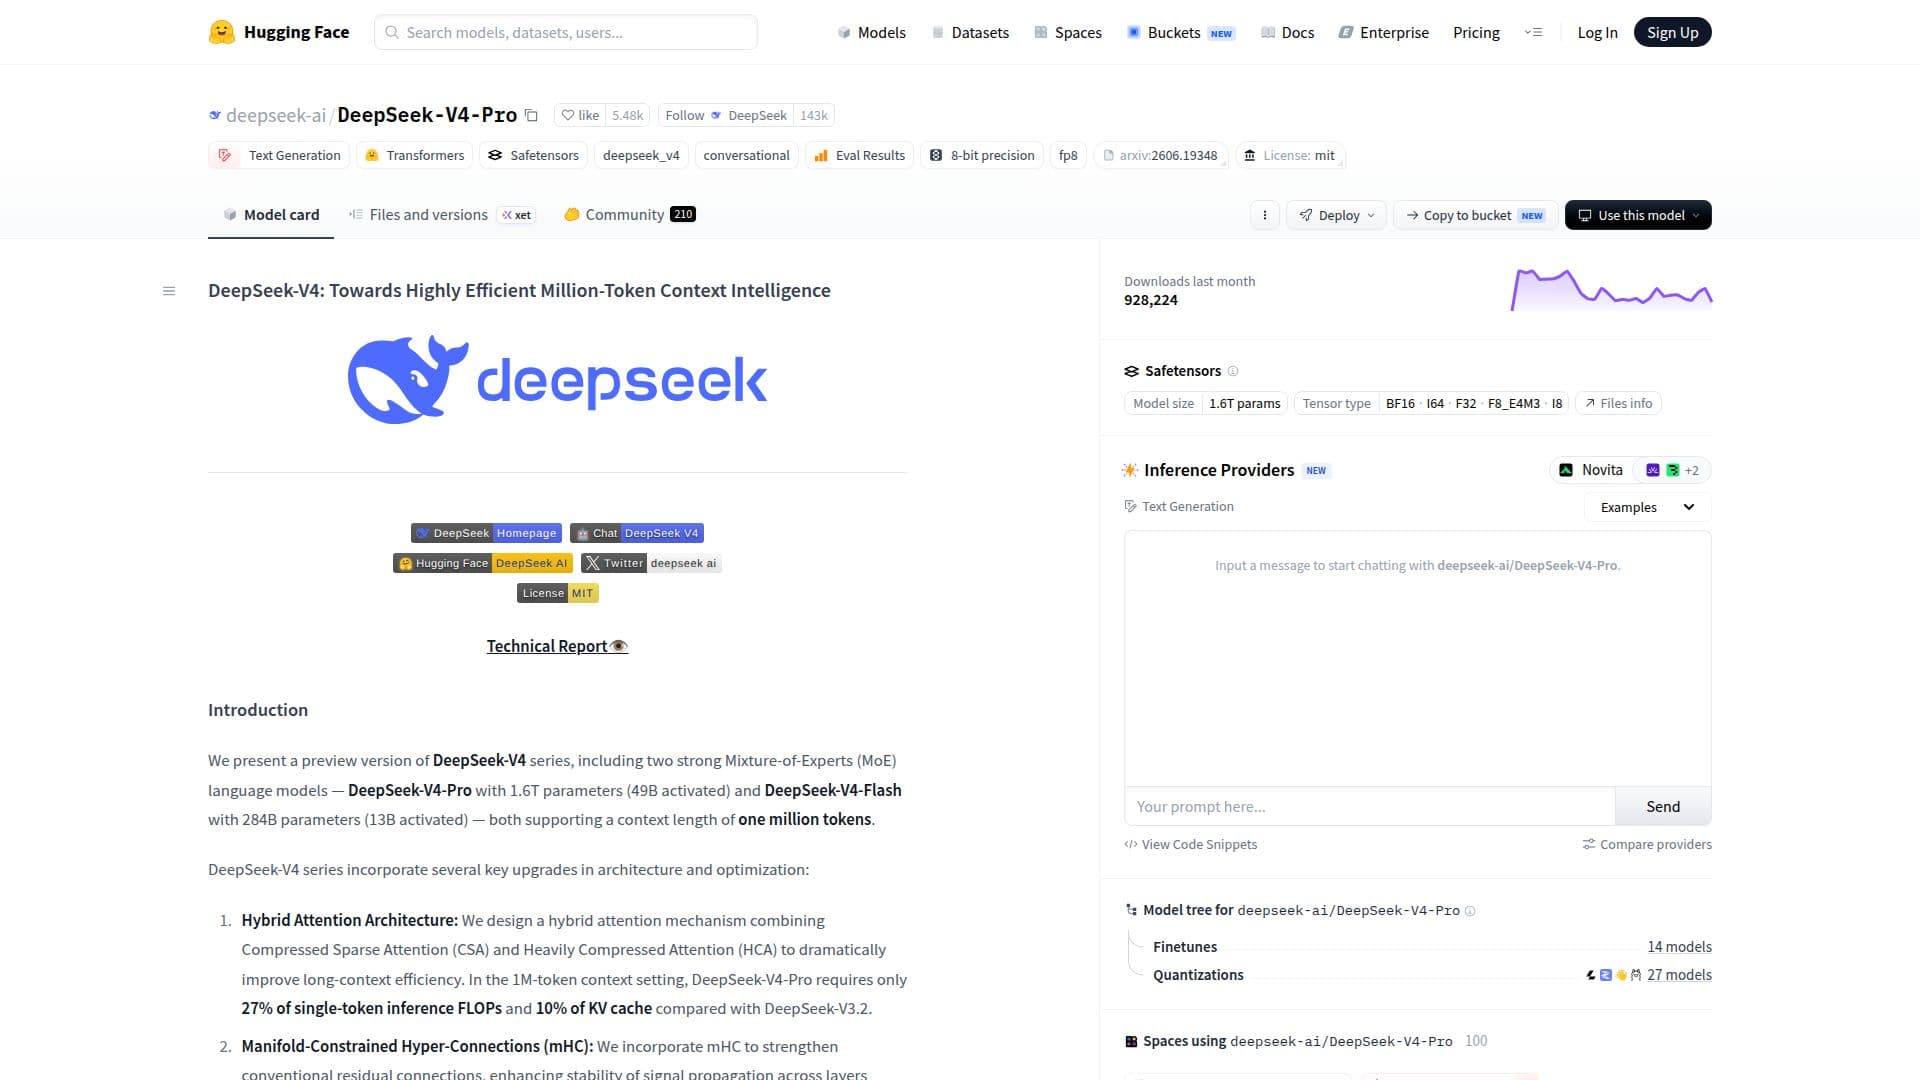
DeepSeek-V4-Proは、オープンソースとオープンサイエンスを通じて人工知能を進化させ、民主化することを目指すDeepSeek-V4シリーズの一部です。このモデルは、2つの強力なMixture-of-Experts (MoE)言語モデルを組み込んでおり、DeepSeek-V4-Proは1.6兆のパラメータを持ち、百万トークンのコンテキスト長をサポートしています。
DeepSeek-V4-Proのアーキテクチャには、Compressed Sparse Attention (CSA)とHeavily Compressed Attention (HCA)を組み合わせたハイブリッドアテンションメカニズムなど、いくつかの重要なアップグレードが含まれています。この設計は、長いコンテキストの効率を劇的に改善し、前モデルであるDeepSeek-V3.2と比較して、単一トークン推論のFLOPsの27%とKVキャッシュの10%のみを必要とします。さらに、このモデルは、層間の信号伝播の安定性を向上させつつ、モデルの表現力を維持するためにManifold-Constrained Hyper-Connections (mHC)を採用しています。
より迅速な収束と高いトレーニングの安定性を確保するために、Muonオプティマイザーが利用されています。このモデルは、32兆トークン以上の多様なデータセットで事前学習され、その後、ドメイン特化型の専門家の独立した育成と、オンポリシー蒸留を通じた統一モデルの統合を含む包括的なポストトレーニングパイプラインが実施されます。
DeepSeek-V4-Pro-Maxは、DeepSeek-V4-Proの最大推論努力モードであり、オープンソースモデルの知識能力を大幅に向上させます。コーディングベンチマークでトップクラスのパフォーマンスを達成し、推論およびエージェントタスクにおいて先進的なクローズドソースモデルとのギャップを効果的に埋めます。このモデルの能力は、複雑な問題解決や計画タスクを含む幅広いアプリケーションに適しており、AI分野の開発者や研究者にとって貴重なツールとなります。
DeepSeek-V4-Proのハイライト
モデルタイプ: Mixture-of-Experts
総パラメータ数: 1.6T
アクティブパラメータ数: 49B
コンテキスト長: 1Mトークン
ハイブリッドアテンションアーキテクチャ: はい
Muonオプティマイザー: はい
事前学習データ: 32Tトークン
ライセンス: MIT
DeepSeek-V4-Proをはじめる
モデルにアクセス: DeepSeek-V4-ProのHugging Faceページを訪問してください。
認証: 必要に応じてアカウントを作成してください。
環境を設定: 必要なライブラリと依存関係が揃っていることを確認してください。
API経由で統合: 提供されたAPIドキュメントを使用してモデルに接続してください。
最適化: 最良のパフォーマンスのためにサンプリングパラメータを調整してください。
DeepSeek-V4-Proの使用例
- 複雑な問題解決
- コーディングベンチマーク
- 研究アプリケーション
- 自然言語処理
- エージェントタスク