

メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

BERT 多言語モデル

LLM#50AIモデルとLLMオープンソース · Web

BERTは、100以上の言語をサポートするCasedとUncasedの2つの多言語モデルを提供しています。Casedモデルは、ラテン文字以外のアルファベットや一般的な用途に推奨され、Uncasedモデルは旧バージョンです。これらのモデルは自然言語理解タスク向けに設計されており、特定のアプリケーションに合わせてファインチューニングできます。

URLを訪問
共有
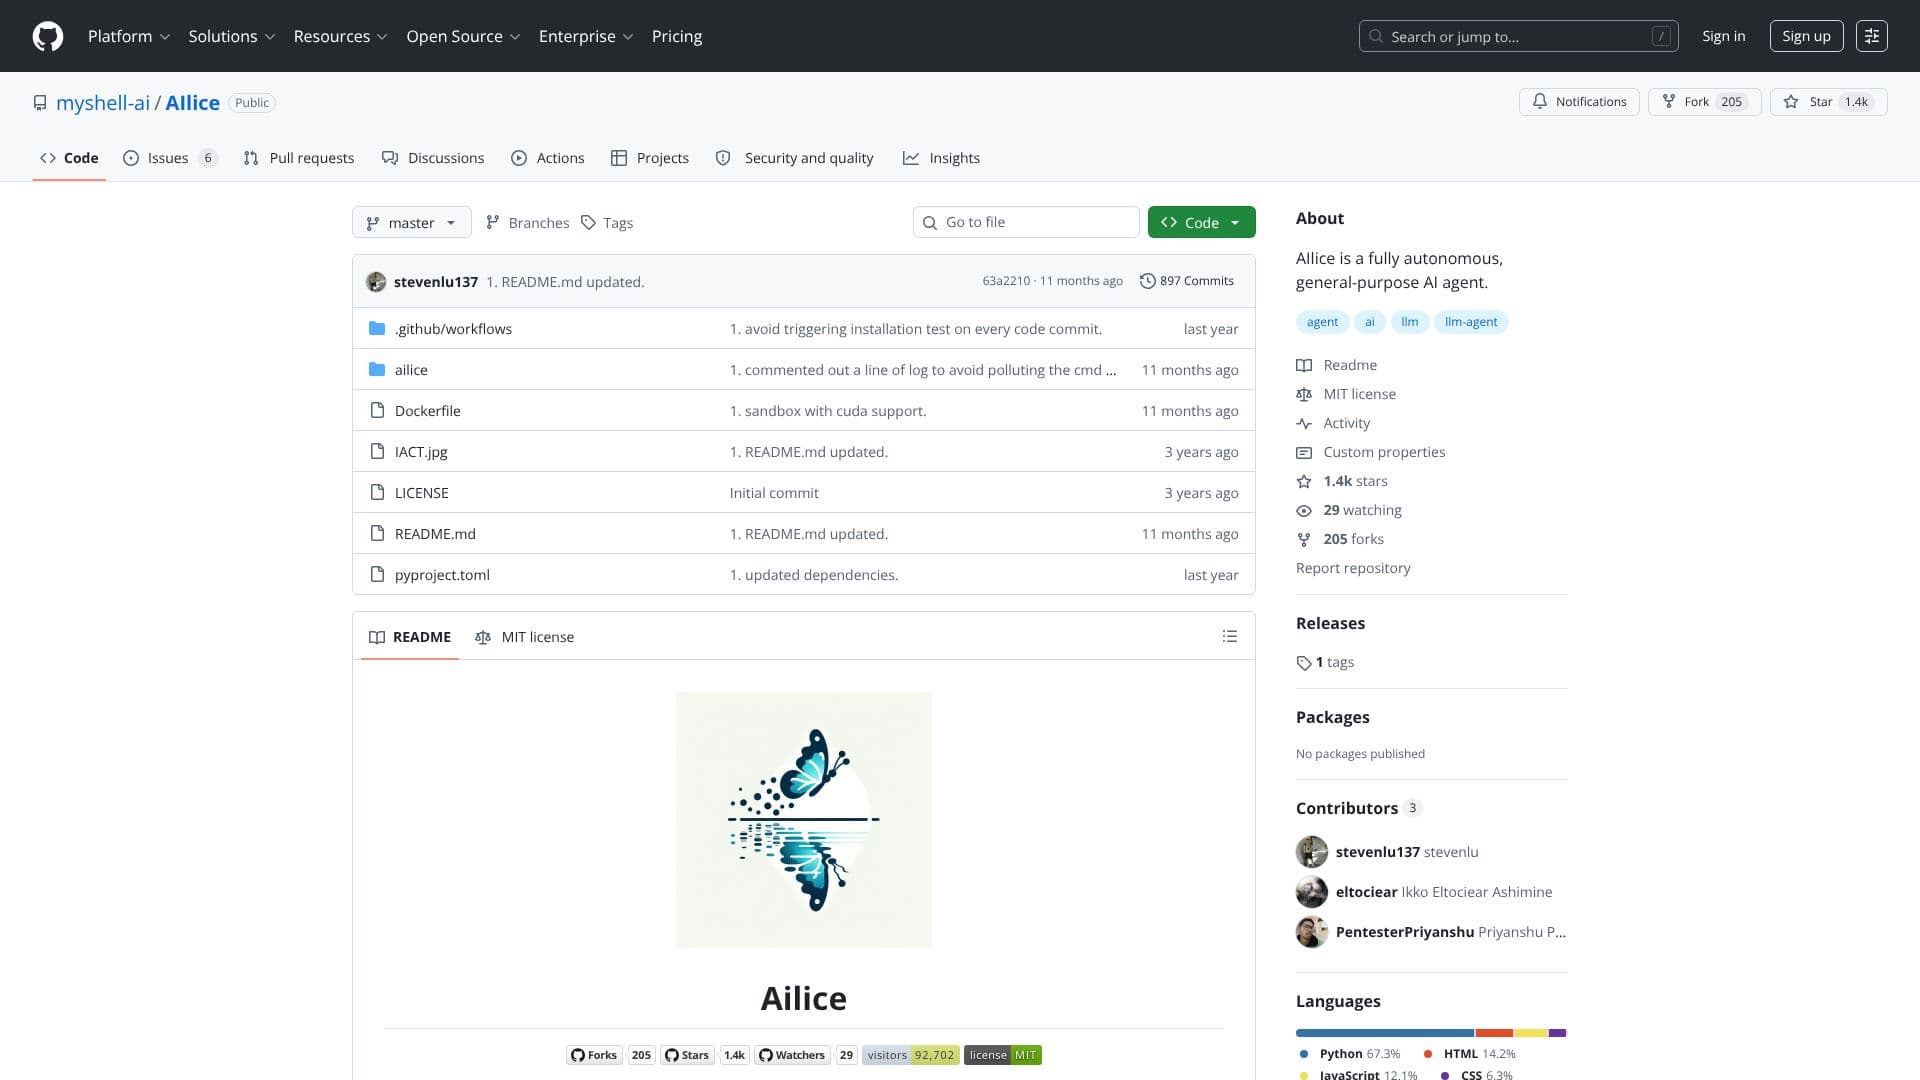
BERT 多言語モデル のスクリーンショット

BERT(Bidirectional Encoder Representations from Transformers)プロジェクトは、自然言語処理タスク向けの事前学習済みモデルを提供しています。その提供物の中には、幅広い言語に対応できるように設計された多言語モデルがあり、クロスリンガルな理解とアプリケーションを可能にします。現在、主に2つの多言語モデルが利用可能です:BERT-Base, Multilingual Cased(新規、推奨)とBERT-Base, Multilingual Uncased(旧、非推奨)。

続きを読む

BERT-Base, Multilingual Casedモデルは104言語をサポートし、12層のアーキテクチャ、768の隠れユニット、12のアテンションヘッド、1億1千万のパラメータを備えています。このモデルは、多くの言語、特にラテン文字以外のアルファベットを持つ言語に対する正規化が改善されているため推奨されます。このモデルを使用する際は、実行スクリプトで`--do_lower_case=false`を設定することが重要です。Multilingual Uncasedモデルは、同じアーキテクチャで102言語をサポートしますが、新規プロジェクトには推奨されません。

中国語タスク向けには、簡体字と繁体字中国語をサポートする専用のBERT-Base, Chineseモデルも利用可能です。多言語モデルには中国語が含まれていますが、中国語固有のファインチューニングでは、中国語専用モデルの方が優れた結果をもたらす可能性があります。これらのモデルのパフォーマンスは、クロスリンガル自然言語推論タスクであるXNLIデータセットで評価されています。結果は、高リソース言語においては単一言語モデルが多言語モデルを上回る可能性がある一方で、後者は多数の単一言語モデルを維持する必要なしに、広範な言語カバレッジのための実用的なソリューションを提供するということを示しています。

多言語BERTモデルのファインチューニングには、大幅なAPI変更は必要ありません。ただし、中国語文字のトークン化には`BasicTokenizer`の更新が必要になる場合があります。モデルは、XNLIのようなデータセットをサポートするように更新された`run_classifier.py`のような提供スクリプトを使用してワークフローに統合できます。事前学習のためのデータサンプリング戦略は、高リソース言語と低リソース言語のバランスを取るために、Wikipediaデータの指数平滑化重み付けを含み、すべての言語のより良い表現を保証しました。トークン化は共有WordPiece語彙を使用し、空白文字の欠如に対処するためにCJK言語に特別な処理を行います。多言語モデルは、ゼロショット学習機能を促進するために、意図的に言語マーカーを省略しています。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 104言語をサポート(Multilingual Cased)

  • 102言語をサポート(Multilingual Uncased)

  • 12層トランスフォーマーアーキテクチャ

  • 768隠れユニット

  • 12アテンションヘッド

  • 1億1千万パラメータ

  • 正規化改善のためMultilingual Casedモデルを推奨

  • ゼロショット学習機能

  • 特定タスク向けのファインチューニングサポート

  • Wikipediaデータで事前学習済み

  • 共有WordPiece語彙

  • 文字トークン化によるCJK言語の処理

  • オープンソースのTensorFlowコード利用可能

  1. モデルへのアクセス:事前学習済み多言語BERTモデルをダウンロードします。

  2. 環境設定:TensorFlowおよび必要な依存関係をインストールします。

  3. API経由での統合:提供されているライブラリを使用してモデルとトークナイザーをロードします。

  4. データ準備:多言語テキストデータをトレーニングまたは推論用にフォーマットします。

  5. ファインチューニング:分類や質問応答などの特定のダウンストリームタスクにモデルを適応させます。

  6. 推論の実行:ファインチューニングされたモデルを使用して新しいテキストデータを処理します。

  7. パフォーマンス評価:関連する多言語ベンチマークでモデルの精度を評価します。

  • クロスリンガル分類
  • 多言語感情分析
  • ゼロショットクロスリンガル転移
  • 機械翻訳評価
  • 多言語質問応答
  • クロスリンガル情報検索
  • 自然言語推論

Google の製品

BERT 多言語モデル のレビュー

読み込み中...

BERT 多言語モデル に似た人気のAIツール

BERT base uncased

AI モデル

BERTベースモデル(未ケース)は、英語を理解するために設計された事前学習済みのトランスフォーマーモデルです。マスク付き言語モデルと次の文予測を利用して文脈的関係を学習し、さまざまなNLPタスクに適しています。

自然言語処理ツール
ツールを見る

AI モデル

BERTベースモデル(未ケース)は、英語を理解するために設計された事前学習済みのトランスフォーマーモデルです。マスク付き言語モデルと次の文予測を利用して文脈的関係を学習し、さまざまなNLPタスクに適しています。

注目自然言語処理ツール
AI モデル トップ5を見る

SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM

LLMで第45位

ツールを見る

3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM
LLMで第45位

SpanBERT

AI GitHub リポジトリ

SpanBERTは、テキストの範囲(スパン)の表現と予測に焦点を当てることで、事前学習の改善を目指すAIモデルです。HuggingFace BERTフォーマットと互換性のある、事前学習済みのベースモデルとラージモデルを提供します。このリポジトリには、質問応答や関係抽出を含む様々なNLPタスクでSpanBERTを使用および評価するためのコードが含まれています。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

テキストの範囲(スパン)の表現と予測に焦点を当てることで、事前学習の改善を目指すAIモデルです。HuggingFace BERTフォーマットと互換性のある、事前学習済みのベースモデルとラージモデルを提供します。このリポジトリには、質問応答や関係抽出を含む様々なNLPタスクでSpanBERTを使用および評価するためのコードが含まれています。SpanBERTは、テキストの範囲(スパン)の表現と予測に焦点を当てることで、事前学習の改善を目指すAIモデルです。HuggingFace BERTフォーマットと互換性のある、事前学習済みのベースモデルとラージモデルを提供します。このリポジトリには、質問応答や関係抽出を含む様々なNLPタスクでSpanBERTを使用および評価するためのコードが含まれています。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

XLM-RoBERTa Base

AI モデル

XLM-RoBERTaは、100の言語にわたる2.5TBのデータで事前学習された多言語モデルです。シーケンス分類やトークン分類などのタスクに優れており、さまざまな自然言語処理アプリケーションにとって貴重なツールです。

AIモデルとLLM
ツールを見る

AI モデル

100の言語にわたる2.5TBのデータで事前学習された多言語モデルです。シーケンス分類やトークン分類などのタスクに優れており、さまざまな自然言語処理アプリケーションにとって貴重なツールです。XLM-RoBERTaは、100の言語にわたる2.5TBのデータで事前学習された多言語モデルです。シーケンス分類やトークン分類などのタスクに優れており、さまざまな自然言語処理アプリケーションにとって貴重なツールです。

注目AIモデルとLLM
AI モデル トップ5を見る

DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

AIモデルとLLM

LLMで第2位

ツールを見る

一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

注目AIモデルとLLM
LLMで第2位

Qwen1.5-110Bは、重要な性能向上、マルチリンガルサポート、安定した32Kコンテキスト長を提供するトランスフォーマーベースの言語モデルです。高度なAIアプリケーションに最適です。

AIモデルとLLM
ツールを見る

重要な性能向上、マルチリンガルサポート、安定した32Kコンテキスト長を提供するトランスフォーマーベースの言語モデルです。高度なAIアプリケーションに最適です。Qwen1.5-110Bは、重要な性能向上、マルチリンガルサポート、安定した32Kコンテキスト長を提供するトランスフォーマーベースの言語モデルです。高度なAIアプリケーションに最適です。

AIモデルとLLM
AI モデル トップ5を見る

intfloat multilingual-e5-largeモデルは、多言語テキスト埋め込みのために設計された堅牢なAIツールです。100の言語をサポートし、テキスト検索や意味的類似性などのタスクに最適化されており、多様なデータセットで高いパフォーマンスを提供します。

AIモデルとLLM
ツールを見る

intfloat multilingual-e5-largeモデルは、多言語テキスト埋め込みのために設計された堅牢なAIツールです。100の言語をサポートし、テキスト検索や意味的類似性などのタスクに最適化されており、多様なデータセットで高いパフォーマンスを提供します。

AIモデルとLLM
AI モデル トップ5を見る

Llama-3.1-8B-Instructは、Metaによって開発された多言語大規模言語モデルで、指示ベースのタスクに最適化されています。商業および研究用途向けに設計されており、自然言語理解と生成において高度な機能を提供します。

AIモデルとLLM
ツールを見る

Metaによって開発された多言語大規模言語モデルで、指示ベースのタスクに最適化されています。商業および研究用途向けに設計されており、自然言語理解と生成において高度な機能を提供します。Llama-3.1-8B-Instructは、Metaによって開発された多言語大規模言語モデルで、指示ベースのタスクに最適化されています。商業および研究用途向けに設計されており、自然言語理解と生成において高度な機能を提供します。

注目AIモデルとLLM
AI モデル トップ5を見る
1 / 8








