説明
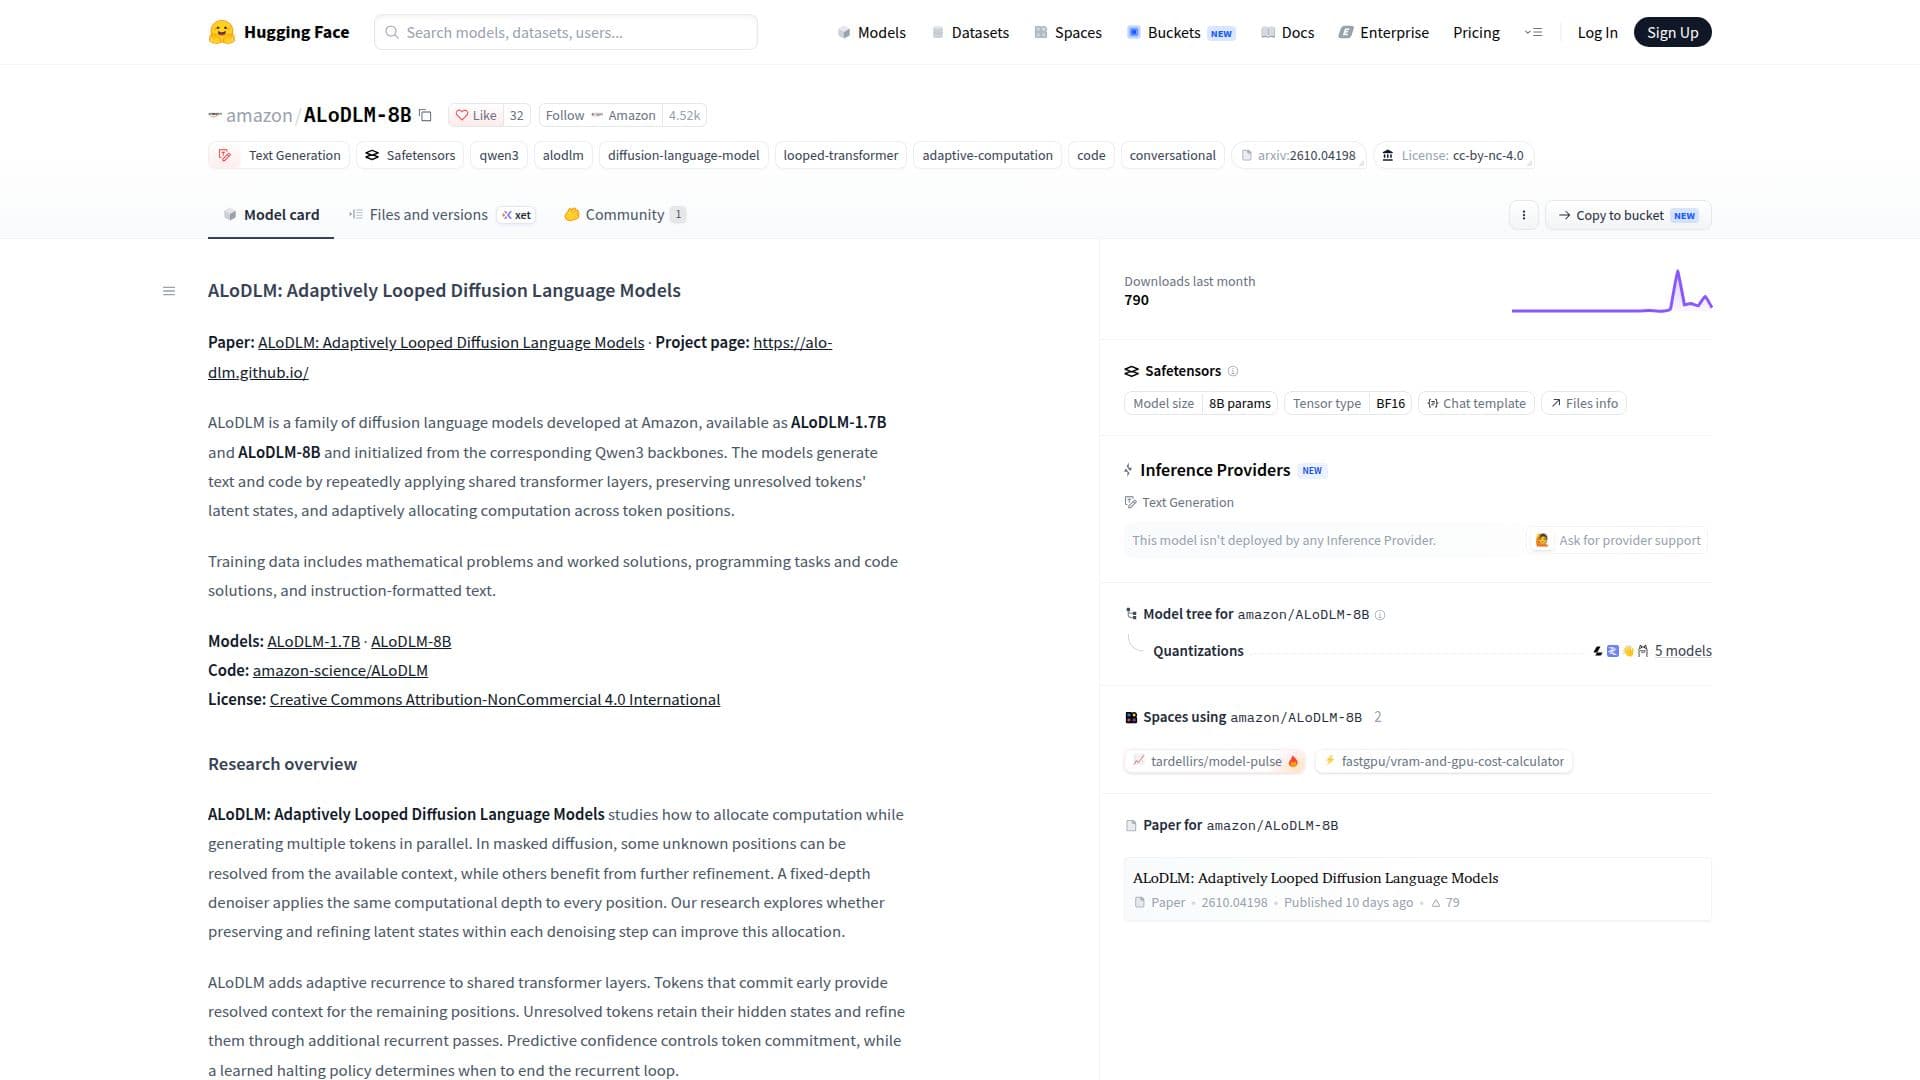
ALoDLM-8Bは、Amazonによって開発された拡散言語モデルのALoDLMファミリーの一部です。これらのモデルは、共有トランスフォーマ層を繰り返し適用することによってテキストとコードを生成するように設計されています。ALoDLM-8Bは、その小型の対応モデルであるALoDLM-1.7Bと共に、Qwen3バックボーンから初期化されます。モデルは、未解決トークンの潜在状態を保持し、トークン位置全体に計算を効果的に割り当てるために適応計算を利用します。
続きを読む
ALoDLM-8Bのトレーニングデータには、数学の問題と解決策、プログラミングタスク、指示形式のテキストが含まれています。この多様なデータセットにより、モデルはさまざまな言語およびコード生成タスクで優れた性能を発揮します。モデルのアーキテクチャは、共有トランスフォーマ層における適応再帰を特徴としており、早期にコミットしたトークンが残りの位置に対して解決されたコンテキストを提供できるようにしています。未解決トークンはその隠れ状態を保持し、追加の再帰的パスを通じてそれらを洗練します。
ALoDLM-8Bの研究は、複数のトークンを並行して生成する際の計算の割り当てを探求します。モデルは、すべての位置に同じ計算深度を適用するために固定深度のデノイザーを使用し、適応再帰は各デノイジングステップ内で潜在状態を保持し洗練することによって割り当てを改善します。モデルの予測信頼度はトークンのコミットメントを制御し、学習された停止ポリシーが再帰ループを終了するタイミングを決定します。
ALoDLM-8Bの意図された使用は、拡散言語モデリング、適応計算、数学的推論、およびコード生成に関する非商業的研究です。報告されたベンチマークは、自律的な操作や重大な結果を伴う決定の準備が整っていることを確立していないため、特定のアプリケーションに対してモデルを評価することが重要です。このモデルは、クリエイティブ・コモンズ 表示-非営利 4.0 国際ライセンスの下でライセンスされており、その重みは一般に公開されています。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド
- プラットフォームWeb
ALoDLM-8Bのハイライト
適応計算の割り当て
持続的な潜在状態の洗練
推論時の制御
共有トランスフォーマ層
未解決トークンのための再帰的パス
トークンコミットメントのための予測信頼度
学習された停止ポリシー
非商業的研究のサポート
ALoDLM-8Bをはじめる
モデルページにアクセス: ALoDLM-8BのHugging Faceモデルページを訪問します。
認証: 必要に応じてHugging Faceアカウントにログインします。
設定: Pythonと必要なライブラリを使用してモデル環境を設定します。
プロンプトを送信: プロンプトを送信してテキストまたはコードを生成するためにモデルを使用します。
ファインチューニング: 必要に応じて特定のタスクのためにモデルパラメータを調整します。
ALoDLM-8Bの使用例
- テキスト生成
- コード生成
- 数学的推論
- 研究
- 適応計算