説明
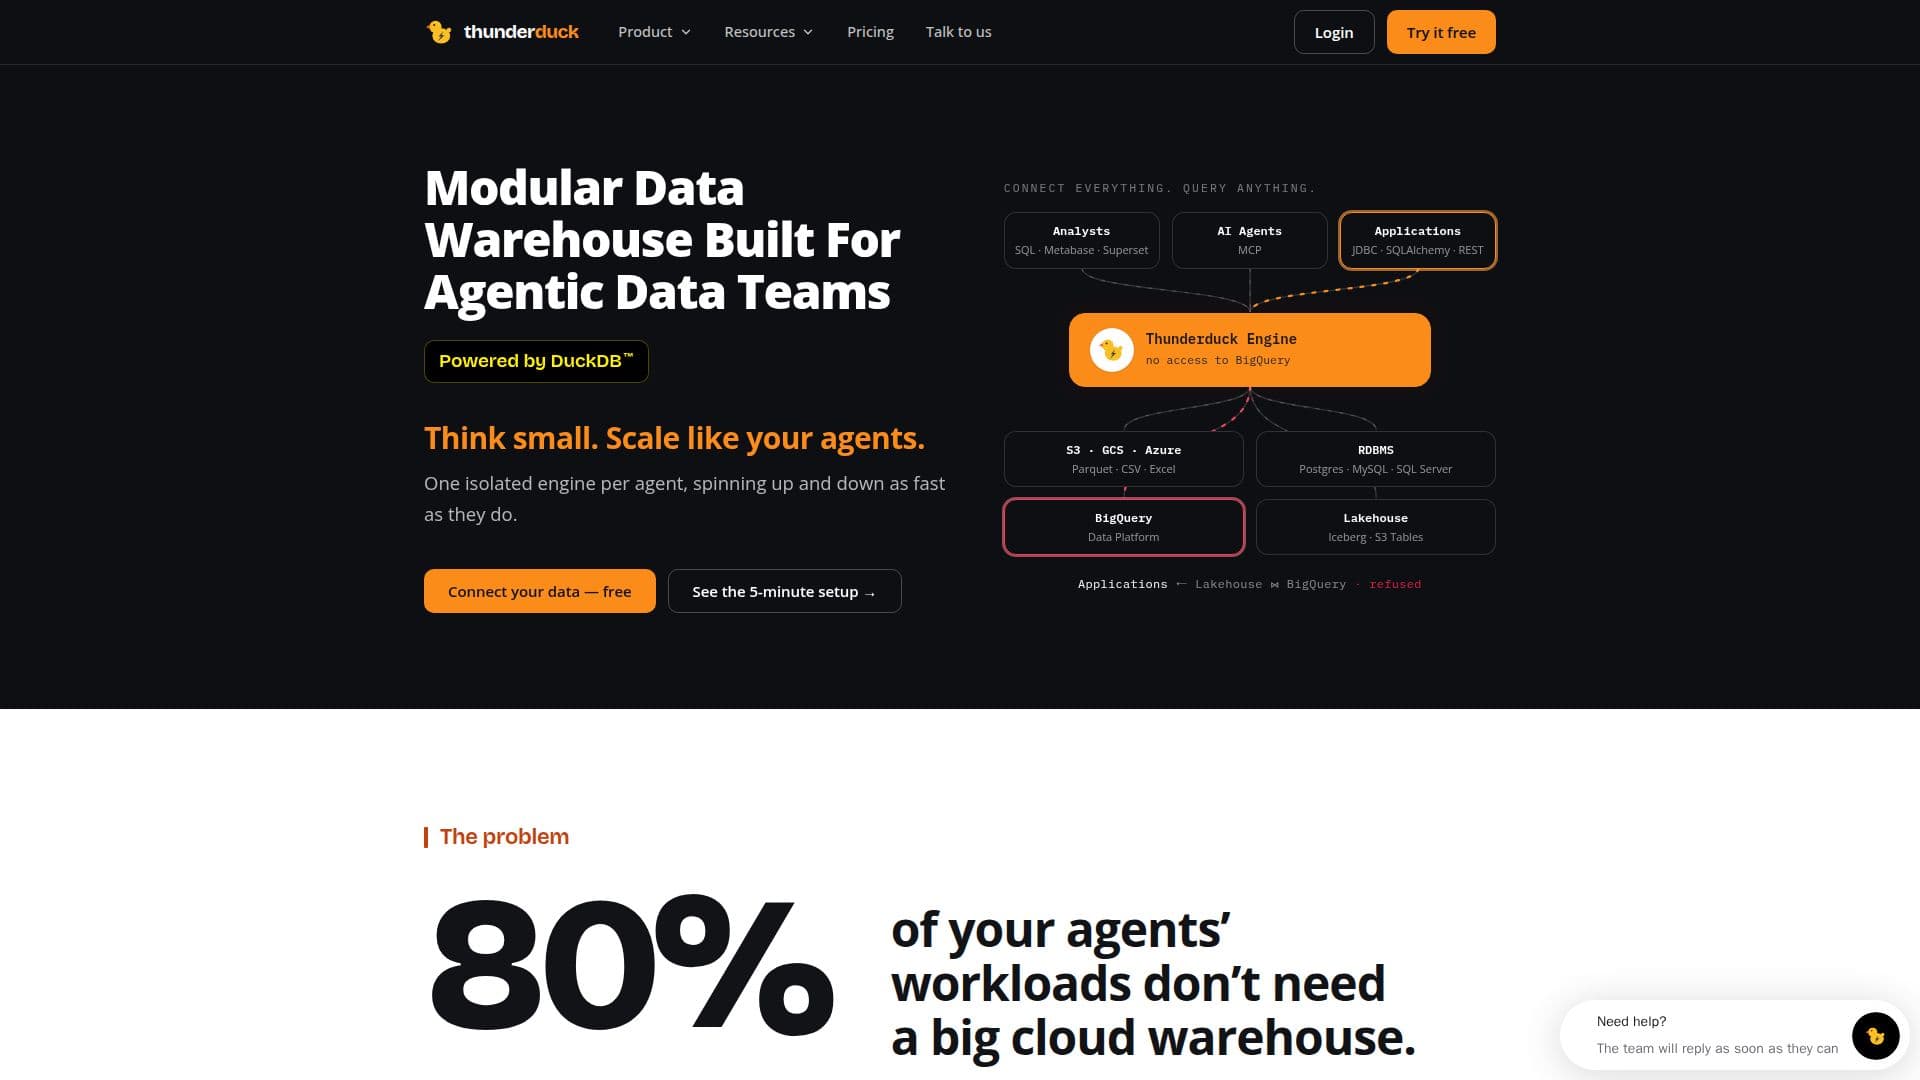
Thunderduckは、DuckDBの力を活用してエージェントデータチーム向けに特別に設計されたモジュラー型データウェアハウスソリューションを提供します。これは、エージェントの80%のワークロードが大規模なクラウドウェアハウスを必要としないという一般的な問題に対処し、チームが分散システムのコストや管理サービスのプレミアムを負担することを防ぎます。各エージェントに対して1つの孤立したエンジンを提供することで、Thunderduckはエンジンを迅速に立ち上げたり停止したりでき、エージェントワークロードの動的な性質に対応します。
続きを読む
このプラットフォームは、実行中のエージェントの数に関係なく、テラバイトのデータに対してサブ秒のクエリを提供するように設計されています。データパイプラインの構築を簡素化し、DevOpsのタスクを自動化し、企業レベルのガバナンスを維持します。ユーザーは、クラウドのような柔軟性を持つオンプレミスまたは既存のクラウドインフラストラクチャ内でThunderduckをどこにでもデプロイする柔軟性を持っています。
Thunderduckの中心には、ベクトル化エンジンを持つオープンソースのインプロセス分析データベースであるDuckDBが利用されています。このアーキテクチャにより、コードが実行される場所で動作し、サーバー管理の必要がなくなります。マルチテナンシーをサポートし、企業レベルのセキュリティを提供し、データの主権を確保するために、ユーザーのクラウドまたはデータセンター内でデータを保持し、アクセスルールを適用します。
Thunderduckは、MCPを介してClaude、ChatGPT、CursorなどのAIエージェントとのシームレスな統合を促進します。エージェントは、テーブルやカラムの意味を名前だけでなく解釈し、適切なテーブルを見つけ、パーティションやインデックスを読み取り、効率的なクエリを作成できます。これらのクエリは、事前に定義された役割とコスト制限の下で実行されます。このプラットフォームは、メダリオンレイヤーに従ったdbtモデルの構築を自動化し、ブランチでのテストやプルリクエストの作成を行い、クリーンで管理しやすいデータマートを維持します。
クエリフェデレーションをゼロETLでサポートし、ユーザーはPostgres、BigQuery、Icebergテーブル、ファイルなどのさまざまなソースからデータを単一のクエリで結合でき、フィルターは各ソースにプッシュダウンされます。これにより、データのコピー、ロードジョブ、または小規模でアドホックなデータの同期管理が不要になります。データセットが増加したりモデリングが必要になった場合、ユーザーはIcebergにdbtパイプラインを構築し、一貫してクエリを続けることができます。Thunderduckは、クエリが実行される前に各クエリのコスト見積もりを提供し、予算管理を可能にし、予期しない費用を防ぎます。
- カテゴリーAI SQL・データベースツール
- 料金モデルフリーミアム
- デプロイクラウド、オンプレミス
- プラットフォームWeb
Thunderduckの主要機能
モジュラー型データウェアハウスアーキテクチャ
エージェントごとの孤立したDuckDBエンジン
テラバイトのデータに対するサブ秒クエリ
オンプレミスまたはクラウド内のデプロイオプション
自動化されたDevOps作業
企業レベルのガバナンス
マルチテナントサポート
分散オーバーヘッドのない低遅延
データの主権とアクセスルール
MCPを介したAIエージェント(Claude、ChatGPT、Cursor)との統合
AI支援によるクエリ生成とdbtモデル構築
多様なソース(PostgreSQL、BigQuery、Iceberg、S3)を横断するクエリフェデレーション
自動スキーマ、テーブル、カラム、タイプの発見
実行前の各クエリのコストと実行時間の見積もり
AIによる失敗したクエリの診断と修正提案
カタログに対する役割ベースのアクセス制御
即時の無料リピートクエリのためのクエリキャッシング
Thunderduckの使い方は?
カタログを接続する: データベース、ウェアハウス、レイクハウス、またはオブジェクトストレージなどのデータソースの資格情報を提供します。
データを発見する: Thunderduckは自動的にスキーマ、テーブル、カラムを読み取り、カラムの意味を推測し、常に最新の状態を保ちます。
クエリと結合: 任意のテーブルをcatalog.schema.tableとして指定し、単一のSQL文で複数のソースを結合します。
AIエージェントを統合する: Claude、ChatGPT、または他のMCPクライアントを接続して、AIエージェントがカタログを参照し、SQLを実行できるようにします。
ワークフローを自動化する: SQL文をcronスケジュールでスケジュールするか、dbtリポジトリを接続してビルド、テスト、スナップショットを実行します。
監視とガバナンス: 事前クエリコスト見積もり、監査ログ、役割ベースのアクセス制御を利用して、使用状況とセキュリティを管理します。
Thunderduckの使用例
- エージェントデータワークロード
- データチームのコスト最適化
- リアルタイムデータ分析
- データパイプラインの自動化
- データの主権とセキュリティ
- AI支援によるクエリ
- クロスソースデータ結合
- プロアクティブなコスト管理
- データガバナンスと監査
- レイクハウス構築