説明
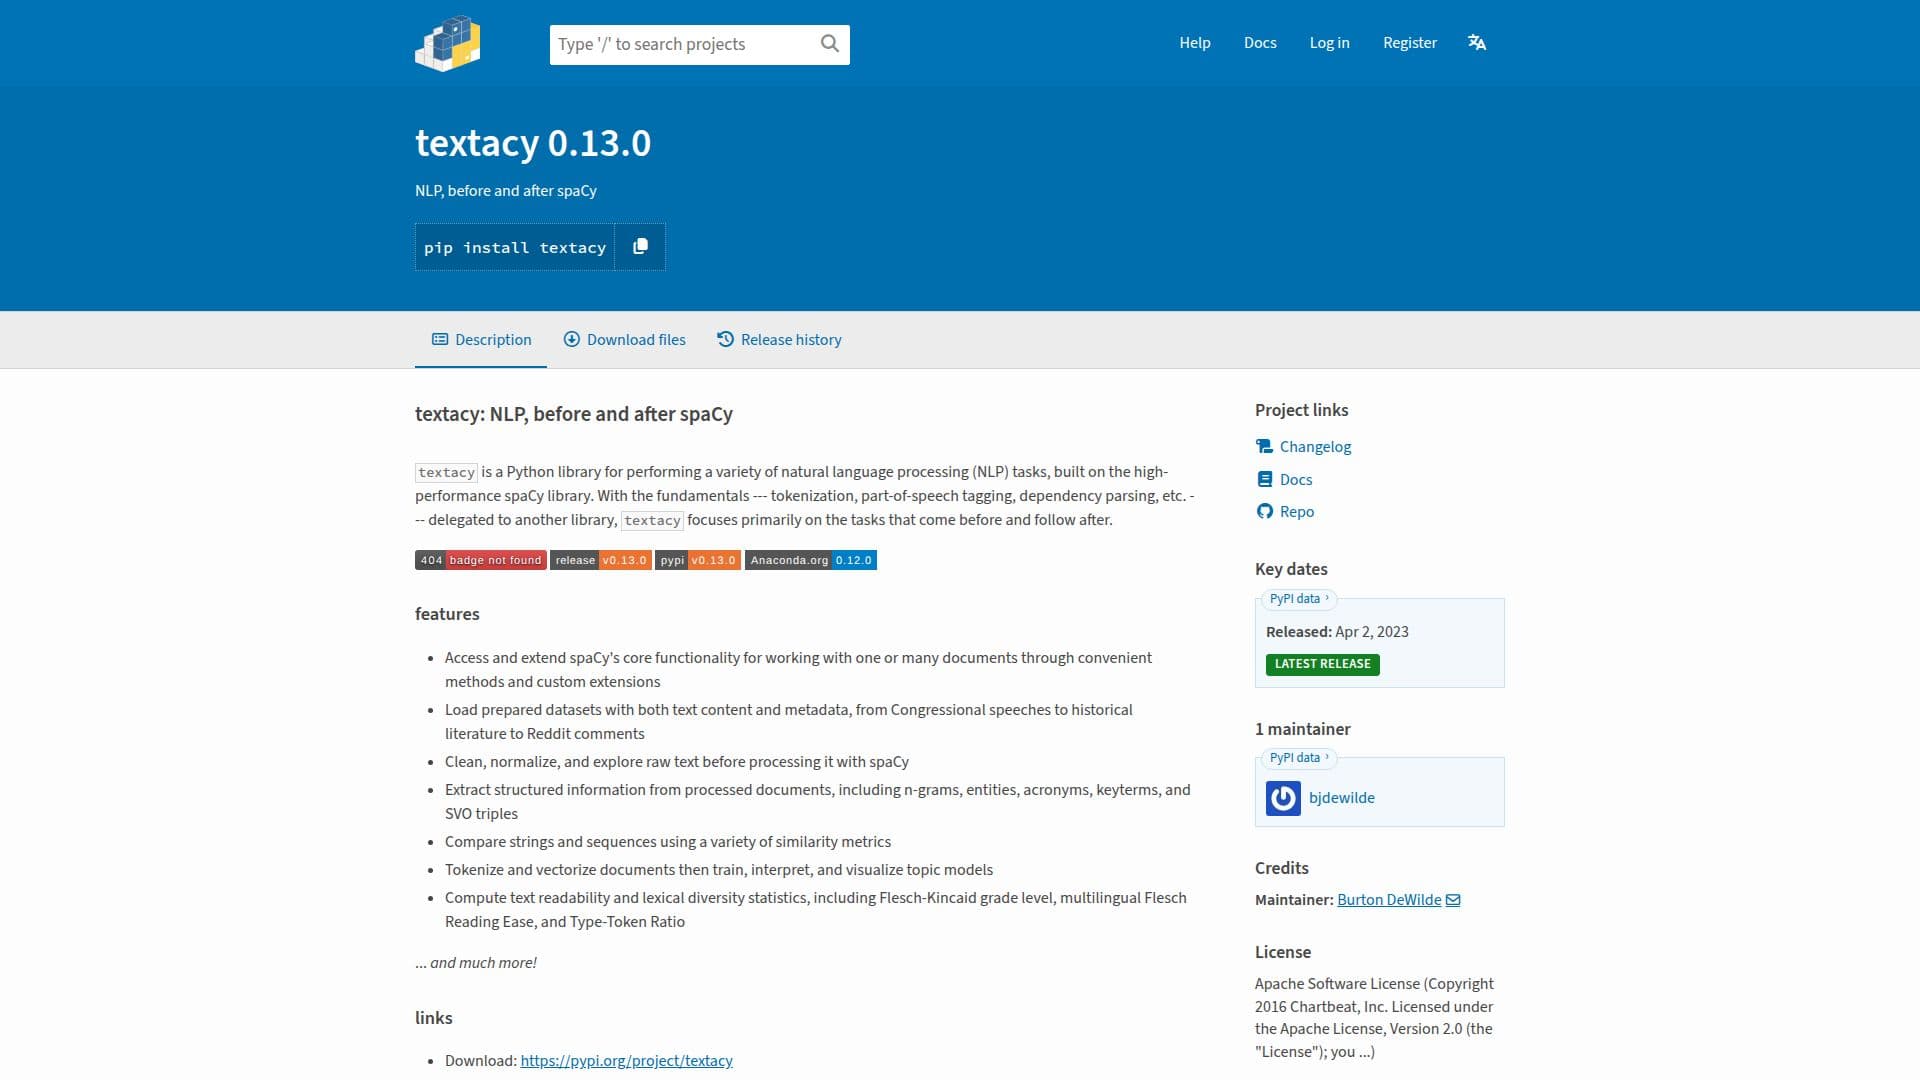
Textacyは、spaCyの機能を基にして自然言語処理(NLP)タスクを強化するために設計されたPythonライブラリです。テキストの前処理、情報抽出、言語分析のためのツールのスイートを提供し、テキストデータを扱う開発者や研究者にとって貴重なリソースとなります。Textacyは、テキストの正規化、重要な用語の抽出、テキスト統計の計算のための関数を提供します。また、文書の類似性やネットワークベースの文書表現のためのモジュールも含まれています。このライブラリは、言語識別やテキストの拡張を含むさまざまなNLPタスクをサポートし、spaCyのパイプラインとシームレスに統合されます。Textacyはオープンソースであり、PyPIで入手可能で、Pythonコミュニティにアクセス可能です。特に、複雑なテキスト処理タスクを効率的に実行したい人にとって便利です。ライブラリのモジュラー設計により、ユーザーは特定のニーズに合わせて機能をカスタマイズおよび拡張できます。Textacyの包括的なドキュメントと活発なコミュニティサポートは、その使いやすさをさらに向上させ、さまざまなユースケースのためのガイダンスや例を提供します。グラフィカルユーザーインターフェースは提供されていませんが、コマンドラインおよびプログラムインターフェースは堅牢で柔軟であり、初心者と経験者の両方に対応しています。全体として、TextacyはNLPに関与するすべての人にとって強力なツールであり、高度な機能とspaCyとの統合を提供してテキスト分析のワークフローを効率化します。
Textacy NLPライブラリの主要機能
高度なテキスト前処理
情報抽出
言語分析
文書類似性メトリクス
ネットワークベースの文書表現
言語識別
テキスト拡張
spaCyとの統合
Textacy NLPライブラリの使い方は?
インストール: pipを使用してPyPIからTextacyをインストールします
統合: Textacyをインポートし、spaCyと統合します
前処理: Textacyの関数を使用してテキストを正規化します
抽出: 重要な用語や情報のための抽出関数を適用します
Textacy NLPライブラリの使用例
- テキスト前処理
- 情報抽出
- 文書類似性
- 言語識別
- テキスト拡張