説明
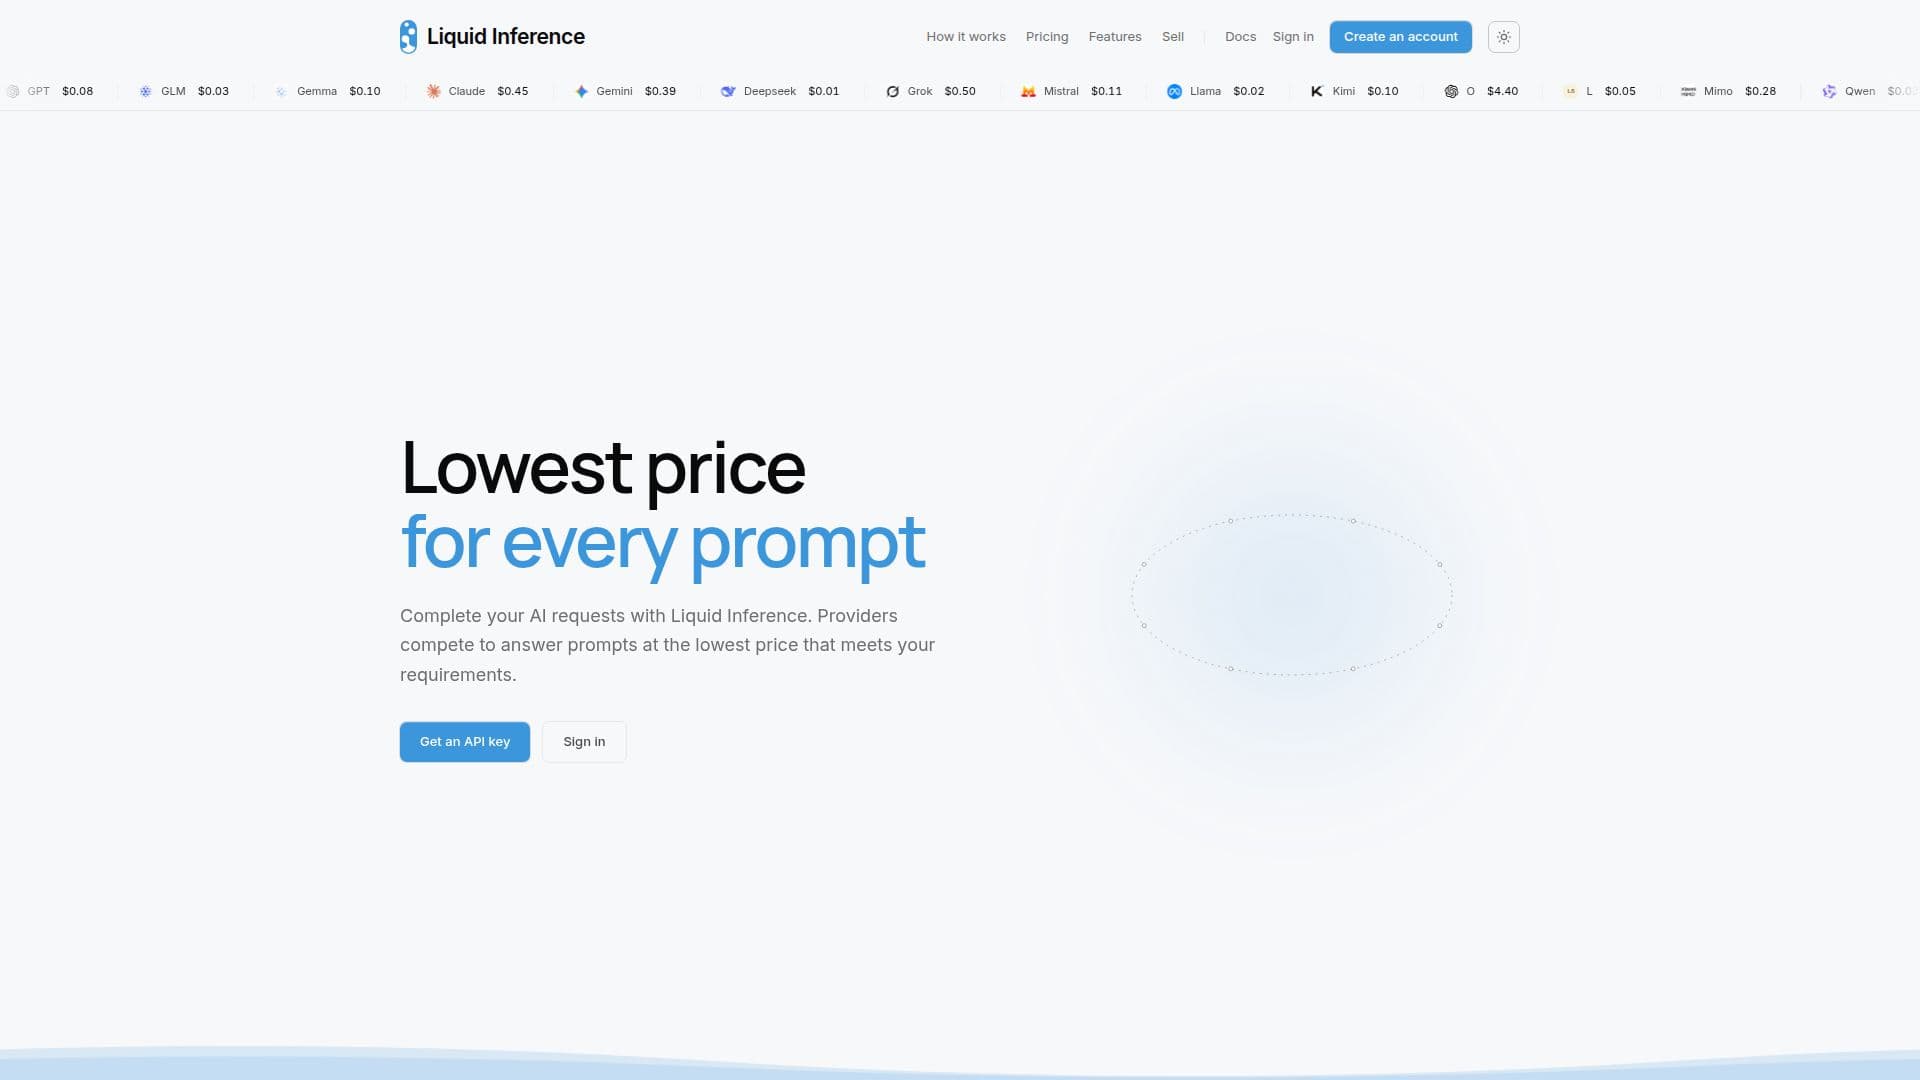
Liquid Inferenceは、プロバイダーが各プロンプトの価格で競争できるようにすることで、AIリクエストのコストを最適化するために設計されたプラットフォームです。ユーザーは、モデル、地域、速度、最小品質に関する特定のルールを設定でき、プラットフォームはこれらの基準を満たす最も安価なプロバイダーがリクエストに応答することを保証します。このアプローチにより、ユーザーはリクエストが開始される前に最大コストを把握でき、生成されたトークンに対してのみ請求されます。
続きを読む
プラットフォームには、プロバイダーが各モデルのトークンごとの価格を設定し、需給に基づいて調整できる即時オークションシステムがあります。この動的価格モデルにより、ユーザーは常に最もコスト効率の良いソリューションを受け取ることができます。Liquid Inferenceは、標準ベンチマークを使用してプロバイダーを定期的にテストし、その結果を公開することで、透明性と信頼を確保します。
Liquid Inferenceは、OpenAIやAnthropic APIなどの主要なモデルをサポートしており、ユーザーは既存のAIコーディングツールとシームレスに統合できます。プロバイダーは、自分のデプロイメントを登録し、自分の価格を設定し、キャパシティに基づいて価格を調整することで負荷を管理できます。プラットフォームは、プロバイダーではなく顧客に手数料を請求するため、既に運用しているモデルの推論を販売しようとするプロバイダーにとって魅力的な選択肢となります。
項目別請求や公開価格履歴などの機能により、ユーザーはすべてのモデルのライブおよび過去の価格をダウンロードでき、価格が低いときに作業を送信できます。Liquid Inferenceは、品質を損なうことなくAIコストを最適化しようとする企業や開発者に最適です。
- カテゴリー機械学習プラットフォーム
- 料金モデル動的
- デプロイクラウド
- プラットフォームWeb
Liquid Inferenceの主要機能
AIリクエストの競争価格
動的オークションシステム
プロバイダーのベンチマーク
OpenAIおよびAnthropic APIとの統合
項目別請求
公開価格履歴
主要AIモデルのサポート
プロバイダー制御の価格設定
Liquid Inferenceの使い方は?
アカウントを作成: プラットフォームにサインアップします
デプロイメントを登録: 提供したいモデルを提出します
オペレーターのレビュー: デプロイメントをリストに掲載します
見積もりを開始: エージェントを接続し、価格を提供し始めます
Liquid Inferenceの使用例
- コスト最適化
- 動的価格設定
- 品質保証
- シームレスな統合
- プロバイダー管理