説明
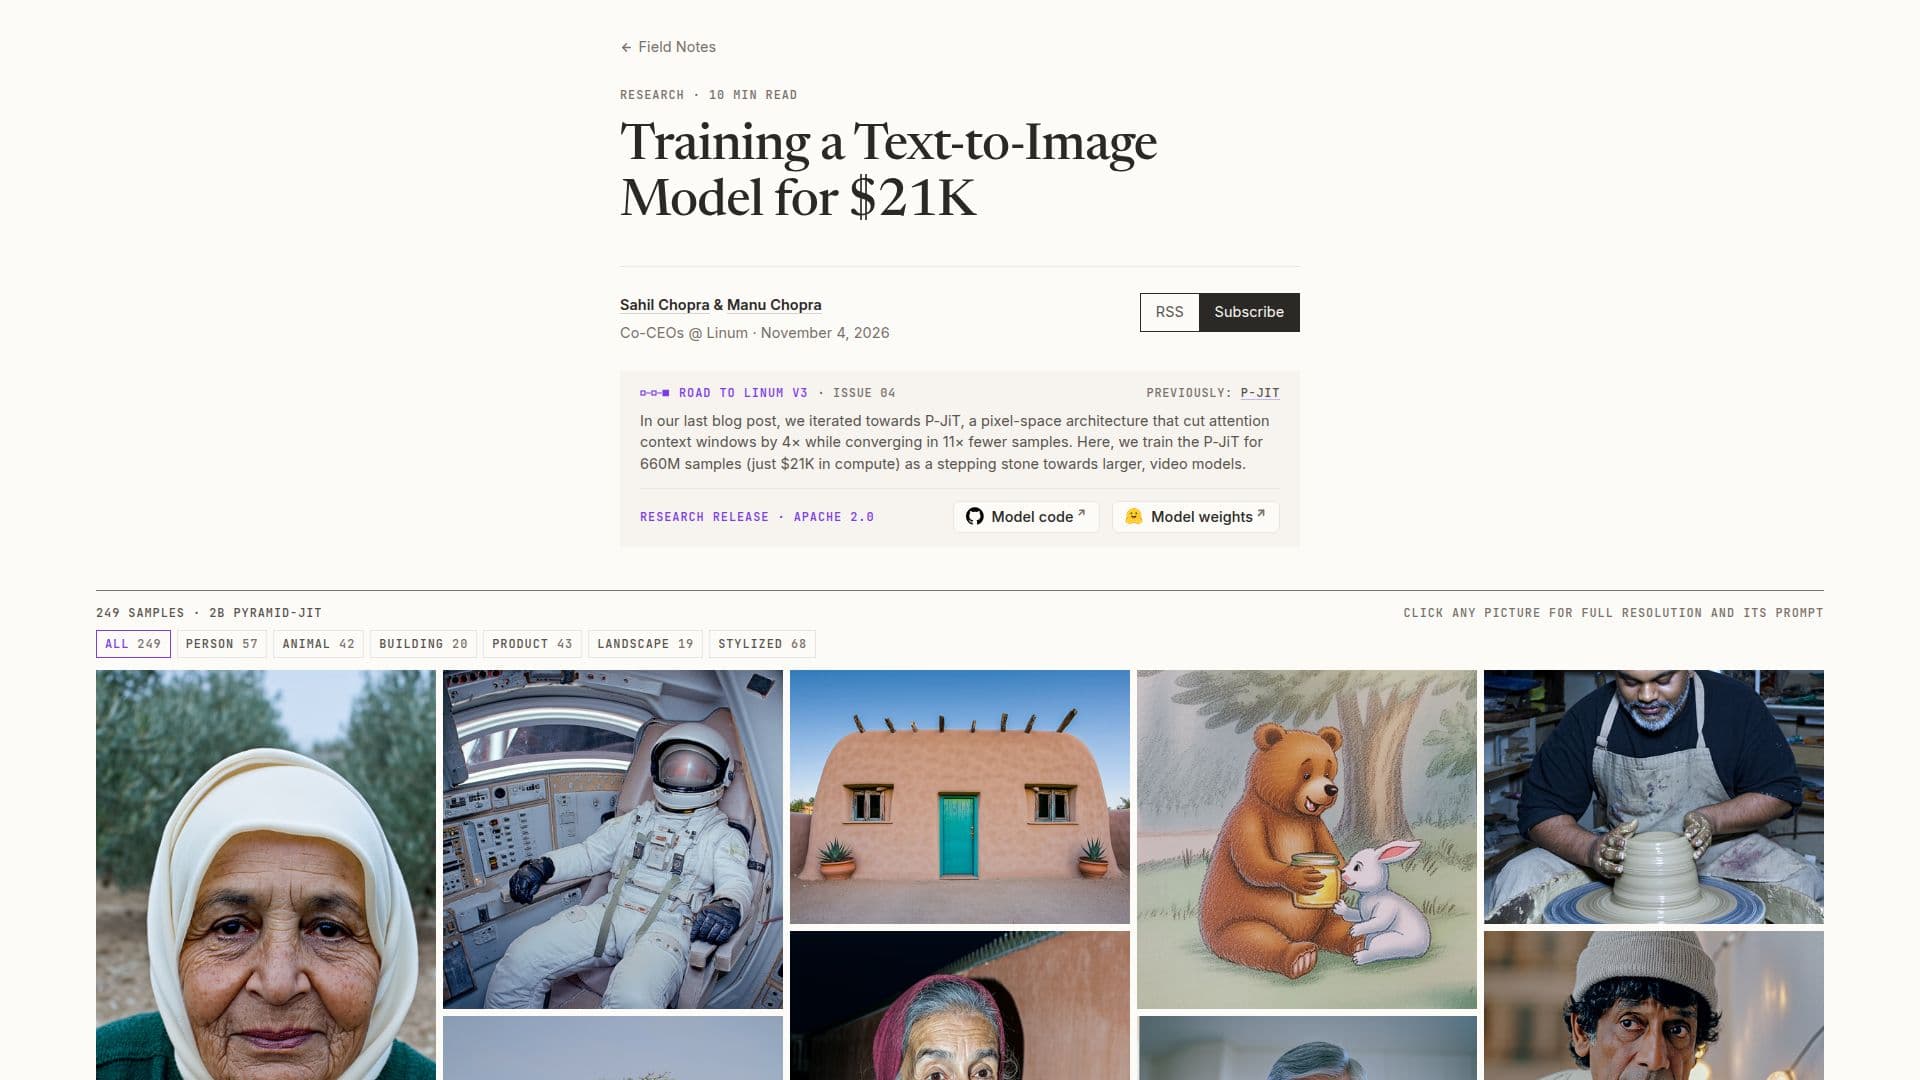
Linum P-JiTは、生成ビデオモデルのトレーニングに専念する2人の研究者による研究所Linumが開発した実験的なテキストから画像へのモデルです。この特定のモデル、2BパラメータのPyramid-JiT(P-JiT)は、コスト効率が高く制御可能な生成ツールを通じてアニメーションへのアクセスを民主化するための進行中の研究の概念実証として機能します。このモデルのトレーニングランは約21,038ドルのコストがかかり、比較的低い計算コストで高品質な結果を得る可能性を示しています。
続きを読む
P-JiTの背後にある核心的な革新は、従来の変分オートエンコーダ(VAE)を拡散モデルアーキテクチャから排除することで、より積極的な圧縮と迅速な学習を実現する能力です。代わりに、拡散モデルはその使用ケースに特化した潜在空間を学習し、より大きな圧縮と改善された生成を可能にします。このピクセル空間モデルは、Linum v2よりも11倍少ないサンプルで収束し、256x256画像に以前使用されていたのと同じトークン数で512x512画像を表現する4倍のトークン削減を提供します。これは、注意コンテキストウィンドウの4分の1の削減に相当し、トレーニングと推論コストを大幅に削減します。
P-JiTアーキテクチャは、テキストと画像処理パイプラインを組み込み、各モダリティが単一モダリティの「リファイナ」DiTブロックを通過した後、22の同一のDiTブロックのストリームに統合されます。テキスト表現は、凍結されたQwen3.5-4Bモデルから導出され、画像は32x32のパッチに分割され、1024次元の空間に圧縮されます。このモデルは、DINOv3-Lに整列したPixelREPAリードアウトを特徴とし、最終画像の低解像度バージョンを予測することで収束を加速します。
トレーニングは、610百万サンプルの512x512解像度から始まり、次に50百万サンプルの1024x1024解像度に移行する複数の段階で実施されました。ノイズスケジュールに沿ったカリキュラムが採用され、最初は高ノイズに集中して基本構造を学び、その後、詳細な部分のために分布を広げました。トレーニング後は、JEV-Imageと人間の判断者を用いた有限差分フロー最適化(FDFO)の変種が使用されました。モデルは有望な結果を示していますが、特に全身生成、複数のエンティティ、複数人の相互作用、世界知識に関して制限があります。これは、同サイズのモデルに共通の問題です。また、レンダリングされたテキストの画像でトレーニングされていないため、テキストやポスターを生成することはできません。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド
- プラットフォームWeb
Linum P-JiTの主要機能
Pyramid-JiT(P-JiT)アーキテクチャ:効率的な生成のための新しいピクセル空間モデル
2BパラメータDiT:コアの拡散トランスフォーマーモデルサイズ
4Bテキストエンコーダー:テキスト表現のために凍結されたQwen3.5-4Bモデルを利用
VAEフリー設計:より積極的な圧縮と迅速な学習のためにVAEを排除
4倍のトークン削減:Linum v2よりも4倍少ないトークンで512x512画像を表現
11倍の迅速な収束:大幅に少ないトレーニングサンプルで結果を達成
マルチステージトレーニング:512x512から1024x1024解像度に進行
カリキュラムノイズスケジュール:構造と詳細学習のためにノイズ分布を適応
PixelREPAリードアウト:改善された詳細学習のために潜在空間をDINOv3-Lに整列
線形リードアウトヘッド:収束を加速するために四分の一および半解像度でクリーンな画像を予測
有限差分フロー最適化(FDFO):トレーニング後の洗練に利用
Apache 2.0ライセンス:重みはオープンソースライセンスの下で公開
コスト効率の良いトレーニング:約21Kドルで高品質な結果を達成
生成ビデオ研究への焦点:将来のビデオモデルへの一歩
Linum P-JiTの使い方は?
アーキテクチャを理解する:P-JiTアーキテクチャの詳細を確認し、テキストと画像処理の流れを理解します。
トレーニングレジームを調べる:マルチステージトレーニングプロセス、ノイズスケジュール、および解像度の遷移について学びます。
モデルの制限を探る:全身生成、複数のエンティティ、テキスト生成に関する現在の制限を理解します。
トレーニング設定にアクセスする:詳細なトレーニングパラメータと構成については付録Aを参照してください。
コストの内訳を確認する:トレーニング前後の計算コストの内訳を確認します。
例の失敗を分析する:モデルの失敗の例を研究し、現在の能力と改善の余地を把握します。
Linum P-JiTの使用例
- テキストから画像生成の研究
- コスト効率の良いモデルトレーニング
- 生成ビデオモデルの開発
- アーキテクチャの革新テスト
- オープンソースAI実験