説明
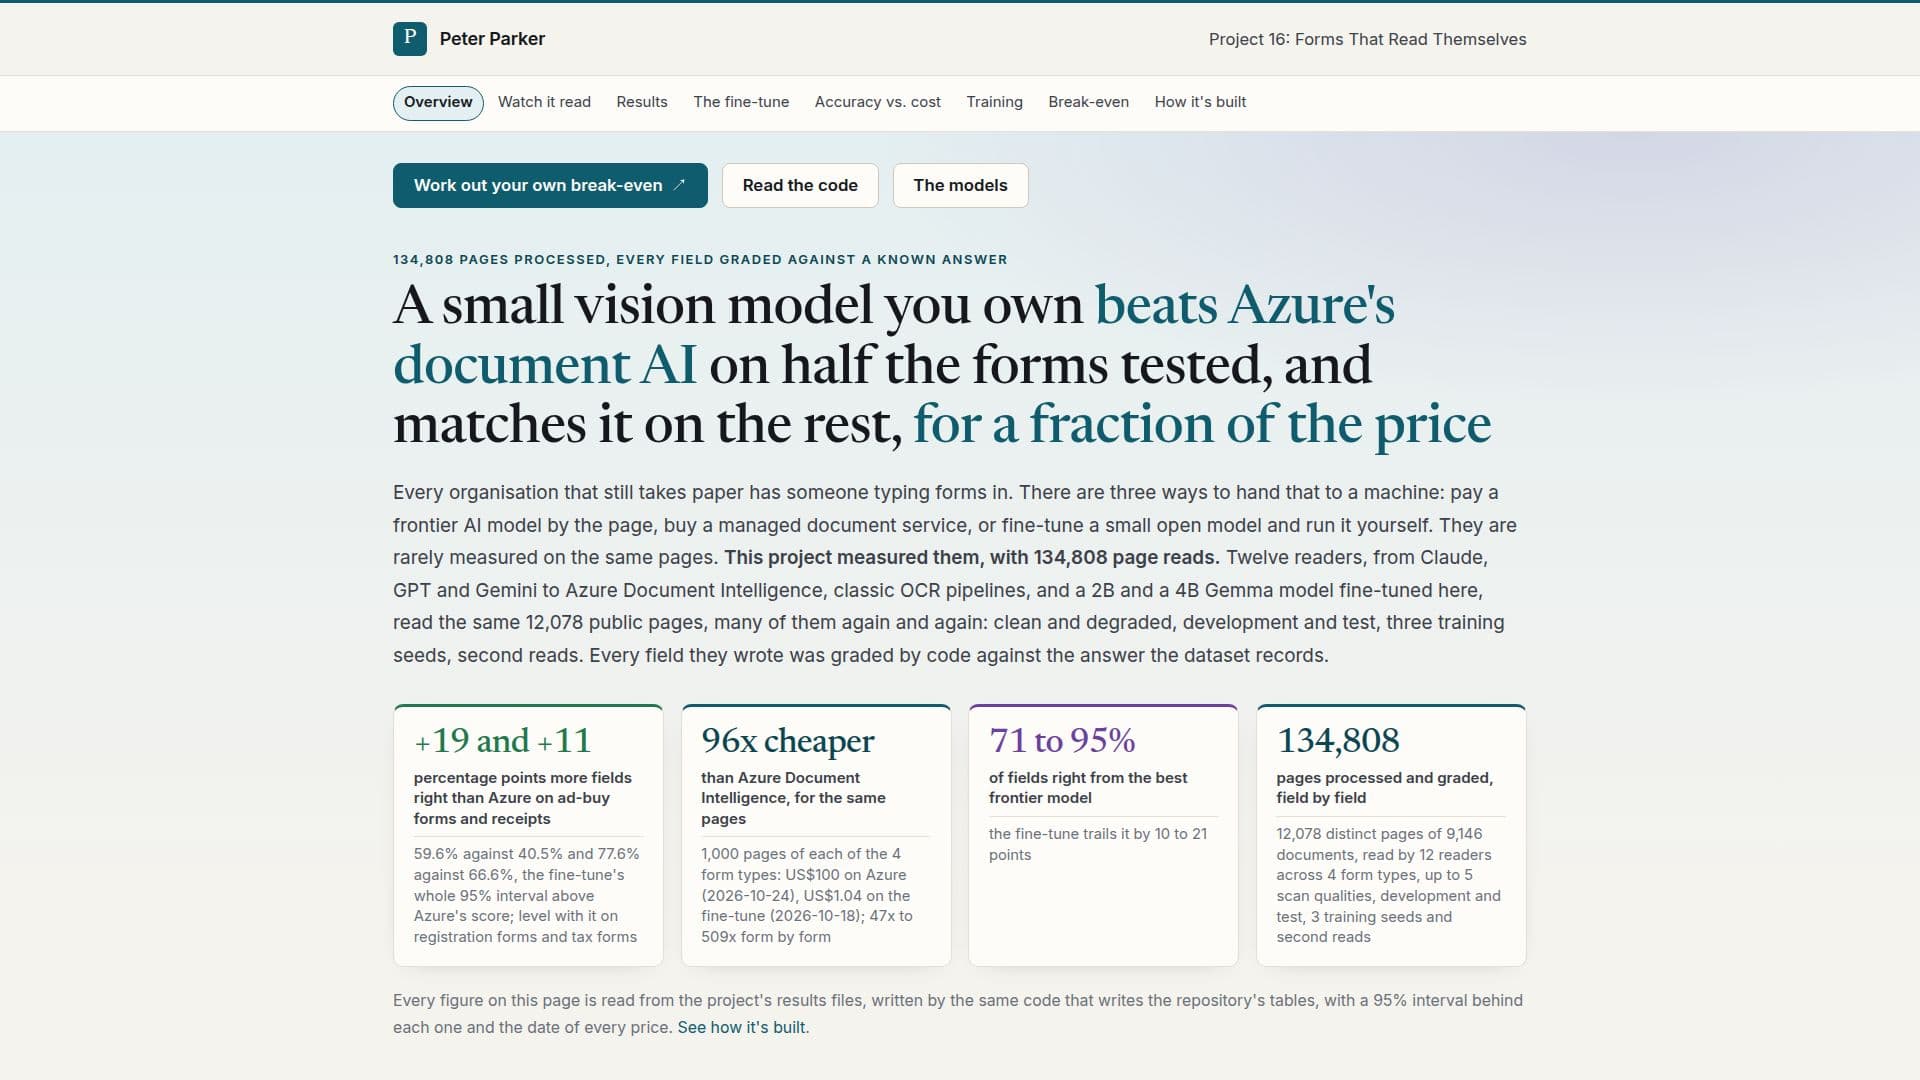
Forms That Read Themselvesは、最先端のビジョンAPIから特定の目的のために微調整されたカスタム2Bパラメータモデルまで、スキャンされたフォームのための12種類のリーダーの包括的な評価を紹介します。コアの提供物は、ユーザーが所有し運用できる小型のビジョンモデルであり、Azure Document Intelligenceのような商業ソリューションに対するコスト効果の高い代替手段を提供します。
続きを読む
このプラットフォームは、NIST Special Database 2(1988年の米国税務フォーム)、外国代理人登録法の申請、FCCの政治広告購入注文、CORD v2の領収書など、既知の回答を持つ公共データセットに基づいて、各リーダーをフィールドごとに厳密に評価します。この厳格なベンチマーキングにより、微調整されたモデルはテストされたフォームタイプの半分でAzure Document Intelligenceを上回り、残りのフォームでもそのパフォーマンスに匹敵することが明らかになりました。例えば、広告購入フォームでは、微調整されたモデルが59.6%の精度を達成し、Azureは40.5%です。また、領収書では77.6%対66.6%です。
重要な発見は、微調整が小型モデルに与える変革的な影響です。未調整のモデルであるGemma 4 E2Bは、税務フォームで15.0%の精度を示し、微調整後には73.6%に劇的に改善します。このプロセスは、レンタルGPUでわずか8分から4.9時間で完了することができ、これにより小型モデルは非常に競争力を持つようになります。微調整されたモデルは、登録フォームや領収書などの特定のフォームタイプにおいて、フロンティアモデルと比較して値の発明率が低いことも示しています。これは、空白のフィールドが自信を持っているが不正確なエントリーよりも好ましいアプリケーションにとって重要です。
GPT-6.1 SolやGemini 3.8 Flashのようなフロンティアビジョンモデルは一般的に高い精度を達成しますが、微調整されたモデルはパフォーマンスとコストのバランスが優れています。例えば、領収書では、微調整されたモデルが1,000ページあたりUS$0.16で77.6%の精度を達成し、Claude Haiku 5.5はUS$0.38で76.7%です。消費者GPU上でモデルを所有し運用することの大きな利点は、データプライバシーの向上であり、ページがユーザーのネットワークを離れる必要がないことです。
このプロジェクトは、スキャン劣化に対するビジョンモデルの堅牢性も強調しています。スキャン品質が悪いと精度が大幅に低下するOCRベースのパイプラインとは異なり、ピクセルを直接読み取るビジョンモデルは高いパフォーマンスを維持します。ただし、すべてのフィールドで99%の精度を達成したリーダーはいないため、重要なアプリケーションでは人間の検証が必要です。モデルは主にタイピングプロセスを自動化し、最終チェックは行いません。
アーキテクチャは、QLoRAを使用してオープンウェイトのGemma 4 E2BおよびE4Bモデルをトレーニングし、ベースモデルの重みを4ビットで固定し、小型アダプタマトリックスをトレーニングします。これらのアダプタは、RTX 3090 GPU上でvLLMを使用して提供され、効率的なオンプレミス展開を可能にします。サイトでは、APIコストとGPUレンタルのブレークイーブンポイントを決定するための計算機を提供しており、所有モデルの真のコストはその利用に依存することを強調しています。
- カテゴリーコンピュータービジョンツール
- 料金モデルGPU Rental Cost
- デプロイオンプレミス
- プラットフォームWeb
Forms That Read Themselvesの主要機能
スキャンされたフォーム抽出のための微調整されたビジョンモデル
最先端のビジョンAPI(GPT-6.1 Sol、Claude Sonnet、Gemini Flash)とのベンチマーキング
Azure Document Intelligenceとの比較
さまざまなフォームタイプのサポート:登録、広告購入、領収書、税務フォーム
公共データセットにおけるフィールドごとの精度評価
商業APIに対するコスト効果の高い代替手段
消費者GPU(例:RTX 3090)上でのオンプレミス展開能力
特定のフォームタイプにおける値の発明の削減
スキャン劣化(ノイズ、ぼやけ、歪み、コントラストの喪失)に対する堅牢性
正しいフィールドと1,000ページあたりのコストを含む詳細なパフォーマンス指標
微調整に使用されるオープンウェイトのベースモデル(Gemma 4 E2B、E4B)
単一GPUでの効率的なトレーニングのためのQLoRA微調整レシピ
微調整されたモデルを提供するためのvLLM
APIと所有GPUのコストブレークイーブン分析のための計算機
ページをネットワーク内に保持することによるデータプライバシー
Forms That Read Themselvesの使い方は?
リーダーを選択:さまざまなビジョンモデルまたはOCRパイプラインから選択し、そのパフォーマンスを比較します。
スキャン品質を調整:異なる劣化レベル(ノイズ、ぼやけ、歪み、コントラストの喪失)をシミュレートし、精度への影響を観察します。
フィールドごとの結果を確認:各リーダーが正しく抽出したフィールドを緑で、誤っているフィールドを赤と破線で示します。
精度とコストを分析:異なるリーダーとフォームタイプの正しいフィールドの割合と1,000ページあたりのコストを比較します。
微調整の影響を理解:微調整が特定のフォームタイプにおける小型モデルの精度を大幅に改善する様子を観察します。
展開コストを評価:提供された計算機を使用して、ボリュームに基づいてGPUをレンタルする経済的妥当性を判断します。
アダプタにアクセス:Hugging Faceから領収書、広告購入フォーム、税務フォームのための微調整されたアダプタをダウンロードします。
Forms That Read Themselvesの使用例
- 自動フォームデータ抽出
- コスト効果の高い文書処理
- オンプレミスデータ処理
- AIビジョンモデルのベンチマーキング
- OCR精度の向上
- カスタムモデルの開発