説明
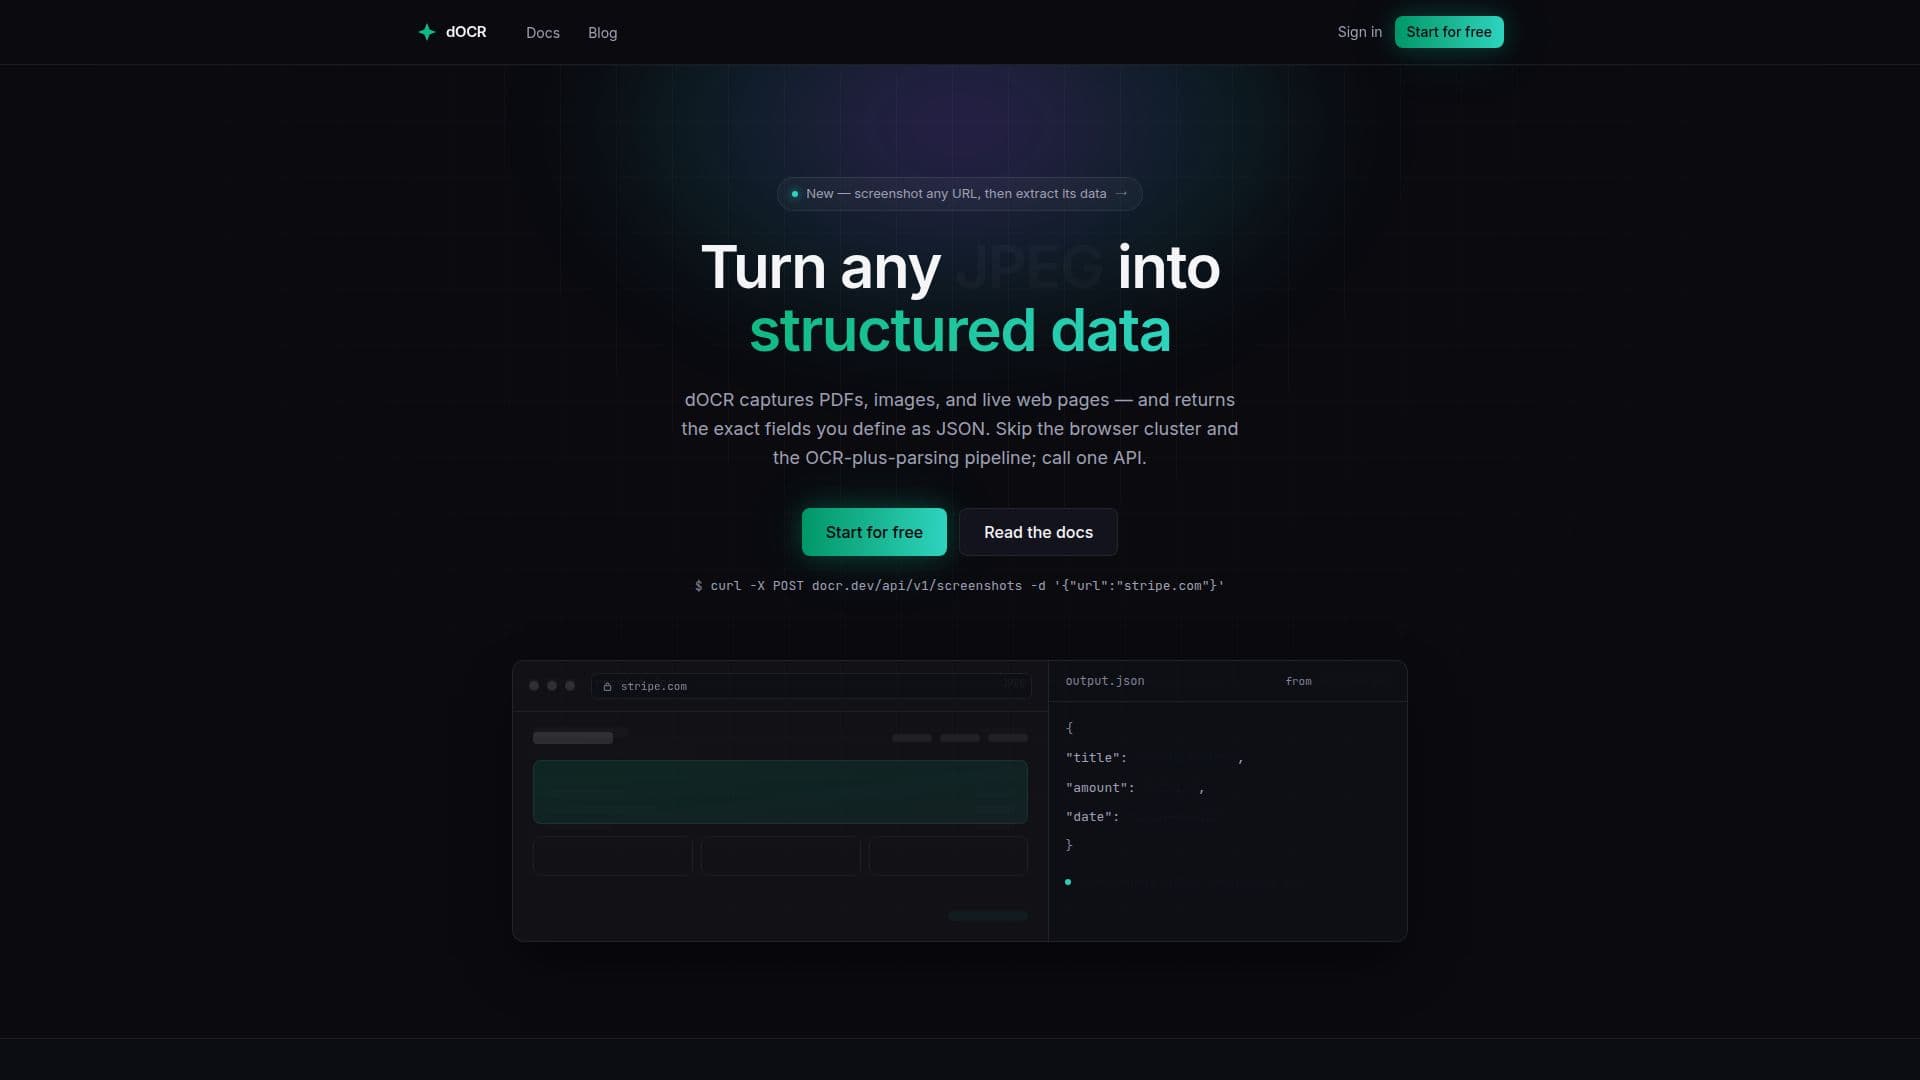
dOCRは、さまざまな文書タイプやライブウェブページを構造化されたJSONデータに変換するために設計された堅牢な文書データ抽出APIを提供します。このサービスは、ページのレンダリングや文書の解析の複雑さを処理し、クリーンなスクリーンショットと検証済みのJSONフィールドを提供します。このアプローチにより、ユーザーは従来のブラウザクラスターやOCRプラス解析パイプラインを回避し、単一のAPIコールを通じてデータ取得を簡素化できます。
続きを読む
dOCRは、PDF、画像、ライブURLなど、幅広い入力をサポートしています。ユーザーは必要なフィールドを正確に定義でき、dOCRはそれぞれを特定、検証、スコアリングし、一貫したデータ出力を保証します。これは、請求書、領収書、フォーム、IDなどのビジネス文書を処理する際や、任意のライブウェブページからデータを抽出する際に特に便利です。
主な機能には、任意のURLのスクリーンショットを取得する機能、PNG、JPEG、WebP、PDFなどのさまざまな形式にページをレンダリングする機能、全ページキャプチャや異なるデバイスビューポートのオプションが含まれています。dOCRは、広告やクッキーバナーを自動的にブロックし、データキャプチャプロセスをさらに簡素化します。このサービスはスピードを重視して設計されており、ほとんどの文書は数秒以内に処理され、マルチページPDFも含まれているため、バッチジョブではなくリアルタイムリクエストに適しています。
ユーザーはカスタム文書タイプを定義でき、必要なフィールドを一度指定することで、すべての抽出がその正確な形でデータを返すことを保証します。このプラットフォームは、テストや抽出履歴の閲覧のためのダッシュボードと、バックエンド自動化のためのAPIを提供します。この柔軟性により、開発者は最小限のインフラストラクチャオーバーヘッドでdOCRをワークフローに統合できます。
透明性はdOCRの核心的な側面であり、すべての抽出に対して詳細なログを提供します。ユーザーは、アップロードからOCR、フィールド抽出、スキーマ検証まで、各フィールドを追跡でき、信頼スコアも含まれています。この可視性により、あらゆる不一致を特定し対処することができ、データの正確性と信頼性を確保します。このサービスは、スクリーンショットと構造化データ抽出の両方をサポートする単一のAPIキーを介してアクセス可能で、始めるための無料プランも提供しています。
- カテゴリーWebスクレイピングとデータ抽出
- 料金モデルフリーミアム
- デプロイクラウド
- プラットフォームWeb
dOCRの主要機能
文書データ抽出API
文書とウェブサイトを構造化されたJSONに変換
請求書、領収書、フォーム、IDをサポート
PDF、画像、ライブウェブページをキャプチャ
ユーザー定義のフィールドをJSONとして返す
ウェブページのクリーンなスクリーンショットを提供
抽出されたJSONフィールドを検証しスコアリング
ページをPNG、JPEG、WebP、PDFにレンダリング
ウェブキャプチャ中に広告とクッキーバナーをブロック
迅速な処理、通常は数秒以内
マルチページPDF処理をサポート
カスタム文書タイプの定義を許可
テストと履歴のためのダッシュボードを提供
信頼スコア付きの詳細な抽出ログを提供
すべての機能に対する単一のAPIキー
dOCRの使い方は?
アカウントを作成: docr.devにサインアップしてAPIキーを取得します。
文書タイプを定義: 文書タイプに対して抽出したいJSONフィールドを指定します。
文書またはURLを送信: APIを使用して文書(PDF、画像、DOCX)またはライブURLを送信します。
構造化データを受け取る: 定義されたフィールドを検証済みのJSONとして信頼スコアと共に受け取ります。
抽出を確認: ダッシュボードで抽出履歴とログを監視し、透明性を確保します。
dOCRの使用例
- 請求書処理の自動化
- 領収書データキャプチャ
- フォームデータ抽出
- ウェブページデータスクレイピング
- メタデータ付き文書アーカイブ
- リアルタイムデータ処理
- 自動レポート作成
- コンプライアンスと監査トレイル