説明
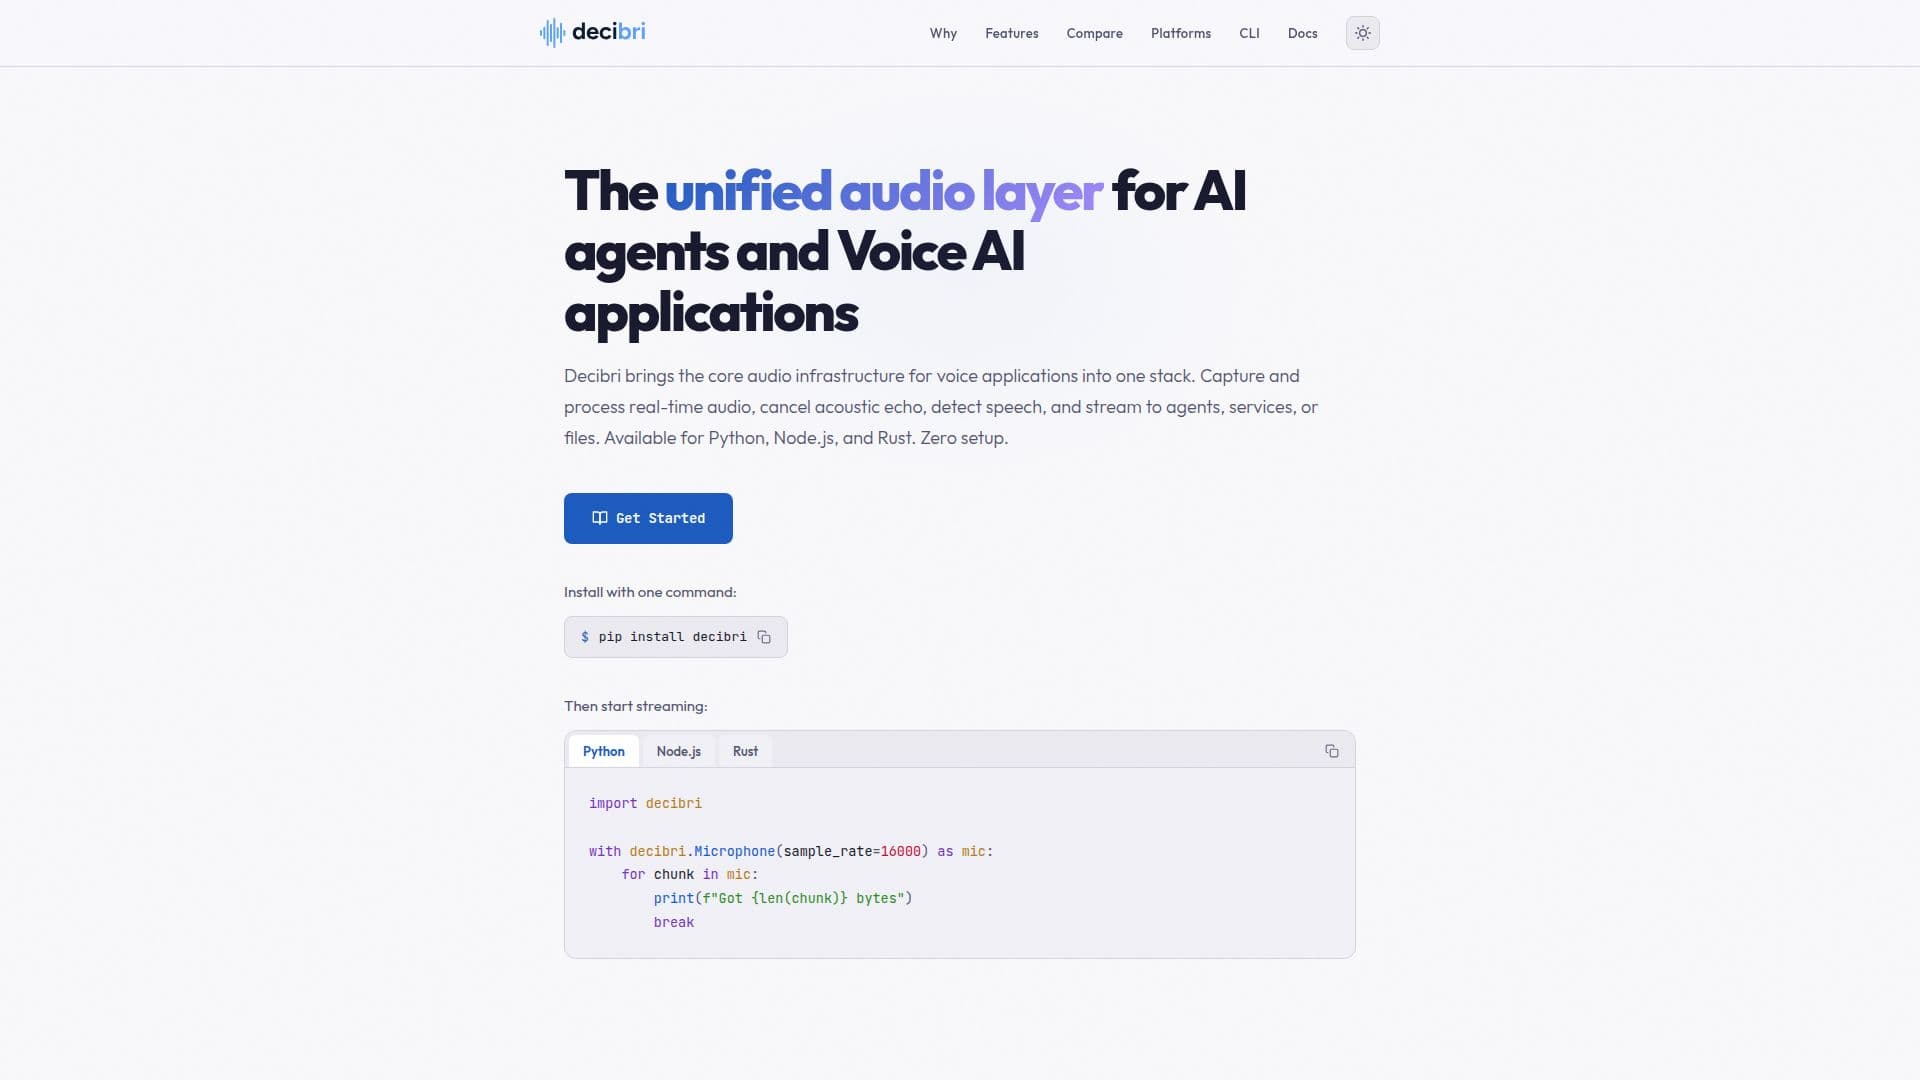
Decibriは、AIエージェントおよび音声AIアプリケーションのために特別に設計された統合オーディオレイヤーです。マイクキャプチャ、スピーカー出力、音声活動検出(VAD)を含む、重要なリアルタイムオーディオ機能を提供します。このプラットフォームは、Python、Node.js、Rustなどの複数のプログラミング言語をサポートしており、さまざまな開発環境に対応しています。
続きを読む
Decibriの主な利点の一つは、インストールの容易さとクロスプラットフォーム互換性です。すべてのサポートプラットフォーム(Windows、macOS、Linux)向けにPythonおよびNode.js用の事前ビルドバイナリを提供し、コンパイルや複雑なビルドツールの必要性を排除します。この「ゼロセットアップ」アプローチにより、開発者はリアルタイムオーディオ機能を迅速にプロジェクトに統合できます。Python、Node.js、Rustパッケージを支えるRustコアは、ネイティブコードにコンパイルされ、オペレーティングシステムのオーディオレイヤーから直接、予測可能な低遅延オーディオを提供します。
Decibriは、OSオーディオレイヤーから直接オーディオをキャプチャし、デフォルトで16ビット符号付き整数PCM形式で100msのオーディオチャンクを提供します。これは、Vosk、sherpa-onnx、whisper.cppなどのほとんどの音声およびウェイクワードエンジンが期待する標準形式です。32ビット浮動小数点形式も利用可能です。各言語のストリームネイティブなイディオムをサポートしており、開発者はオーディオをファイル、WebSocket、または音声エージェントに効率的にパイプできます。このプラットフォームには、騒がしい環境での正確な音声検出のために、ローカルでONNX Runtimeを介して実行されるバンドルされたSilero VAD v6.2モデルも含まれています。
基本的なキャプチャと再生を超えて、Decibriはオーディオキャプチャエンジン(ACE)を通じて、DC除去、ノイズ除去、高域通過フィルタリング、自動ゲイン制御、リミティングなどの高度なオーディオ処理機能を提供します。また、マイクキャプチャからスピーカー音を除去するための音響エコーキャンセリング(AEC)も提供しています。オフライン処理のために、オーディオファイルプロセッサ(AFP)は、録音されたサンプルやメモリ内サンプルの条件付けを可能にします。Decibriは、クラウドベース(AssemblyAI、AWS Transcribe、Azure AI Speech、Deepgram、Google Cloud Speech-to-Text、Mistral Voxtral、OpenAI Realtime API)およびローカル(Sherpa-ONNX、Whisper.cpp)の多数の音声認識(STT)プロバイダーと統合されており、Kokoroモデルを使用したローカルのテキスト読み上げ(TTS)や、Sherpa-ONNXを使用したキーワードスポッティング(KWS)とも統合されています。
Decibriはリアルタイムシステム向けに構築されており、外部オーディオツールやプラットフォーム固有の処理なしで低遅延オーディオI/Oを保証します。Pythonでは`asyncio`を使用した非同期操作をサポートし、Node.jsおよびブラウザ環境の両方で単一のパッケージから動作します。`decibri-cli`ツールは、オーディオキャプチャ、再生、デバイス列挙のためのコマンドライン機能を提供し、スクリプトやCI/CDパイプラインのためのユーティリティをさらに拡張します。
- カテゴリーAI エージェントビルダー
- 料金モデル無料
- デプロイローカル
- プラットフォームWindows, macOS, Linux, Browser
Decibriの主要機能
リアルタイムマイクキャプチャ
スピーカー出力と再生
音声活動検出(VAD)
クロスプラットフォームサポート(Python、Node.js、Rust)
ゼロセットアップのための事前ビルドバイナリ
直接OSオーディオレイヤーアクセス
16ビットPCMおよび32ビット浮動小数点オーディオ出力
非同期APIサポート(Python用asyncio)
ブラウザ互換性(Node.jsパッケージ)
オーディオキャプチャエンジン(DC除去、ノイズ除去、AGC)
音響エコーキャンセリング(AEC)
ローカルML音声検出(Silero VAD)
クラウドSTTサービスとの統合
ローカルSTT/TTS/KWSモデルとの統合
コマンドラインインターフェース(decibri-cli)
Decibriの使い方は?
Decibriをインストール: Pythonの場合は`pip install decibri`、Node.jsの場合は`npm install decibri`を使用して事前ビルドバイナリを取得します。
マイクを開く: Pythonでは`decibri.Microphone.open()`、Node.jsでは`new Microphone()`を利用してオーディオキャプチャを開始します。
オーディオをストリーム: Pythonイテレータ、Node.jsのReadableストリーム、またはRustチャネルを使用してオーディオチャンクを読み取ります。
オーディオを処理: DC除去、ノイズ除去、音響エコーキャンセリングなどの組み込み条件付けを適用します。
音声を検出: バンドルされたSilero VADモデルを有効にしてローカル音声活動検出を行います。
AIサービスと統合: 生のPCMオーディオを音声認識サービス、音声エージェント、または他のAIモデルにパイプします。
オーディオを再生: DecibriのスピーカーAPIを使用してシステムスピーカーからオーディオを再生します。
ファイルに録音: 簡単なオーディオ録音のために`record_to_file()`を使用するか、高度な使用ケースのために完全なストリーミング制御を行います。
Decibriの使用例
- リアルタイム音声AIエージェント
- 音声認識統合
- 音声活動検出
- ASR用オーディオ録音
- クロスプラットフォームオーディオアプリケーション
- サーバーサイド音声バックエンド
- キーワードスポッティング
- フルデュプレックスオーディオ通信