Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

WeVisOne-VL

LLMModel AI & LLMGratis · Web

WeVisOne-VL adalah model visi-bahasa terpadu dari WeChat Vision milik Tencent. Model ini mengintegrasikan persepsi tingkat objek dan piksel untuk tugas seperti deteksi objek dan pemadatan gambar, menggunakan dekoder piksel ringan.

Kunjungi URL
Bagikan
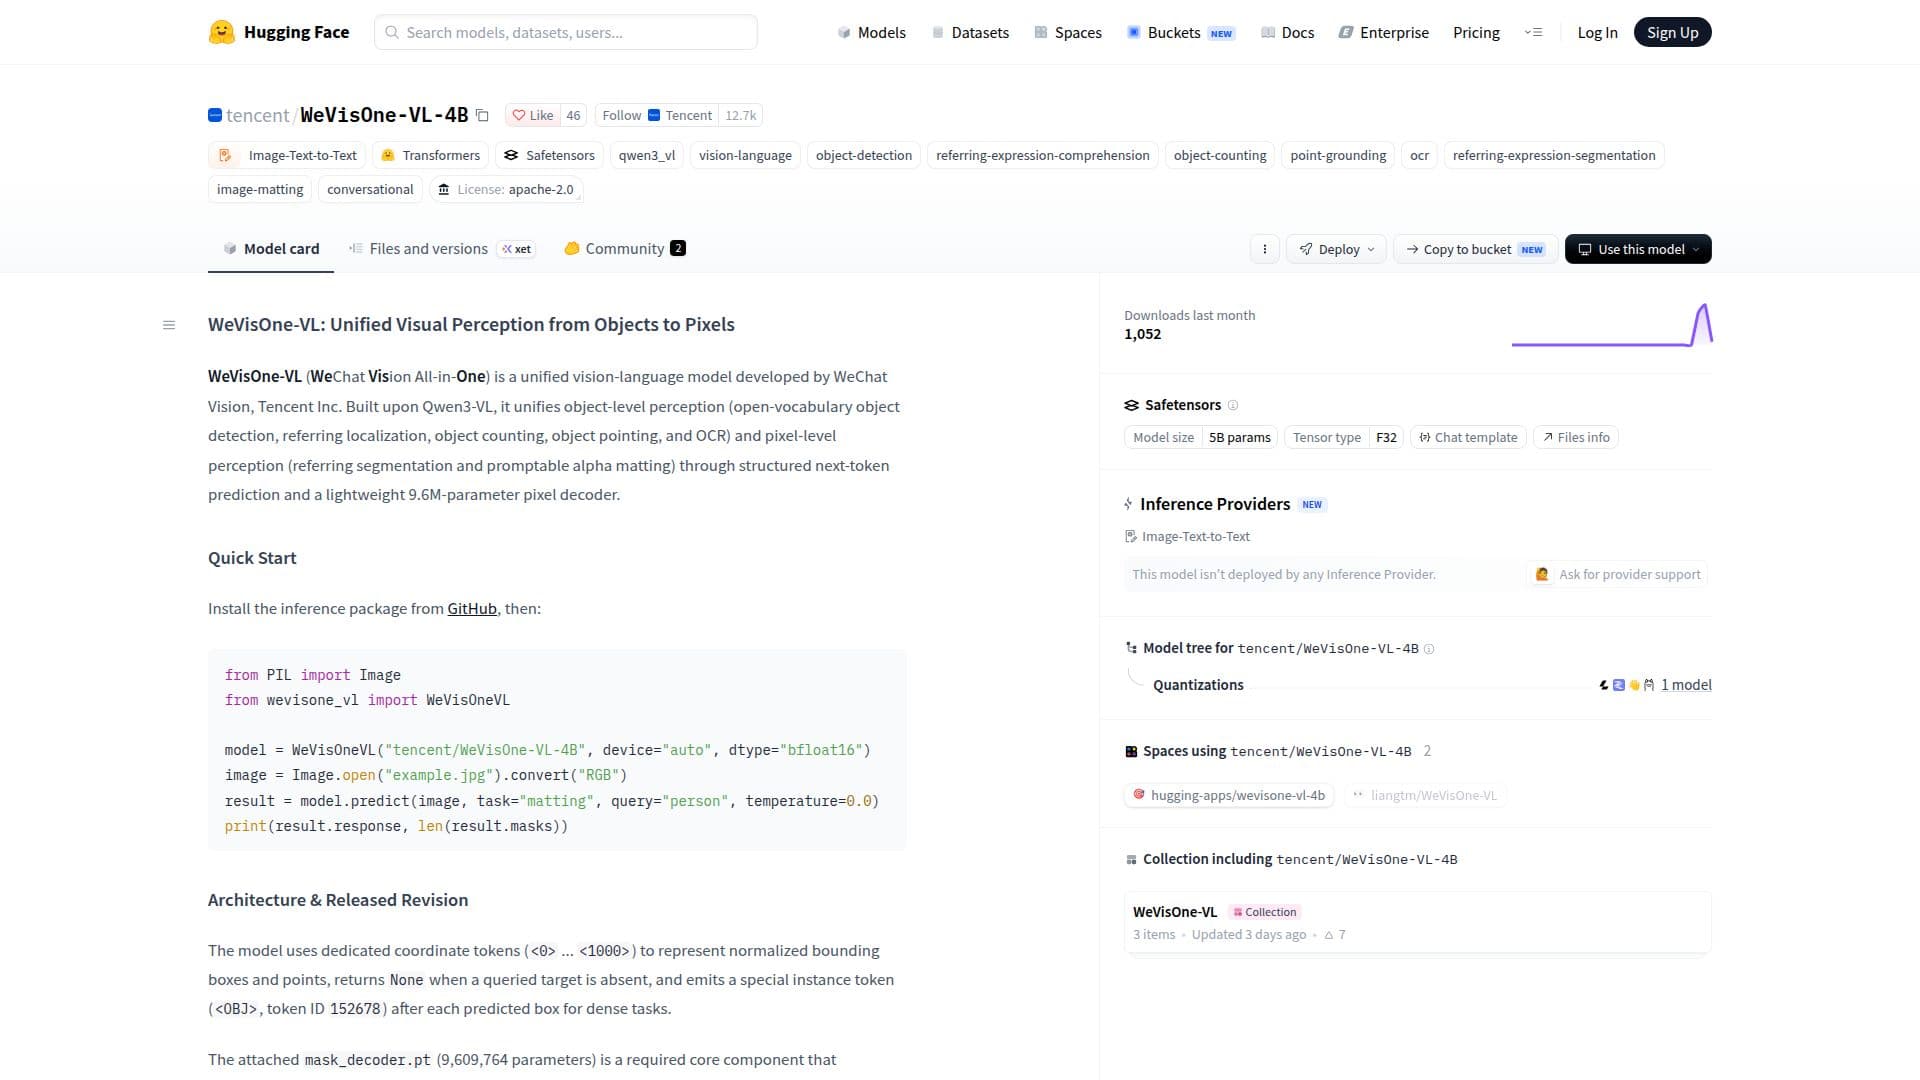
Tangkapan layar WeVisOne-VL

WeVisOne-VL adalah model visi-bahasa yang dikembangkan oleh WeChat Vision, bagian dari Tencent Inc. Model ini dirancang untuk menyatukan tugas persepsi tingkat objek dan piksel. Dibangun di atas kerangka kerja Qwen3-VL, WeVisOne-VL mendukung berbagai tugas visual termasuk deteksi objek dengan kosakata terbuka, lokalisasi referensi, penghitungan objek, penunjukan objek, dan pengenalan karakter optik (OCR). Selain itu, model ini menangani tugas tingkat piksel seperti segmentasi referensi dan pemadatan alpha yang dapat diprompt. Model ini menggunakan prediksi token berikutnya yang terstruktur dan memiliki dekoder piksel dengan 9,6 juta parameter.

Baca Selengkapnya

Arsitektur WeVisOne-VL mencakup token koordinat khusus untuk merepresentasikan kotak pembatas dan titik yang dinormalisasi. Model ini menggunakan token instance khusus untuk tugas padat dan mengintegrasikan dekoder masker sebagai komponen inti. Dekoder ini menggabungkan Visual Feature Adapter, Box-Guided Query Decoder, dan Instance-Conditioned Dense Prediction Head untuk memperbaiki prediksi dan menghasilkan matte alpha resolusi penuh.

WeVisOne-VL ditujukan untuk tujuan penelitian dalam penguatan visual, lokalisasi referensi, penunjukan, penghitungan, lokalisasi OCR, segmentasi referensi, dan pemadatan gambar. Model ini tidak dirancang untuk pengambilan keputusan otonom yang berdampak tinggi atau identifikasi individu. Model ini efisien dalam menghasilkan keluaran terstruktur tetapi tidak mendukung penalaran rantai-pikir eksplisit dan saat ini terbatas pada persepsi gambar satu putaran.

Model ini dirilis di bawah Lisensi Apache 2.0, dengan komponen pihak ketiga mempertahankan lisensi aslinya. Model ini telah diunduh lebih dari 1.000 kali dalam sebulan terakhir, menunjukkan popularitasnya yang semakin meningkat di komunitas penelitian.

  • KategoriModel AI & LLM
  • Model HargaGratis
  • PenerapanCloud
  • PlatformWeb

  • Model visi-bahasa terpadu

  • Persepsi tingkat objek

  • Persepsi tingkat piksel

  • Dekoder piksel dengan 9,6 juta parameter

  • Prediksi token berikutnya yang terstruktur

  • Token koordinat khusus

  • Token instance khusus untuk tugas padat

  • Lisensi Apache 2.0

  1. Akses halaman model: Kunjungi halaman Hugging Face untuk WeVisOne-VL

  2. Autentikasi: Pastikan Anda memiliki izin yang diperlukan untuk mengakses model

  3. Konfigurasi: Atur parameter model sesuai kebutuhan penelitian Anda

  4. Kirim prompt: Masukkan tugas visual Anda untuk diproses

  5. Fine-tune: Sesuaikan model untuk tugas tertentu jika diperlukan

  • Deteksi Objek
  • Lokalisasi Referensi
  • Penghitungan Objek
  • Lokalisasi OCR
  • Pemadatan Gambar

Alat AI Populer Seperti WeVisOne-VL

WeVisOne-VL adalah model visi-bahasa terpadu yang dikembangkan oleh WeChat Vision, Tencent Inc. Model ini mengintegrasikan persepsi tingkat objek dan tingkat piksel untuk tugas…

Alat Computer Vision
Lihat Alat

Model visi-bahasa terpadu yang dikembangkan oleh WeChat Vision, Tencent Inc. Model ini mengintegrasikan persepsi tingkat objek dan tingkat piksel untuk tugas…WeVisOne-VL adalah model visi-bahasa terpadu yang dikembangkan oleh WeChat Vision, Tencent Inc. Model ini mengintegrasikan persepsi tingkat objek dan tingkat piksel untuk tugas…

Alat Computer Vision
Lihat Top 50 LLM

Qwen2-VL-7B-Instruct adalah model AI canggih yang dirancang untuk pemahaman visual dan dukungan multibahasa. Model ini unggul dalam memproses gambar dan video, menawarkan kinerja…

Alat Computer Vision
Lihat Alat

Model AI canggih yang dirancang untuk pemahaman visual dan dukungan multibahasa. Model ini unggul dalam memproses gambar dan video, menawarkan kinerja…Qwen2-VL-7B-Instruct adalah model AI canggih yang dirancang untuk pemahaman visual dan dukungan multibahasa. Model ini unggul dalam memproses gambar dan video, menawarkan kinerja…

Alat Computer Vision
Lihat Top 5 Model AI

Qwen-VL

Repositori GitHub AI

Qwen-VL adalah model bahasa visi besar yang dikembangkan oleh Alibaba Cloud. Ini menawarkan kemampuan canggih untuk tugas percakapan dan visi, menyediakan platform yang kuat untuk…

Model AI & LLM
Lihat Alat

Repositori GitHub AI

Model bahasa visi besar yang dikembangkan oleh Alibaba Cloud. Ini menawarkan kemampuan canggih untuk tugas percakapan dan visi, menyediakan platform yang kuat untuk…Qwen-VL adalah model bahasa visi besar yang dikembangkan oleh Alibaba Cloud. Ini menawarkan kemampuan canggih untuk tugas percakapan dan visi, menyediakan platform yang kuat untuk…

Model AI & LLM
Lihat Top 250 Repositori GitHub AI

Computer Vision Toolbox menyediakan algoritma dan aplikasi untuk merancang dan menguji sistem visi komputer, termasuk inspeksi visual, deteksi objek, dan pencocokan fitur. Ini…

Alat Computer Vision
Lihat Alat

Menyediakan algoritma dan aplikasi untuk merancang dan menguji sistem visi komputer, termasuk inspeksi visual, deteksi objek, dan pencocokan fitur. Ini…Computer Vision Toolbox menyediakan algoritma dan aplikasi untuk merancang dan menguji sistem visi komputer, termasuk inspeksi visual, deteksi objek, dan pencocokan fitur. Ini…

Alat Computer Vision
Lihat Top 250 Aplikasi AI

Qwen2-VL-72B-Instruct adalah model AI canggih yang dirancang untuk pemahaman visual mutakhir dan dukungan multibahasa. Model ini unggul dalam memproses gambar, video, dan tugas…

Model AI & LLM
Lihat Alat

Model AI canggih yang dirancang untuk pemahaman visual mutakhir dan dukungan multibahasa. Model ini unggul dalam memproses gambar, video, dan tugas…Qwen2-VL-72B-Instruct adalah model AI canggih yang dirancang untuk pemahaman visual mutakhir dan dukungan multibahasa. Model ini unggul dalam memproses gambar, video, dan tugas…

Model AI & LLM
Lihat Top 5 Model AI

Ultralytics YOLO

Repositori GitHub AI

Ultralytics YOLO mencakup YOLO26, YOLO11, dan YOLOv8, menyediakan kemampuan untuk deteksi objek, segmentasi instance, segmentasi semantik, klasifikasi gambar, estimasi pose, dan…

Alat Computer Vision

Peringkat 19 di Repositori GitHub AI

Lihat Alat

Repositori GitHub AI

Ultralytics YOLO mencakup YOLO26, YOLO11, dan YOLOv8, menyediakan kemampuan untuk deteksi objek, segmentasi instance, segmentasi semantik, klasifikasi gambar, estimasi pose, dan…

UnggulanAlat Computer Vision
Peringkat 19 di Repositori GitHub AI

Model clip-vit-base-patch32 oleh OpenAI dirancang untuk tugas klasifikasi gambar tanpa pelatihan sebelumnya. Model ini memanfaatkan arsitektur Vision Transformer untuk…

Alat Computer Vision
Lihat Alat

Model clip-vit-base-patch32 oleh OpenAI dirancang untuk tugas klasifikasi gambar tanpa pelatihan sebelumnya. Model ini memanfaatkan arsitektur Vision Transformer untuk…

UnggulanAlat Computer Vision
Lihat Top 5 Model AI

Ultralytics

Aplikasi AI

Platform visi komputer end-to-end untuk memberi anotasi data, melatih model YOLO, dan menyebarkannya secara global, dibangun di sekitar kerangka kerja open-source Ultralytics YOLO…

Alat Computer VisionManufaktur & Industri

Peringkat 5 di Manufaktur & Industri

Lihat Alat

Aplikasi AI

Platform visi komputer end-to-end untuk memberi anotasi data, melatih model YOLO, dan menyebarkannya secara global, dibangun di sekitar kerangka kerja open-source Ultralytics YOLO…

UnggulanAlat Computer VisionManufaktur & Industri
Peringkat 5 di Manufaktur & Industri
1 dari 8