Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

WeVisOne-VL

WeVisOne-VL est un modèle unifié de vision-langage développé par WeChat Vision de Tencent. Il intègre la perception au niveau des objets et des pixels pour des tâches telles que la détection d'objets et le matting d'images, en utilisant un décodeur de pixels léger.

Visiter l'URL
Partager
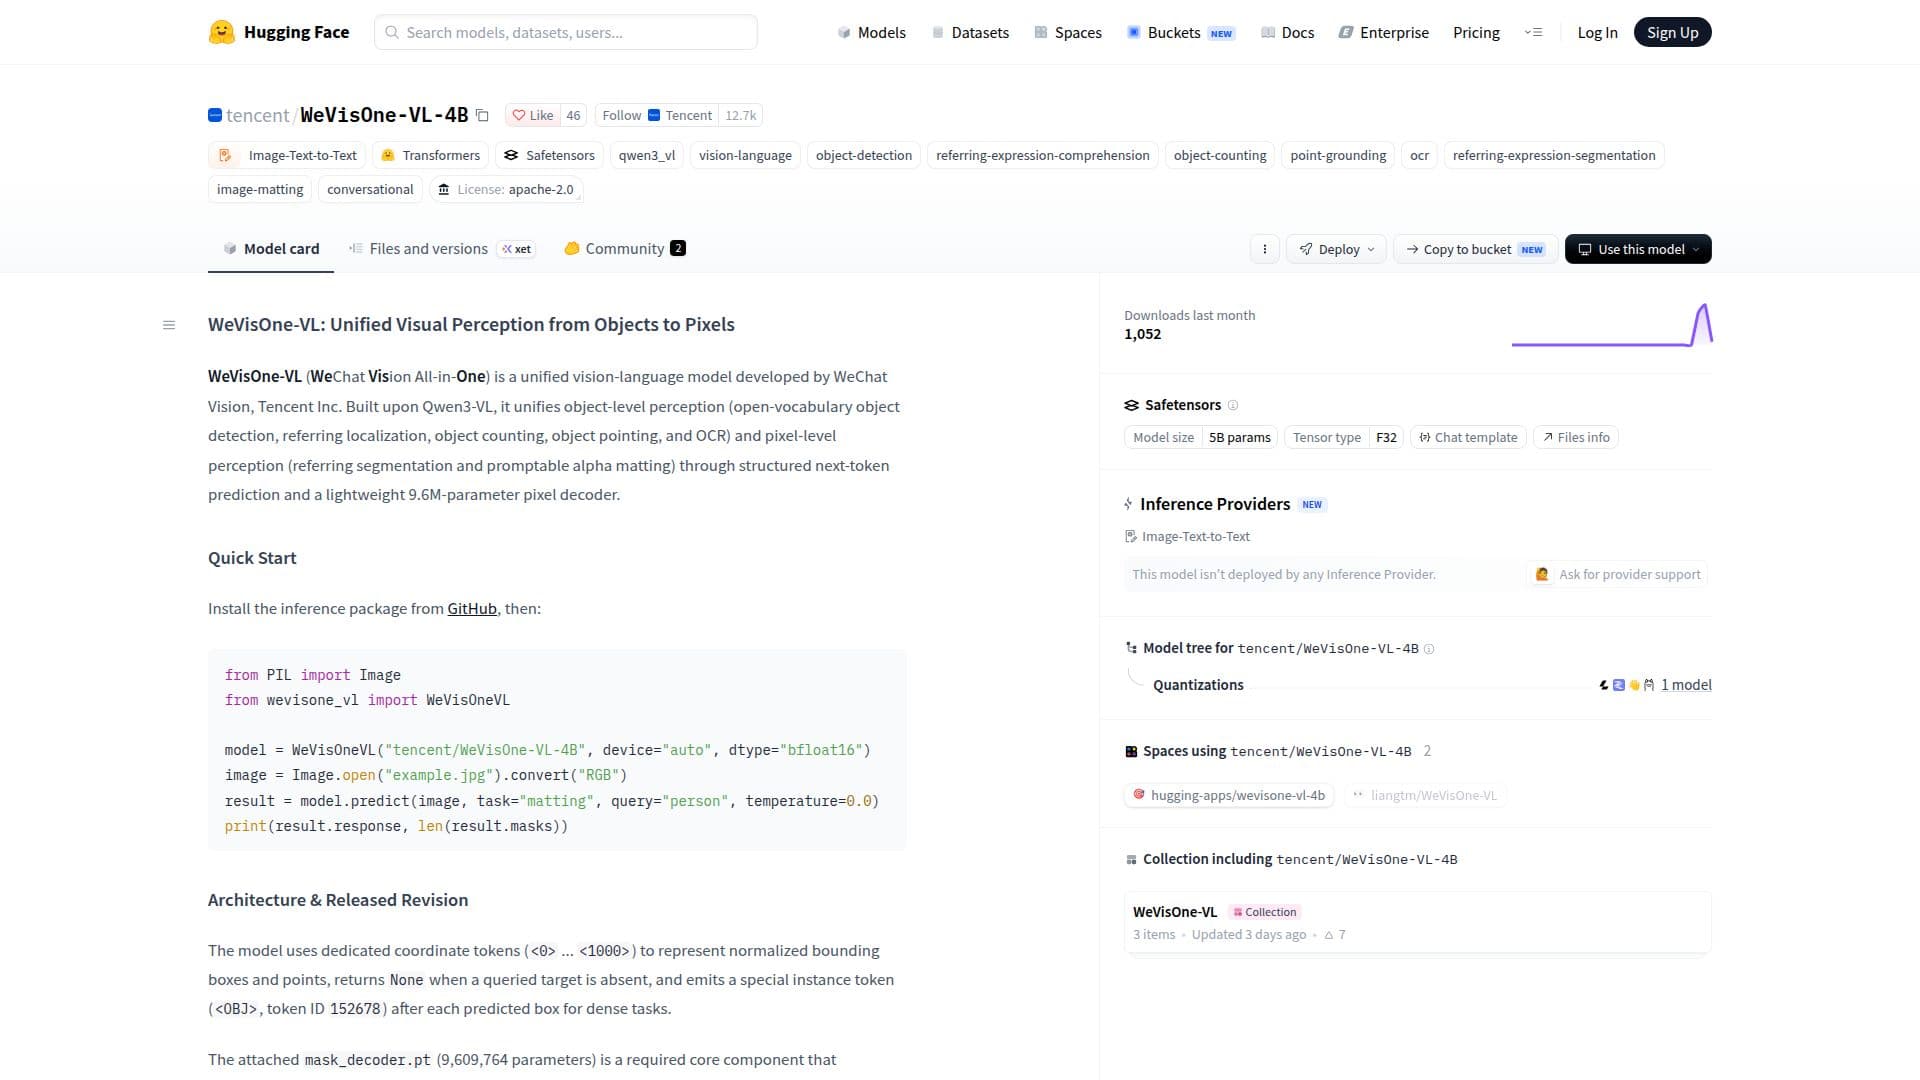
Capture d’écran de WeVisOne-VL

WeVisOne-VL est un modèle de vision-langage développé par WeChat Vision, une division de Tencent Inc. Il est conçu pour unifier les tâches de perception au niveau des objets et des pixels. Basé sur le cadre Qwen3-VL, WeVisOne-VL prend en charge une gamme de tâches visuelles, y compris la détection d'objets à vocabulaire ouvert, la localisation référentielle, le comptage d'objets, le pointage d'objets et la reconnaissance optique de caractères (OCR).

Lire la suite

De plus, il gère des tâches au niveau des pixels telles que la segmentation référentielle et le matting alpha promptable. Le modèle utilise une prédiction structurée du prochain jeton et dispose d'un décodeur de pixels léger de 9,6 millions de paramètres.

L'architecture de WeVisOne-VL comprend des jetons de coordonnées dédiés pour représenter des boîtes englobantes normalisées et des points. Il utilise un jeton d'instance spécial pour les tâches denses et intègre un décodeur de masques comme composant central. Ce décodeur combine un Adaptateur de Caractéristiques Visuelles, un Décodeur de Requêtes Guidées par Boîte et une Tête de Prédiction Dense Conditionnée par Instance pour affiner les prédictions et produire des alpha mattes en pleine résolution.

WeVisOne-VL est destiné à des fins de recherche dans le domaine de l'ancrage visuel, de la localisation référentielle, du pointage, du comptage, de la localisation OCR, de la segmentation référentielle et du matting d'images. Il n'est pas conçu pour la prise de décision autonome à fort impact ou l'identification individuelle. Le modèle est efficace pour générer des sorties structurées mais ne prend pas en charge le raisonnement explicite en chaîne et est actuellement limité à la perception d'images en un seul tour.

Le modèle est publié sous la licence Apache 2.0, avec des composants tiers conservant leurs licences d'origine. Il a été téléchargé plus de 1 000 fois au cours du dernier mois, ce qui indique sa popularité croissante dans la communauté de recherche.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireGratuit
  • DéploiementCloud
  • PlateformesWeb

  • Modèle unifié de vision-langage

  • Perception au niveau des objets

  • Perception au niveau des pixels

  • Décodeur de pixels de 9,6 millions de paramètres

  • Prédiction structurée du prochain jeton

  • Jetons de coordonnées dédiés

  • Jeton d'instance spécial pour les tâches denses

  • Licence Apache 2.0

  1. Accéder à la page du modèle : Visitez la page Hugging Face pour WeVisOne-VL

  2. Authentifier : Assurez-vous d'avoir les autorisations nécessaires pour accéder au modèle

  3. Configurer : Configurez les paramètres du modèle selon vos besoins de recherche

  4. Envoyer des invites : Saisissez vos tâches visuelles pour traitement

  5. Affiner : Ajustez le modèle pour des tâches spécifiques si nécessaire

  • Détection d'Objets
  • Localisation Référentielle
  • Comptage d'Objets
  • Localisation OCR
  • Matting d'Images

Outils IA populaires comme WeVisOne-VL

WeVisOne-VL est un modèle unifié de vision-langage développé par WeChat Vision, Tencent Inc. Il intègre la perception au niveau des objets et au niveau des pixels pour des tâches…

Outils de vision par ordinateur
Voir l'outil

Modèle unifié de vision-langage développé par WeChat Vision, Tencent Inc. Il intègre la perception au niveau des objets et au niveau des pixels pour des tâches…WeVisOne-VL est un modèle unifié de vision-langage développé par WeChat Vision, Tencent Inc. Il intègre la perception au niveau des objets et au niveau des pixels pour des tâches…

Outils de vision par ordinateur
Voir le Top 50 LLM

Qwen2-VL-7B-Instruct est un modèle d'IA avancé conçu pour la compréhension visuelle et le support multilingue. Il excelle dans le traitement des images et des vidéos, offrant des…

Outils de vision par ordinateur
Voir l'outil

Modèle d'IA avancé conçu pour la compréhension visuelle et le support multilingue. Il excelle dans le traitement des images et des vidéos, offrant des…Qwen2-VL-7B-Instruct est un modèle d'IA avancé conçu pour la compréhension visuelle et le support multilingue. Il excelle dans le traitement des images et des vidéos, offrant des…

Outils de vision par ordinateur
Voir le Top 5 Modèles IA

Qwen-VL

Dépôts GitHub d'IA

Qwen-VL est un grand modèle de langage visuel développé par Alibaba Cloud. Il offre des capacités avancées pour les tâches de chat et de vision, fournissant une plateforme robuste…

Modèles d'IA et LLM
Voir l'outil

Dépôts GitHub d'IA

Grand modèle de langage visuel développé par Alibaba Cloud. Il offre des capacités avancées pour les tâches de chat et de vision, fournissant une plateforme robuste…Qwen-VL est un grand modèle de langage visuel développé par Alibaba Cloud. Il offre des capacités avancées pour les tâches de chat et de vision, fournissant une plateforme robuste…

Modèles d'IA et LLM
Voir le Top 250 Dépôts GitHub d'IA

Qwen2-VL-72B-Instruct est un modèle d'IA avancé conçu pour une compréhension visuelle de pointe et un support multilingue. Il excelle dans le traitement d'images, de vidéos et de…

Modèles d'IA et LLM
Voir l'outil

Modèle d'IA avancé conçu pour une compréhension visuelle de pointe et un support multilingue. Il excelle dans le traitement d'images, de vidéos et de…Qwen2-VL-72B-Instruct est un modèle d'IA avancé conçu pour une compréhension visuelle de pointe et un support multilingue. Il excelle dans le traitement d'images, de vidéos et de…

Modèles d'IA et LLM
Voir le Top 5 Modèles IA

Ultralytics YOLO

Dépôts GitHub d'IA

Ultralytics YOLO comprend YOLO26, YOLO11 et YOLOv8, offrant des capacités de détection d'objets, de segmentation d'instances, de segmentation sémantique, de classification…

Outils de vision par ordinateur

N°19 en Dépôts GitHub d'IA

Voir l'outil

Dépôts GitHub d'IA

Ultralytics YOLO comprend YOLO26, YOLO11 et YOLOv8, offrant des capacités de détection d'objets, de segmentation d'instances, de segmentation sémantique, de classification…

En vedetteOutils de vision par ordinateur
N°19 en Dépôts GitHub d'IA

CLIP ViT-B/32

Modèles IA

Le modèle clip-vit-base-patch32 d'OpenAI est conçu pour des tâches de classification d'images en zéro-shot. Il utilise une architecture de Vision Transformer pour améliorer la…

Outils de vision par ordinateur
Voir l'outil

Modèles IA

Le modèle clip-vit-base-patch32 d'OpenAI est conçu pour des tâches de classification d'images en zéro-shot. Il utilise une architecture de Vision Transformer pour améliorer la…

En vedetteOutils de vision par ordinateur
Voir le Top 5 Modèles IA

Ultralytics

Applications IA

Une plateforme de vision par ordinateur de bout en bout pour annoter des données, entraîner des modèles YOLO et les déployer à l'échelle mondiale, construite autour du cadre…

Outils de vision par ordinateurFabrication et industrie

N°5 en Fabrication et industrie

Voir l'outil

Applications IA

Une plateforme de vision par ordinateur de bout en bout pour annoter des données, entraîner des modèles YOLO et les déployer à l'échelle mondiale, construite autour du cadre…

En vedetteOutils de vision par ordinateurFabrication et industrie
N°5 en Fabrication et industrie
1 sur 8